目录
[2.1 分页分析](#2.1 分页分析)
[2.2 编码](#2.2 编码)
一、环境准备
安装requests和lxml
python
pip install requests
pip install lxml
二、编写代码
2.1 分页分析
编写代码前我们先看看榜单的url

我们假如要爬取五页的数据,那么五个url分别是:
https://movie.douban.com/top250?start=0\&filter=
https://movie.douban.com/top250?start=25\&filter=
https://movie.douban.com/top250?start=50\&filter=
https://movie.douban.com/top250?start=75\&filter=
https://movie.douban.com/top250?start=100\&filter=
不难看出,规律在于start参数,每页有25条数据。
那么按照分页计算公式**(当前页数 - 1) * 每页数据量** 得出 代码逻辑。
2.2 编码
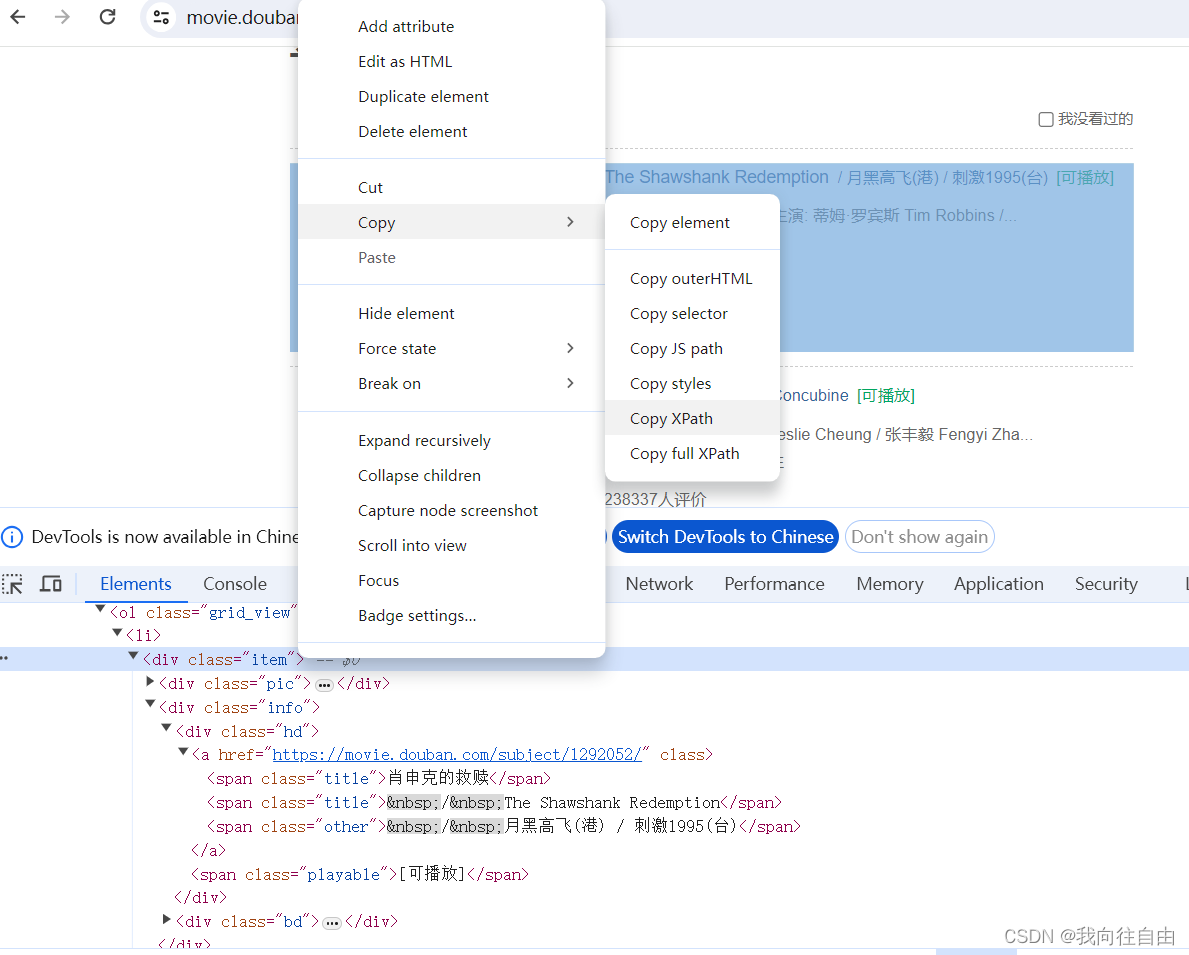
我们复制下xpath。
python
import random
from lxml import etree
import requests
import time

# 请求头信息
headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/102.0.0.0 Safari/537.36'
}
# 共取5页数据
for i in range(1, 6):
    start = (i - 1) * 25
    url = f'https://movie.douban.com/top250?start={start}&filter='
    response = requests.get(url, headers=headers)
    tree = etree.HTML(response.text)
    div = tree.xpath('//*[@id="content"]/div/div[1]/ol/li/div')
    for d in div:
        # 获取当前电影标题
        title = d.xpath('.//span[@class="title"][1]/text()')[0]
        print(title)
    time.sleep(random.randint(1, 3))
成功爬取豆瓣电影TOP250榜单。