
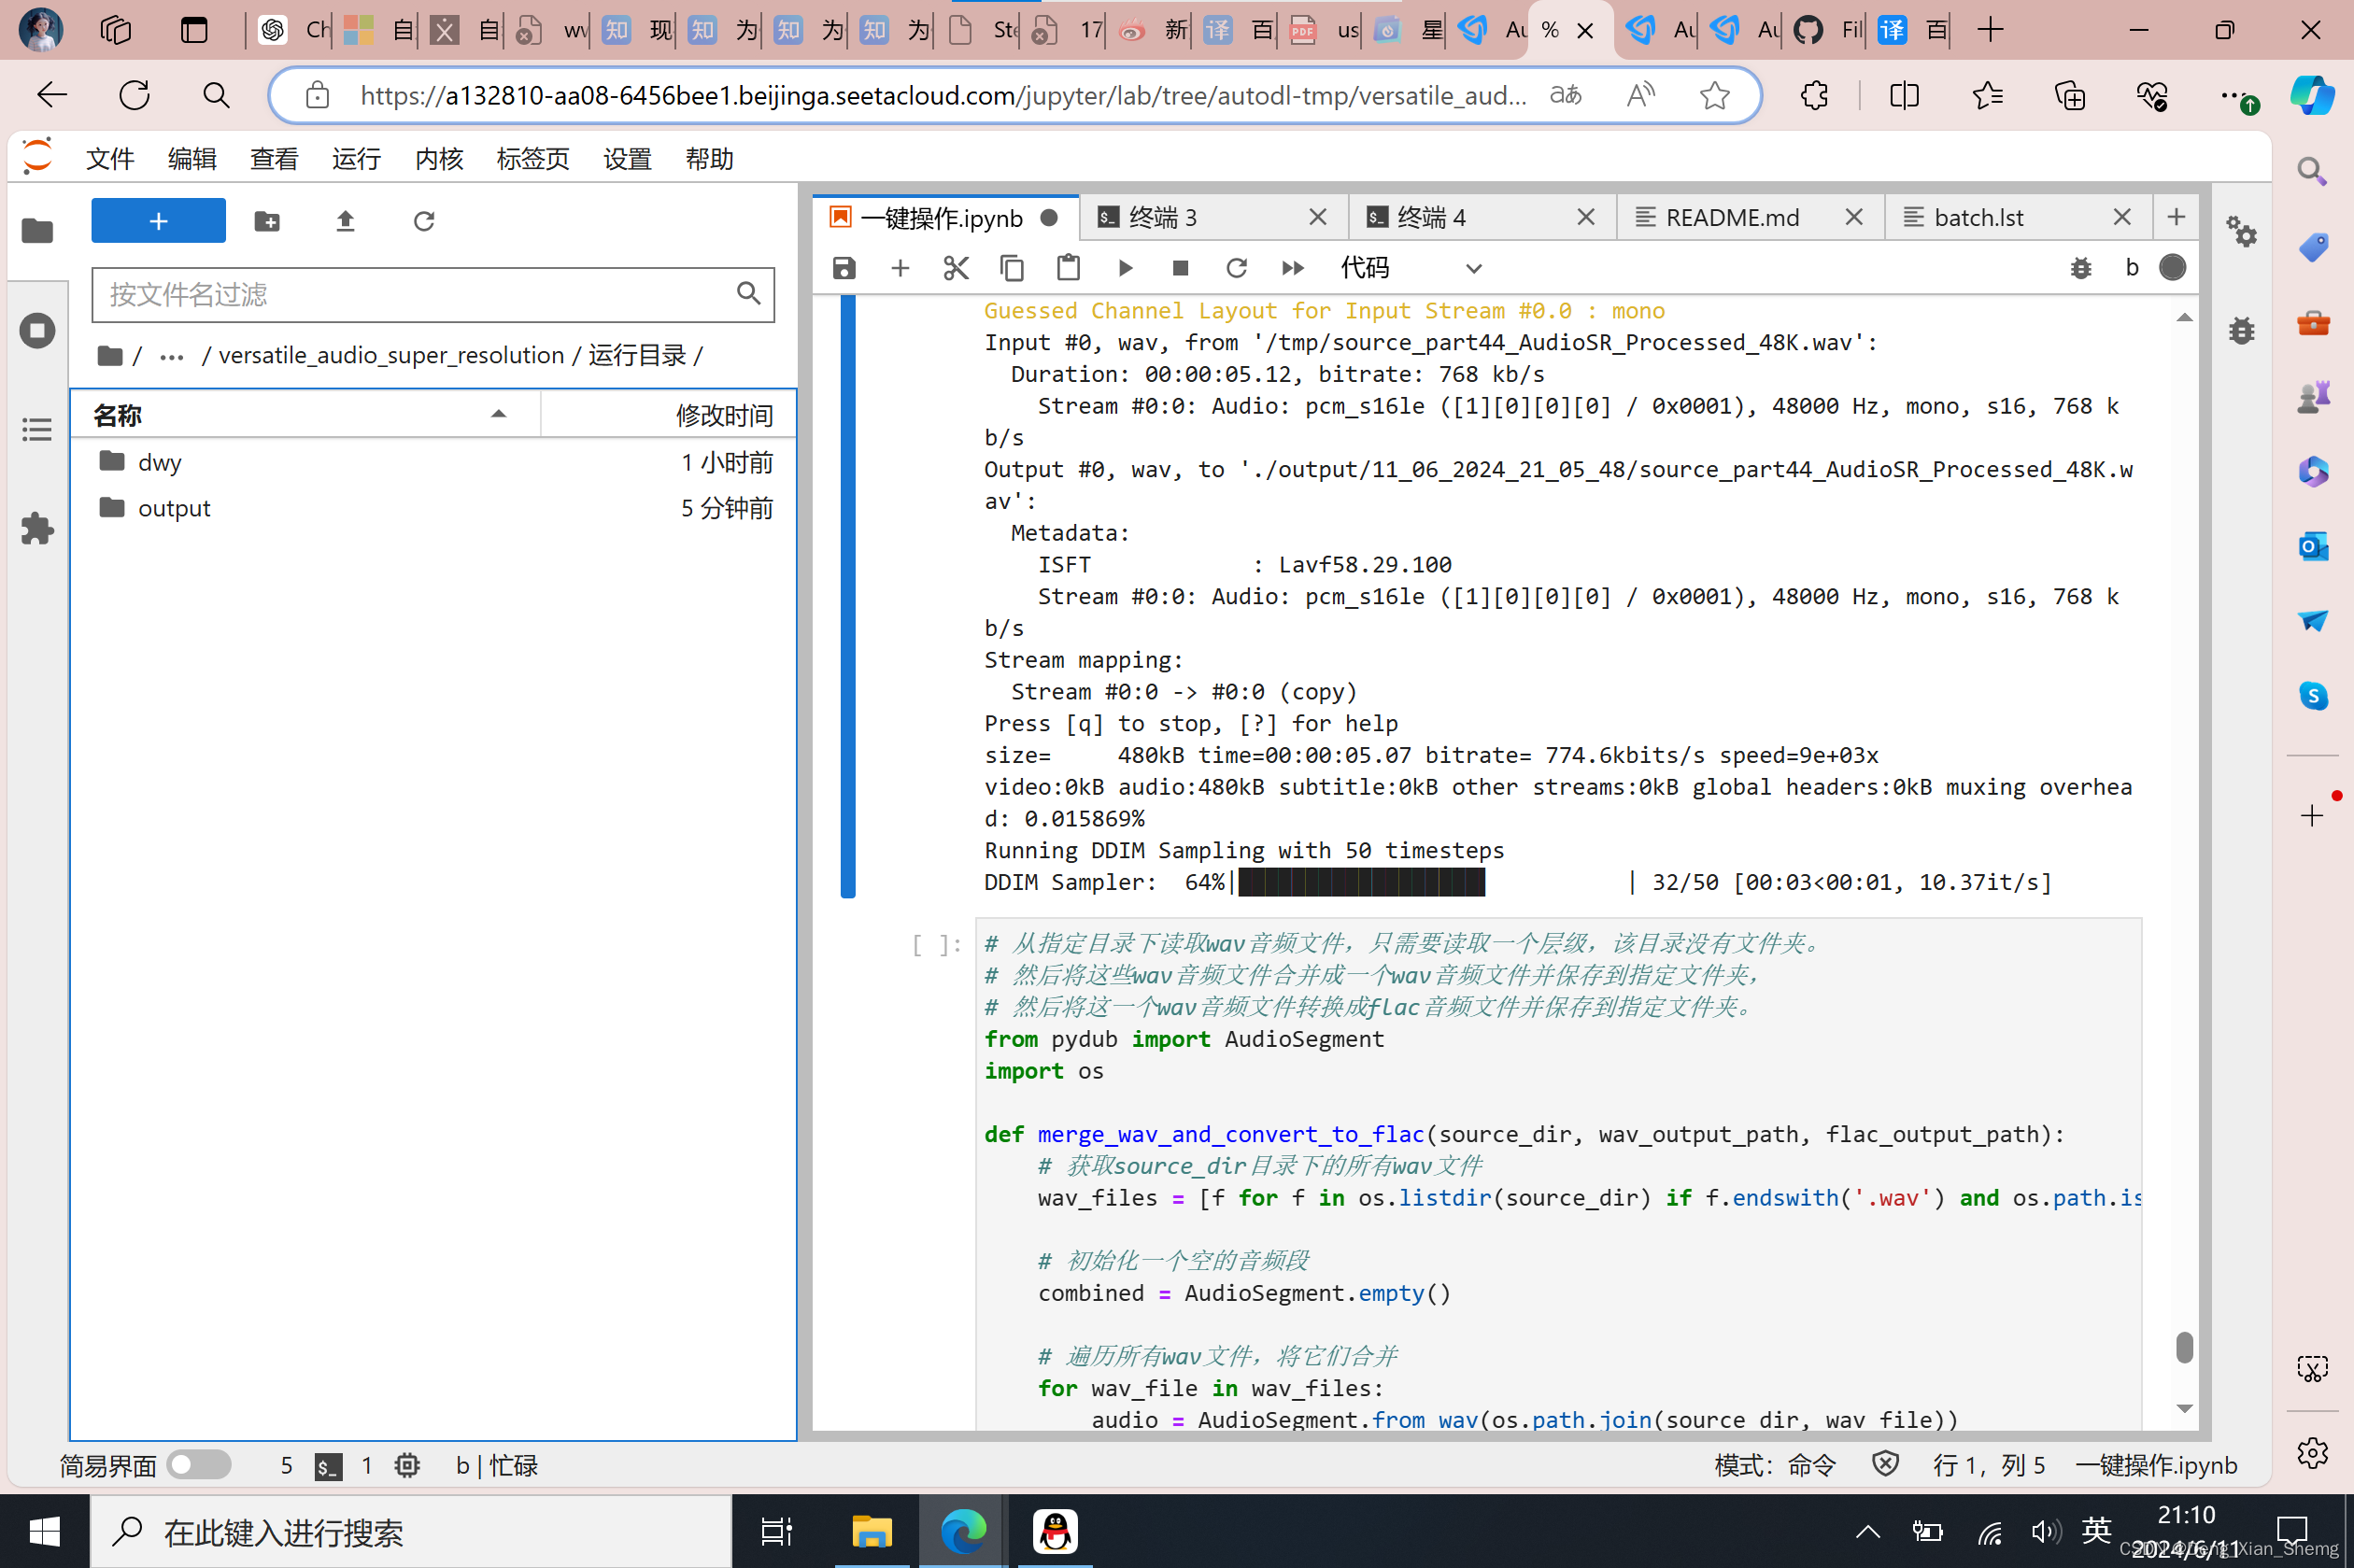
已部署在AutoDL上https://www.codewithgpu.com/i/haoheliu/versatile_audio_super_resolution/versatile_audio_super_resolution
ipynb:
音乐 By 邓文怡 一个深圳的小姑娘

%cd /root/versatile_audio_super_resolution/运行目录

# 读取一个mp3音频文件,然后将它转换成wav格式,
# 然后每5.12秒分割为一个wav音频文件并保存到一个目录,
# 然后将文件相对路径输出到txt文件。

from pydub import AudioSegment
import os

def convert_and_split_mp3_to_wav(source_mp3, target_dir, split_interval=5120):
    # 确保目标目录存在
    os.makedirs(target_dir, exist_ok=True)

    # 读取并转换MP3到WAV
    audio = AudioSegment.from_mp3(source_mp3)
    base_filename = os.path.splitext(os.path.basename(source_mp3))[0]

    # 分割音频
    total_length = len(audio)
    splits = range(0, total_length, split_interval)
    split_files = []

    for i, start in enumerate(splits):
        end = start + split_interval
        split_audio = audio[start:end]
        split_filename = f"{base_filename}_part{i}.wav"
        split_path = os.path.join(target_dir, split_filename)
        split_audio.export(split_path, format="wav")
        split_files.append(split_path)

    # 将分割后的文件路径写入TXT文件
    with open(os.path.join(target_dir, f"{base_filename}_splits.txt"), "w") as f:
        for file in split_files:
            f.write(f"{file}\n")

# 示例用法
source_mp3 = "dwy/source.mp3"
target_dir = "dwy/splits"
convert_and_split_mp3_to_wav(source_mp3, target_dir)

!audiosr -il dwy/splits/source_splits.txt

# 从指定目录下读取wav音频文件,只需要读取一个层级,该目录没有文件夹。
# 然后将这些wav音频文件合并成一个wav音频文件并保存到指定文件夹,
# 然后将这一个wav音频文件转换成mp3音频文件并保存到指定文件夹。

from pydub import AudioSegment
import os

def merge_wav_and_convert_to_mp3(source_dir, wav_output_path, mp3_output_path):
    # 获取source_dir目录下的所有wav文件
    wav_files = [f for f in os.listdir(source_dir) if f.endswith('.wav')]

    # 初始化一个空的音频段
    combined = AudioSegment.empty()

    # 遍历所有wav文件,将它们合并
    for wav_file in wav_files:
        audio = AudioSegment.from_wav(os.path.join(source_dir, wav_file))
        combined += audio

    # 保存合并后的wav文件
    combined.export(wav_output_path, format="wav")

    # 将合并后的wav文件转换为mp3并保存
    combined.export(mp3_output_path, format="mp3")

# 示例用法
source_dir = ""
wav_output_path = "dwy/output.wav"
mp3_output_path = "dwy/output.mp3"
merge_wav_and_convert_to_mp3(source_dir, wav_output_path, mp3_output_path)

---

?MP3
分割线
?FLAC

---

# 读取一个flac音频文件,然后将它转换成wav格式,
# 然后每5.12秒分割为一个wav音频文件并保存到一个目录,
# 然后将文件相对路径输出到txt文件。
from pydub import AudioSegment
import os

def convert_and_split_flac_to_wav(source_flac, target_dir, split_interval=5120):
    # 确保目标目录存在
    os.makedirs(target_dir, exist_ok=True)

    # 读取并转换FLAC到WAV
    audio = AudioSegment.from_file(source_flac, format="flac")
    base_filename = os.path.splitext(os.path.basename(source_flac))[0]

    # 分割音频
    total_length = len(audio)
    splits = range(0, total_length, split_interval)
    split_files = []

    for i, start in enumerate(splits):
        end = start + split_interval
        split_audio = audio[start:end]
        split_filename = f"{base_filename}_part{i}.wav"
        split_path = os.path.join(target_dir, split_filename)
        split_audio.export(split_path, format="wav")
        split_files.append(split_path)

    # 将分割后的文件路径写入TXT文件
    with open(os.path.join(target_dir, f"{base_filename}_splits.txt"), "w") as f:
        for file in split_files:
            f.write(f"{file}\n")

# 示例用法
source_flac = "dwy/source.flac"
target_dir = "dwy/splits"
convert_and_split_flac_to_wav(source_flac, target_dir)

!audiosr -il dwy/splits/source_splits.txt

# 从指定目录下读取wav音频文件,只需要读取一个层级,该目录没有文件夹。
# 然后将这些wav音频文件合并成一个wav音频文件并保存到指定文件夹,
# 然后将这一个wav音频文件转换成flac音频文件并保存到指定文件夹。
from pydub import AudioSegment
import os

def merge_wav_and_convert_to_flac(source_dir, wav_output_path, flac_output_path):
    # 获取source_dir目录下的所有wav文件
    wav_files = [f for f in os.listdir(source_dir) if f.endswith('.wav') and os.path.isfile(os.path.join(source_dir, f))]

    # 初始化一个空的音频段
    combined = AudioSegment.empty()

    # 遍历所有wav文件,将它们合并
    for wav_file in wav_files:
        audio = AudioSegment.from_wav(os.path.join(source_dir, wav_file))
        combined += audio

    # 保存合并后的wav文件
    combined.export(wav_output_path, format="wav")

    # 将合并后的wav文件转换为flac并保存
    combined.export(flac_output_path, format="flac")

# 示例用法
source_dir = "output/11_06_2024_21_05_48"
wav_output_path = "dwy/output.wav"
flac_output_path = "dwy/output.flac"
merge_wav_and_convert_to_flac(source_dir, wav_output_path, flac_output_path)

作者:likewendy
链接:https://www.codewithgpu.com/i/haoheliu/versatile_audio_super_resolution/versatile_audio_super_resolution
来源:CodeWithGpu
著作权归作者所有。商业转载请联系作者获得授权,非商业转载请注明出处。