【数据挖掘-思考】分类和聚类

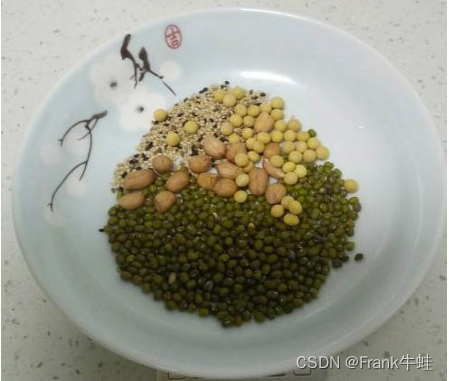
将芝麻和花生分开,是一个分类问题还是聚类问题?

显而易见的,在日常生活中,这是一个分类问题,在数据挖掘领域中,是否也是这样呢?


通义千问的回答:

在数据挖掘中,将芝麻和花生分开可以根据不同的场景被视为分类或聚类问题:

  • 分类 (Classification): 如果我们已经有了一套标注好的数据集,即一部分芝麻已经被标记为"芝麻",一部分绿豆被标记为"绿豆",并且我们的目标是基于这些已知的样本特征来训练一个模型,以便对新的未标记物品进行预测(判断它是芝麻还是绿豆),那么这个问题就是一个分类问题。
  • 聚类 (Clustering): 如果我们没有预先标记的数据,而是有一堆混在一起的种子,我们希望通过分析种子的大小、颜色、形状等属性,将它们自动分成几组,并且假设这些组能合理地对应到芝麻和绿豆这两类,那么这就是一个聚类问题。聚类旨在根据对象之间的相似性或距离,将它们分组成多个簇,每簇内部的对象相似度较高,而簇间相似度较低。
  • 因此,决定这是分类还是聚类问题的关键在于是否有预定义的类别标签。如果有标签,就是分类;如果没有,而是需要自动发现类别,那就是聚类。

这样学术性的回答好复杂>﹏<

我的老师教给我的:
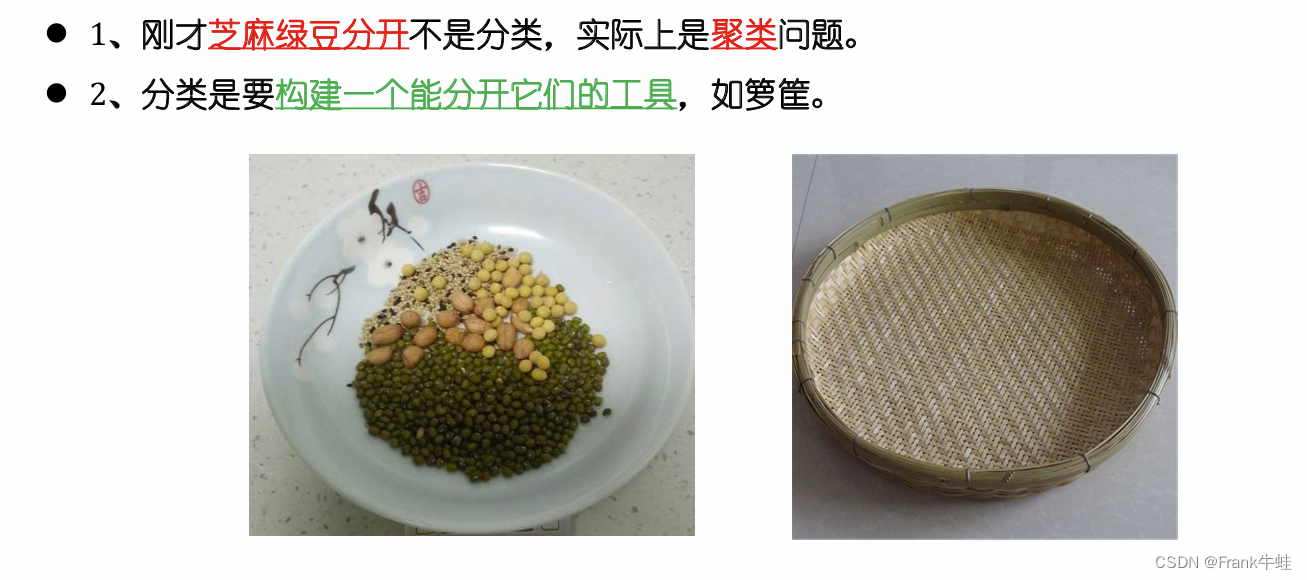
也就是说,需要训练数据,构建模型的问题是分类问题,很显然这里没有用到,所以是聚类问题。聚类问题关键在于根据某种标准将相似度高的对象分到一起。

你能理解吗?


点赞关注收藏,获取更多干货知识~

相关推荐
CS创新实验室18 小时前
没有标签的数据,怎么“自动分成几堆“?——K-means 聚类的原理与坑
人工智能·kmeans·聚类
夏天的清晨18 小时前
聚类与2-OPT
人工智能·机器学习·聚类
Raymond168819 小时前
零样本TTS长视频配音的工程取舍:自回归、非自回归与韵律边界
人工智能·数据挖掘·回归·音视频·音频
sbjdhjd1 天前
从污点追踪断点到 PHP-FPM 请求队列:HIDS PHP WebShell 样本复盘
开发语言·网络安全·数据挖掘·渗透测试·开源·php·shell
kaixin_啊啊2 天前
【零基础学AI】第 19 章——用分类模型识别类别
人工智能·分类·数据挖掘
隔窗听雨眠2 天前
从取数到行动:数据分析失效的链路拆解与闭环重建
大数据·数据挖掘·数据分析
四季豆333 天前
AI时代中小企业如何低成本提升数据和知识质量?
大数据·人工智能·数据挖掘
admin and root3 天前
《神农安全.AI漏洞挖掘src赏金》单独开放!
安全·web安全·网络安全·数据挖掘·渗透测试·ai安全·白帽子黑客
a puppy slide 葱3 天前
arXiv _ 2025 _ Gaussian Masked Autoencoders
论文阅读·人工智能·python·分类