-
Batch Normalization 可以
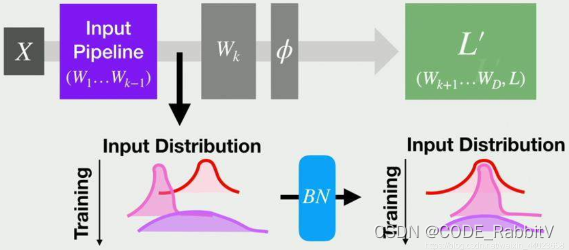
改善梯度消失/爆炸问题:前面层的梯度经过多次传递后会变得非常小(大),从而导致网络收敛速度慢(不收敛),应用 BN 可缓解加速网络收敛:BN 使得每个神经元的输入分布更加稳定减少过拟合:BN 可减少由于数据分布的变化导致的模型性能下降提高模型泛化能力:BN 使得模型对输入的微小变化更加稳定缓解超参敏感:对于 learning rate 等超参数敏感性降低- ...
-
Batch Normalization(BN):使 feature map 满足均值为 0,方差为 1 的分布规律
- 如果batch size为m,则在前向传播过程中,网络中每个节点都有m个输出,所谓的Batch Normalization,就是对该层每个节点的这m个输出进行归一化再输出
- 数学表达:每个 channel 下统计一个对应的均值和方差
x norm = x − E x V a r x + ϵ ∗ γ + β x_{\text{norm}} = \frac{x - \mathbb{E}x}{\sqrt{Varx+\epsilon}} * \gamma + \beta xnorm=Varx+ϵ x−Ex∗γ+β- 其中 γ , β \gamma, \beta γ,β 为可学习的参数
-
代码实践:
python3>>> import torch >>> import torch.nn as nn >>> >>> x = torch.rand(2,1,28,28) ## *0.创建输入 x >>> bn = nn.BatchNorm2d( ## *1. 创建 bn 层, 1, # -- 输入的 channel 数 training = False, # -- 是否为训练模式 affine = False) # -- 是否学习 γ β >>> out = bn(x) ## *2 获取输出 >>> # 查看相关数值 ------------------------------------------------ >>> bn.running_mean # 均值 tensor([0.0507]) >>> bn.running_var # 方差 tensor([0.9080]) >>> bn.weight # γ Parameter containing: tensor([1.], requires_grad=True) >>> bn.bias # β Parameter containing: tensor([0.], requires_grad=True)
PyTorch -- Batch Normalization(BN) 快速实践
CODE_RabbitV2024-06-16 5:05
相关推荐
泯泷27 分钟前
Multica 真正打动我的,不是更多 Agent,而是一种新的团队协作方式电科_银尘28 分钟前
【深度学习项目实战·22】灰度图像着色:用小型U-Net学习从灰度到RGB阿里云大数据AI技术36 分钟前
云栖实录|倍思科技 × 阿里云:让VOC洞察从“生成报告”走向“业务可用”AllData公司负责人1 小时前
第九篇:AI大模型数据开发底座系列说明书:AllData集成BISHENG开源项目建设大模型应用开发底座,涵盖可视化编排/智能助手/一键API/模型接入!数字新视界1 小时前
数据中心DCIM管理系统助力提升机房管理效率与安全性阿里云大数据AI技术1 小时前
阿里云 EMR Serverless StarRocks(Stella)× Paimon:让多模态数据湖从“存得下”走向“找得到、用得上”class心平气和2 小时前
AI 赋能测试流程:从基础概念到测试全流程实战猿人谷2 小时前
遗传编程的未来:从进化搜索到自主发现求解方法字节跳动开源2 小时前
OpenViking 3D理解模型上线轴测八视图及PMI解析阿里云大数据AI技术2 小时前
孩子王基于阿里云Data Agent的智能体实践:300+Agent 覆盖400+业务场景