1.新建Scala项目
具体教程可见在idea中创建Scala项目教程-CSDN博客
1.1右键项目名-添加框架支持-勾选scala
1.2main目录下新建scala目录-右键Scala目录-将目录标记为-勾选源代码根目录
1.3创建包com.ljr.spark
1.4引入依赖(pox.xml)
bash
<dependencies>
        <dependency>
            <groupId>org.apache.spark</groupId>
            <artifactId>spark-streaming-kafka-0-10_2.12</artifactId>
            <version>3.0.0</version>
        </dependency>
           <groupId>org.apache.spark</groupId>
            <artifactId>spark-core_2.12</artifactId>
            <version>3.0.0</version>
        </dependency>
        <dependency>
            <groupId>org.apache.spark</groupId>
            <artifactId>spark-streaming_2.12</artifactId>
            <version>3.0.0</version>
        </dependency>
    </dependencies>
1.5把spark conf/目录下的log4j.properties 复制到项目的resources目录
2.集成spark生产者
新建SparkKafkaProducer (注意选择的是object而不是class)
Scala
package com.ljr.spark
import org.apache.kafka.clients.producer.{KafkaProducer, ProducerConfig, ProducerRecord}
import org.apache.kafka.common.serialization.StringSerializer

import java.util.Properties

object SparkKafkaProducer {

  def main(args: Array[String]): Unit = {
    //1 属性配置
    val pros = new Properties()
    pros.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG,"node1:9092,node2:9092")
    pros.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG,classOf[StringSerializer])
    pros.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG,classOf[StringSerializer])

    //2 创建生产者
    val producer = new KafkaProducer[String, String](pros)

    //3 发送数据
    for (i <- 1 to 5) {
      producer.send(new ProducerRecord[String,String]("customers","Lili" + i))
    }
    //4 关闭资源
    producer.close()
  }
}
运行,开启Kafka 消费者消费数据
kafka-console-consumer.sh --bootstrap-server node1:9092 --topic customers

能接收到信息,可见spark作为生产者集成Kafka成功
3.集成spark消费者
bash
package com.ljr.spark

import org.apache.kafka.clients.consumer.ConsumerConfig
import org.apache.kafka.common.serialization.StringDeserializer
import org.apache.spark.SparkConf
import org.apache.spark.streaming.kafka010.{ConsumerStrategies, KafkaUtils, LocationStrategies}
import org.apache.spark.streaming.{Seconds, StreamingContext}


object SparkKafkaConsumer {
      def main(args: Array[String]): Unit = {
       //1 初始化上下文环境
       val conf = new SparkConf().setMaster("local[*]").setAppName("spark-kafka")
        val sc = new StreamingContext(conf, Seconds(3))

        //2 消费数据
        val kafkapara = Map[String, Object](
          ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG->"node1:9092,node2:9092",
          ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG->classOf[StringDeserializer],
          ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG->classOf[StringDeserializer],
          ConsumerConfig.GROUP_ID_CONFIG->"KFK-SP"
        )
        val kafkaDstream = KafkaUtils.createDirectStream(sc, LocationStrategies.PreferConsistent, ConsumerStrategies.Subscribe[String, String](Set("customers"), kafkapara))
        val valueDstream = kafkaDstream.map(record => record.value())
        valueDstream.print()
        //3 执行代码并阻塞
          sc.start()
        sc.awaitTermination()

      }
}
运行,
开启Kafka 生产者生产数据
kafka-console-producer.sh.sh --bootstrap-server node1:9092 --topic customers
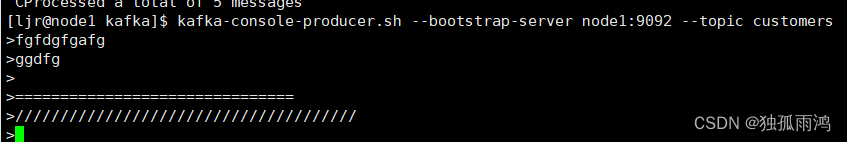
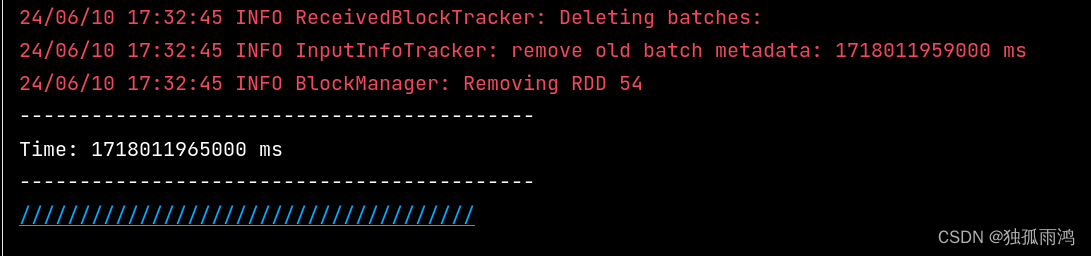
控制台可以消费到数据,可见spark作为消费者集成Kafka成功。