Spark运行spark-shell与hive运行时均报错的一种解决方案

环境按照尚硅谷的配置的。

在运行hive的时候,报错代码为30041,无法执行insert语句。

在运行spark-shell的时候,报错,无法进入到shell脚本中。

可能的问题:

对集群设置的域名与集群的主机名称不一致。

例如:

我的集群的域名为hadoopxx,但是我的集群的主机名均为ubuntu,导致集群中Node Address均为ubuntu:8042。

解决方案:

将集群的主机名称修改为与集群的域名相匹配的名称。
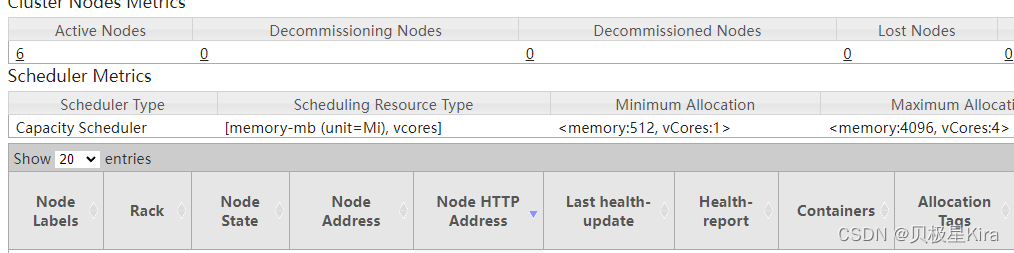
此图片需要在ResourceManager的IP的8088端口才能看见。

相关推荐
数字新视界8 小时前
信创动环监控在机房环境管理中的智能化应用与实践分析
大数据·人工智能·物联网·信息与通信·动环监控系统
大大大大晴天12 小时前
数仓分层架构设计:ODS、DWD、DWS、ADS、DIM 如何各司其职
大数据
东鸿电子Eastron19 小时前
工厂节能降本落地指南:从精准能源计量搭建数字化管理基础
大数据·人工智能·能源·智能电表·能耗管理
吾AI科技19 小时前
基于Tez引擎的 Hive SQL 性能优化 —— 为什么脚本运行越来越慢
大数据·hive·性能优化·tez
P1Browser1 天前
账号触发平台安全审核?拆解标准申诉流程与材料清单
大数据·人工智能·安全·多账号管理·指纹浏览器·账户安全·运营合规
云南新人和数采集团2 天前
云南靠谱软件开发公司选型指南:以昆明新腾科技为例
大数据·人工智能·科技
AllData公司负责人2 天前
AI大模型数据开发底座系列说明书:AllData集成DB-GPT开源项目建设 AI 多模态分析底座,涵盖模态解析/智能大屏/MCP 扩展!
大数据·数据库·人工智能·gpt·数据采集·数据接入·模态解析
Lansonli2 天前
大数据Spark(八十八):Spark任务资源之Standalone集群测试
java·服务器·spark
wno7042 天前
常用的Git命令清单
大数据·git·elasticsearch
YIN_尹3 天前
【git原理与使用】git基本操作及底层原理(二)
大数据·git·elasticsearch