一、题目
索引 task 索引中文档的 fielda 字段内容包括了 hello & world ,索引后,要求使用 match_phrase query 查询 hello & world 或者 hello and world 都能匹配该文档
1.1 考点
1.2 答案
rust
# 创建符合条件的 task 索引,设置 field 字段,并写入数据
PUT task
{
"settings": {
    "analysis": {
      "analyzer": {
        "my_analyzer": {
          "tokenizer": "standard",
          "char_filter": [
            "my_mappings_char_filter"
          ]
        }
      },
      "char_filter": {
        "my_mappings_char_filter": {
          "type": "mapping",
          "mappings": [
            "& => and"
          ]
        }
      }
    }
  },
  "mappings": {
    "properties": {
      "fielda":{
        "type": "text",
        "analyzer": "my_analyzer"
      }
    }
  }
}

# 写入数据
POST task/_bulk
{"index":{}}
{"fielda":"hello & world"}
{"index":{}}
{"fielda":"hello and world"}

# 验证结果
GET task/_search
{
  "query": {
    "match_phrase": {
      "fielda": "hello & world"
    }
  }
}
二、题目
有一个索引 task3,其中有 fielda,fieldb,fieldc,fielde 现要求对 task3 重建索引,重建后的索引新增一个字段 fieldg 其值是fielda,fieldb,fieldc,fielde 的值拼接而成。
rust
# 创建符合条件的 task3 索引,设置 field 字段,并写入数据
PUT task3
{
  "mappings": {
    "properties": {
      "fielda":{
        "type": "keyword"
      },
      "fieldb":{
        "type": "keyword"
      },
      "fieldc":{
        "type": "keyword"
      },
      "fielde":{
        "type": "keyword"
      }
    }
  }
}

POST task3/_bulk
{"index":{}}
{"fielda":"aa","fieldb":"bb","fieldc":"cc","fielde":"dd"}
{"index":{}}
{"fielda":"中华","fieldb":"人民","fieldc":"共和国","fielde":"万岁"}
2.1 考点
2.2 答案
rust
# 预览脚本结果
POST _ingest/pipeline/_simulate
{
  "pipeline": {
    "processors": [
      {
        "script": {
          "lang": "painless",
          "source": """
            ctx['fieldg'] = ctx['fielda'] + ' ' + ctx['fieldb'] + ' '+ctx['fieldc'] + ' ' + ctx['fielde'];
          """
        }
      }
    ]
  },
  "docs": [
    {
      "_source": {
        "fielda":"中华","fieldb":"人民","fieldc":"共和国","fielde":"万岁"
      }
    }
  ]
}

# 定义脚本
PUT _ingest/pipeline/my_pipeline
{
  "processors": [
    {
      "script": {
        "lang": "painless",
        "source": """
            ctx['fieldg'] = ctx['fielda'] + ' ' + ctx['fieldb'] + ' '+ctx['fieldc'] + ' ' + ctx['fielde'];
          """
      }
    }
  ]
}

# 重建索引
POST _reindex
{
  "source": {
    "index": "task3"
  },
  "dest": {
    "index": "task3_new",
    "pipeline": "my_pipeline"
  }
}

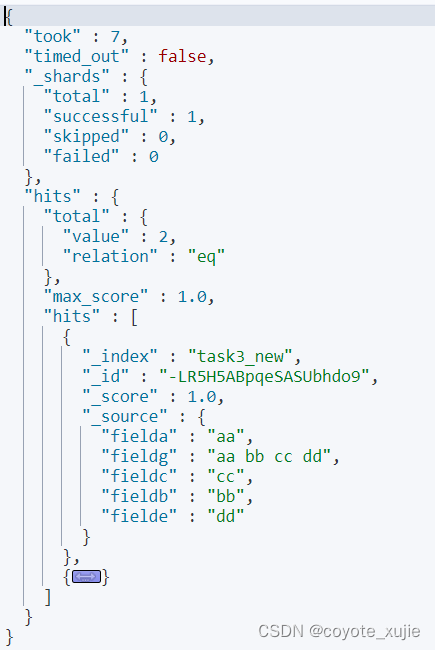
# 搜索结果
GET task3_new/_search