在单变量测试中,没有使用模型;在基于模型的选择中,使用单个模型来选择特征。而在迭代特征选择中,将会构造一系列模型,每个模型都使用不同数量的特征。有两种基本方法:
1、开始时没有特征,然后逐个添加特征,知道满足某个条件终止;
2、从所有特征开始,然后逐个删除特征,知道满足某个条件终止。
由于构造了一系列模型,所以这些方法的计算成本要比单变量统计和基于模型的特征选择要更高。其中一种特殊方法就是递归特征消除,它从所有特征开始构建模型,并根据模型舍弃最不重要的特征,然后使用除被舍弃特征之外的所有特征来构建一个新模型,如此继续,知道仅剩下预设数量的特征。为了让这种方法能够运行,用于选择的模型需要提供某种确定特征重要性的方法,正如基于模型的选择所做的那样。
下面使用一个随机森林模型:
python
select = RFE(RandomForestClassifier(n_estimators=100,random_state=42),n_features_to_select=40)
select.fit(X_train,y_train)
mask=select.get_support()

plt.matshow(mask.reshape(1,-1),cmap='gray_r')
plt.xlabel('Sample index')
plt.show()
与单变量选择和基于模型的特征选择相比,迭代特征选择的结果更好,但仍然露掉了一个特征。而且运行代码所需的时间也长得多,因为对一个随机森林模型训练了40次,每运行一次删除一个特征。
下面,测试一下使用RFE做特征选择时Logistic回归模型的精度
python
X_train_rfe=select.transform(X_train)
X_test_rfe=select.transform(X_test)
score=LogisticRegression().fit(X_train_rfe,y_train).score(X_test_rfe,y_test)
print(score)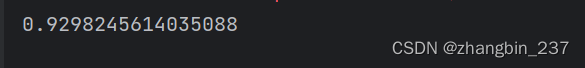
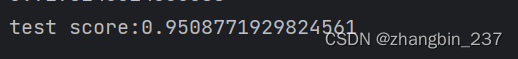
我们还可以利用在RFE内使用的模型来进行预测。这仅使用被选中的特征集:
python
print("test score:{}".format(select.score(X_test,y_test)))