前言
神经网络的训练主要使用反向传播算法,通过损失函数计算模型预测值与正确标签的差异,并进行反向传播计算梯度,最终更新模型参数。自动微分能够计算可导函数在某点处的导数值,是反向传播算法的一般化,主要解决了复杂数学运算的求导细节和过程,降低了框架的使用门槛。MindSpore使用函数式自动微分的设计理念,提供更接近于数学语义的自动微分接口 grad 和 value_and_grad。
函数与计算图
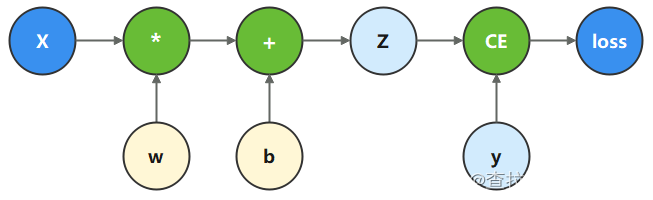
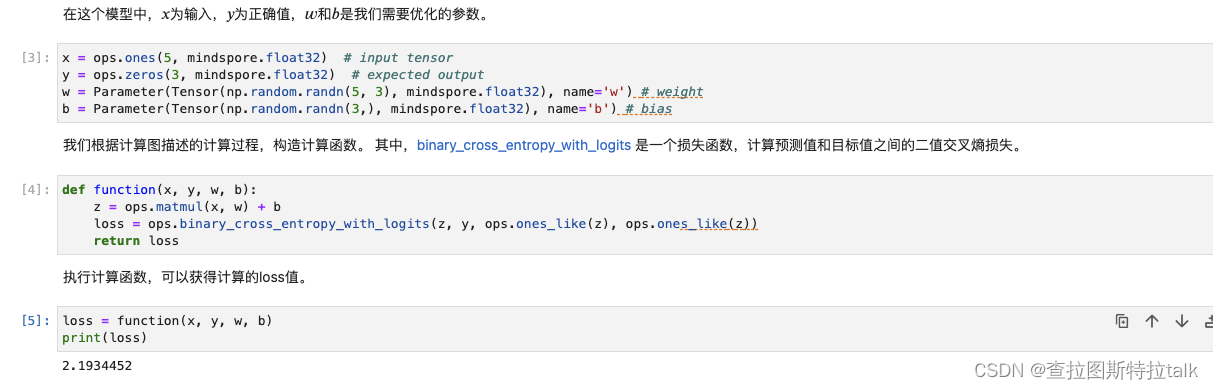
计算图是用图论语言表示数学函数的一种方式,也是深度学习框架表达神经网络模型的统一方法。我们将根据下面的计算图构造计算函数和神经网络。
微分函数与梯度计算
为了优化模型参数,需要求参数对loss的导数:
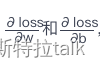
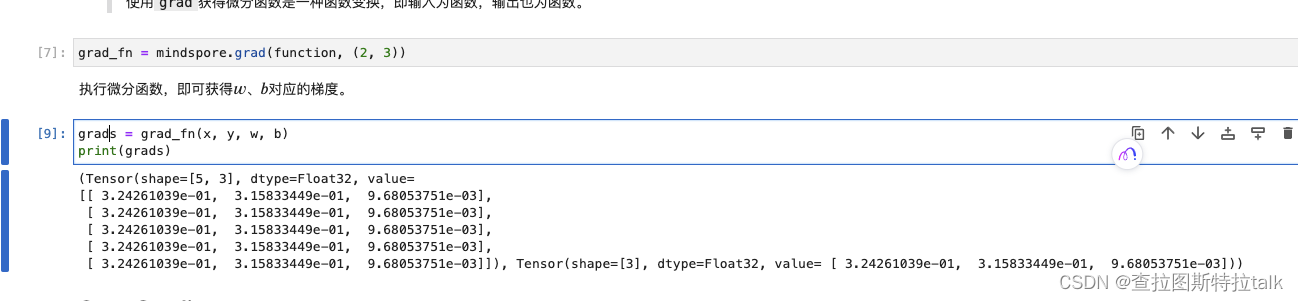
此时我们调用mindspore.grad函数,来获得function的微分函数。
这里使用了grad函数的两个入参,分别为:
fn:待求导的函数。grad_position:指定求导输入位置的索引。
Stop Gradient
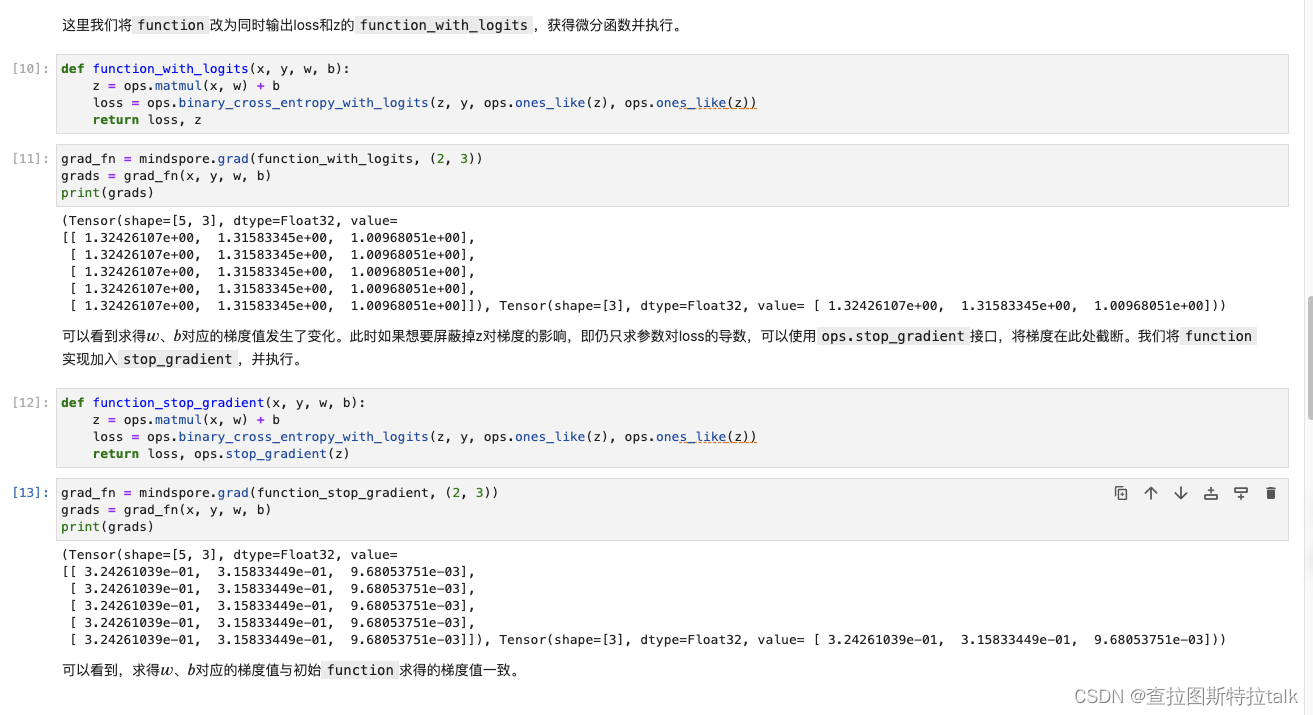
通常情况下,求导时会求loss对参数的导数,但有时我们希望函数输出多项,微分函数会求所有输出项对参数的导数。如果想要实现对某个输出项的梯度截断或消除某个Tensor对梯度的影响,需要用到Stop Gradient操作。通过将 function 改为同时输出loss和z的 function_with_logits,获得微分函数并执行。
Auxiliary data
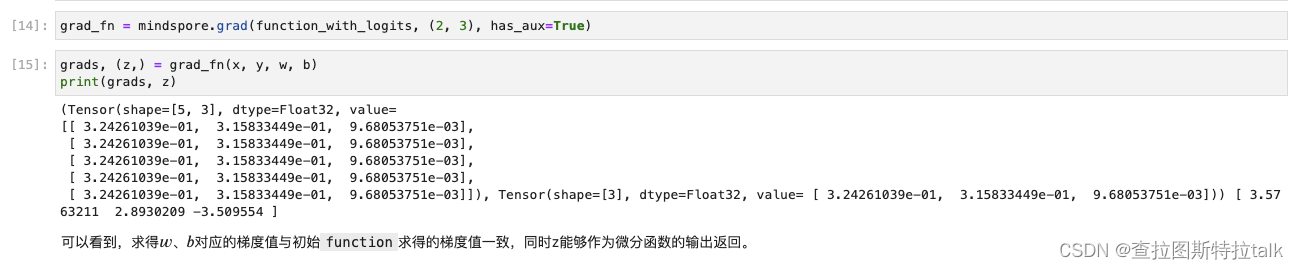
Auxiliary data是指函数除了第一个输出项外的其他输出,通常被用作辅助数据。在使用grad和value_and_grad函数时,设置has_aux参数为True可以自动实现添加stop_gradient的功能,从而在返回辅助数据的同时不影响梯度计算的效果。
神经网络梯度计算
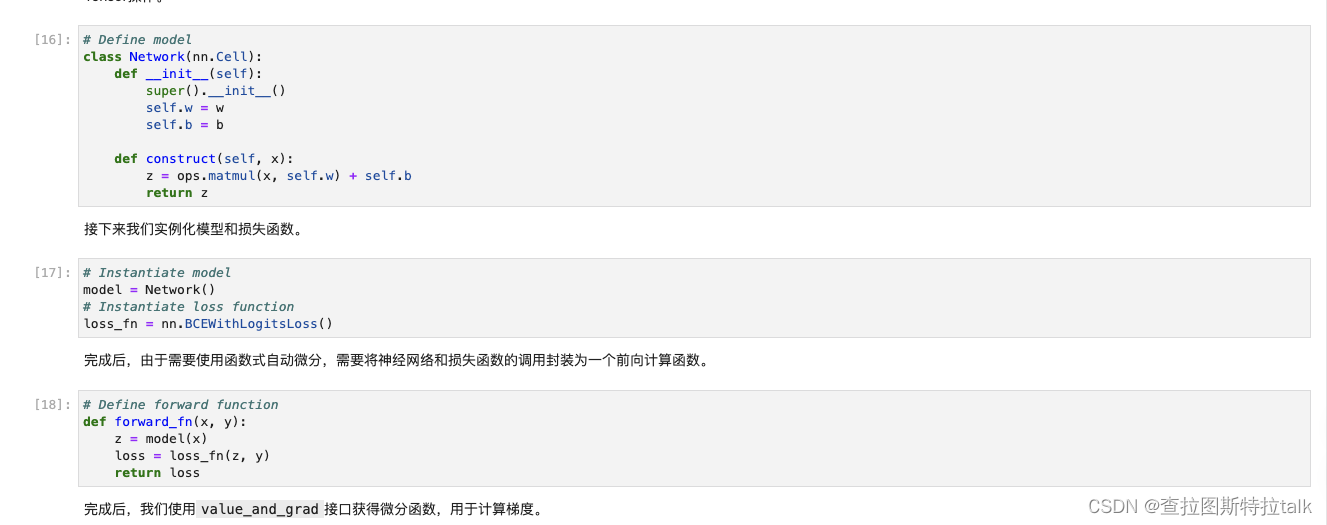
利用面向对象编程范式中的 nn.Cell 构造神经网络,并使用函数式自动微分来实现反向传播。首先继承 nn.Cell 构造单层线性变换神经网络,然后在 construct 内实现相同的Tensor操作。
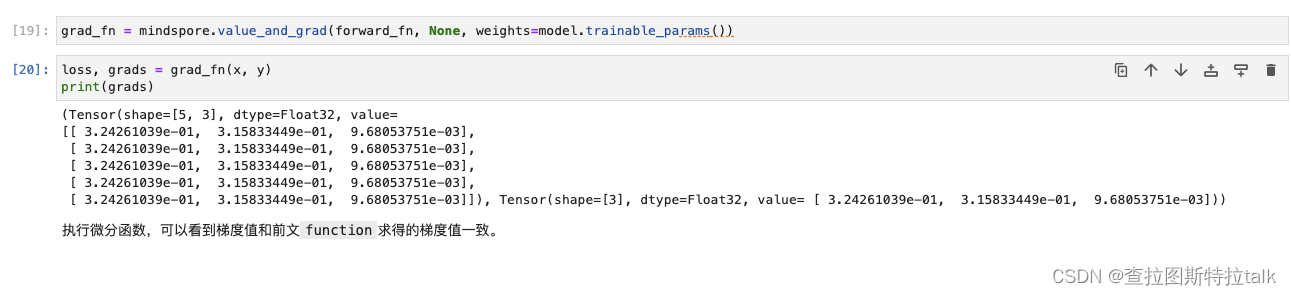
在使用 value_and_grad 接口获得微分函数后,由于模型参数为Cell的内部属性,我们不需要使用 grad_position 指定对函数输入求导,而是使用 weights 参数和 model.trainable_params() 方法从Cell中取出可以求导的参数进行模型参数的求导。
总结
通过一个简单的单层线性变换模型演示了自动微分的基本原理和用法,包括计算图的构建、微分函数的定义以及梯度计算。然后讨论了在神经网络构建过程中如何利用函数式自动微分进行反向传播。