
🎬 鸽芷咕 :个人主页
🔥 个人专栏 : 《C++干货基地》《粉丝福利》
⛺️生活的理想,就是为了理想的生活!
引入
Elasticsearch(简称ES)是一个基于Apache Lucene™的开源搜索引擎,无论在开源还是专有领域,Lucene 可以被认为是迄今为止最先进、性能最好的、功能最全的搜索引擎库。几天我们就来体验一下如何在海量数据中快速进行搜索。
文章目录
- 引入
- 一、环境搭建
- 二、创建数据索引
-
- [2.1创建 `my_index`的索引](#2.1创建
my_index的索引)
- [2.1创建 `my_index`的索引](#2.1创建
- [三. 进行数据导入](#三. 进行数据导入)
- [四、 进行数据搜索](#四、 进行数据搜索)
- 总结
一、环境搭建
首先,在使用 Elasticsearch 之前,我们需要先安装好服务,操作也很简单。
本次我们选择我们采用CentOS7来部署 ElasticSearch 服务。
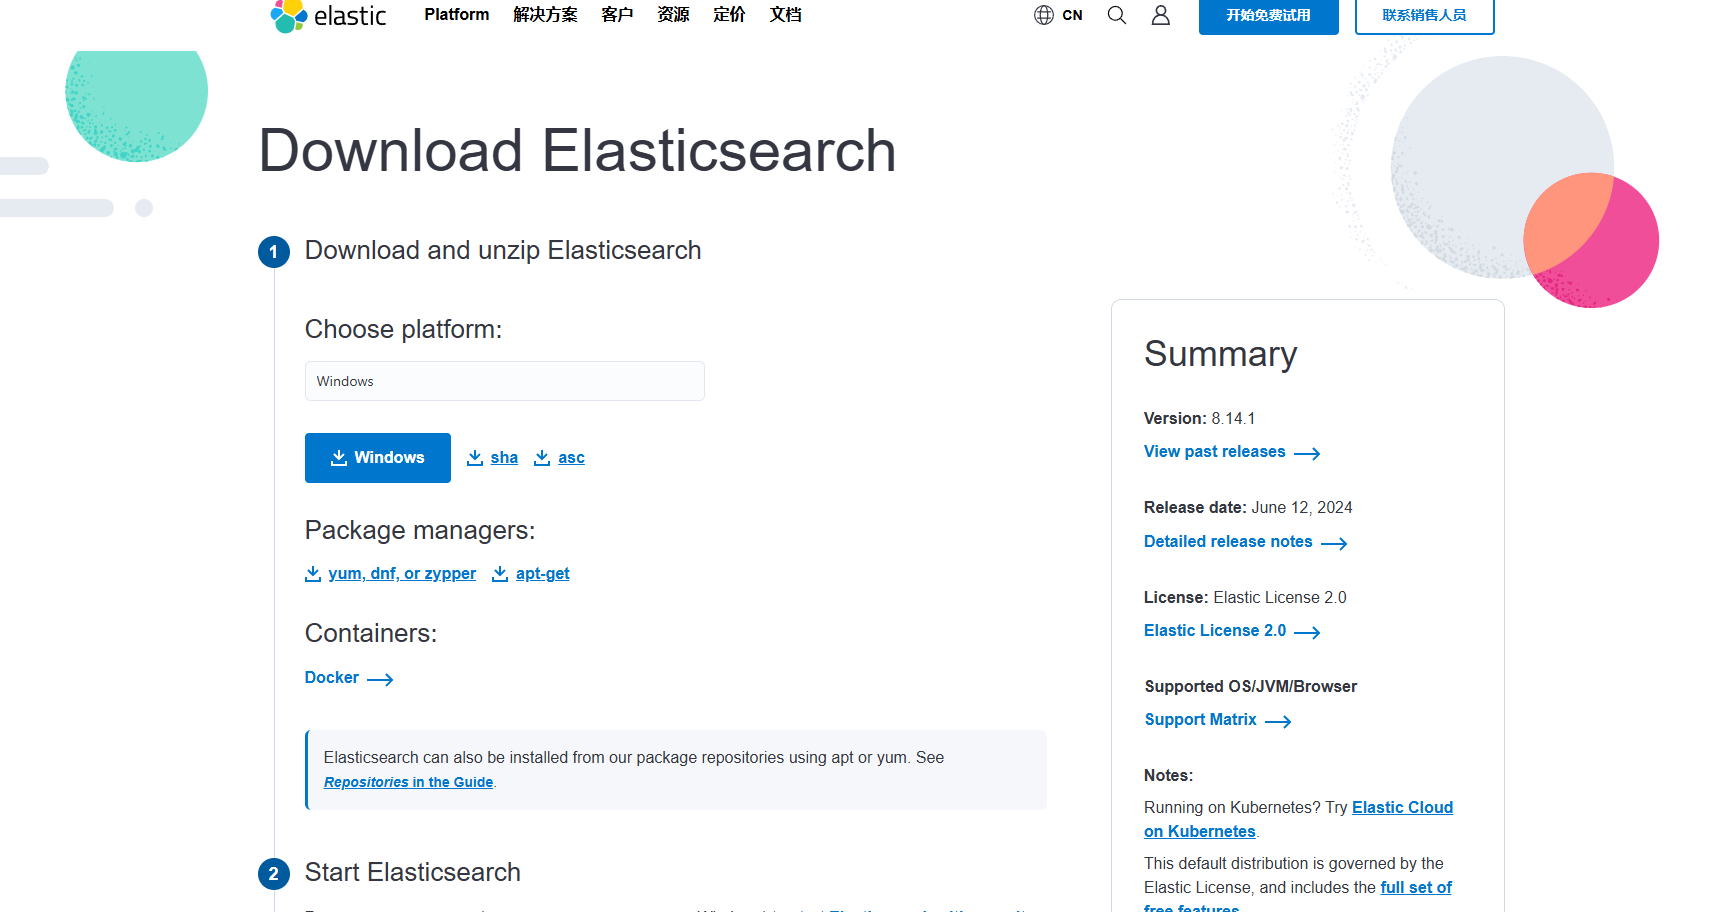
登录https://www.elastic.co/cn/downloads/elasticsearch,选择相应的系统环境下载软件包,这里我用的操作系统是CentOS,所以选择Linux环境。
1.1、安装JDK
Elasticsearch 是用 Java 语言开发的,所以在安装之前,需要先安装一下JDK
java
yum -y install java-1.8.0-openjdk查看java安装情况
java
java -version1.2、安装ElasticSearch
进入到对应上传的文件夹,安装ElasticSearch
java
rpm -ivh elasticsearch-6.1.0.rpm查找安装路径
java
rpm -ql elasticsearch一般是装在/usr/share/elasticsearch/下。
1.3、设置data的目录
创建/data/es-data目录,用于elasticsearch数据的存放
java
mkdir -p /data/es-data修改该目录的拥有者为elasticsearch
java
chown -R elasticsearch:elasticsearch /data/es-data1.4、设置log的目录
java
mkdir -p /log/es-log修改该目录的拥有者为elasticsearch
java
chown -R elasticsearch:elasticsearch /log/es-log1.5、修改配置文件elasticsearch.yml
java
vim /etc/elasticsearch/elasticsearch.yml修改如下内容:
java
#设置节点名称
cluster.name: my-es

#设置data存放的路径为/data/es-data
path.data: /data/es-data

#设置logs日志的路径为/log/es-log
path.logs: /log/es-log

#设置内存不使用交换分区,配置了bootstrap.memory_lock为true时反而会引发9200不会被监听,原因不明
bootstrap.memory_lock: false

#设置允许所有ip可以连接该elasticsearch
network.host: 0.0.0.0

#开启监听的端口为9200
http.port: 9200

#增加新的参数,为了让elasticsearch-head插件可以访问es (5.x版本,如果没有可以自己手动加)
http.cors.enabled: true
http.cors.allow-origin: "*"
1.6、启动elasticsearch
启动
systemctl start elasticsearch查看状态
systemctl status elasticsearch设置开机启动
systemctl enable elasticsearch启动成功之后,测试服务是否开启
curl -X GET http://localhost:9200同时也可以远程测试一下,如果网络被拒绝,检查防火墙是否开启
#查询防火墙状态
firewall-cmd --state如果状态是active表示已经开启,可以将其关闭
#关闭防火墙
systemctl stop firewalld.service
如果不想开机启动,可以输入如下命令
#禁止firewall开机启动
systemctl disable firewalld.service
二、创建数据索引
在Elasticsearch中,数据是以JSON格式存储的。首先,我们需要创建一个索引,索引相当于一个数据集合,它可以包含一个或多个类型(type)。
2.1创建 my_index的索引
java
PUT /my_index
{
  "settings": {
    "number_of_shards": 1,
    "number_of_replicas": 0
  },
  "mappings": {
    "properties": {
      "title": { "type": "text" },
      "content": { "type": "text" }
    }
  }
}在上面的例子中,我们创建了一个名为my_index的索引,并设置了分片数为1,副本数为0。同时,我们定义了两个字段title和content,它们的类型都是文本。
三. 进行数据导入
接下来,我们需要将数据导入到Elasticsearch中。可以使用POST请求和bulk API来实现。
java
POST /my_index/_bulk
{ "index": { "_id": 1 } }
{ "title": "Elasticsearch教程", "content": "这是一篇关于Elasticsearch的教程。" }
{ "index": { "_id": 2 } }
{ "title": "Elasticsearch实战", "content": "这是一篇关于Elasticsearch实战的教程。" }
四、 进行数据搜索
现在,我们的数据已经导入到Elasticsearch中,可以使用GET请求来搜索数据。
java
GET /my_index/_search
{
  "query": {
    "match": {
      "title": "Elasticsearch"
    }
  }
}
上面的例子中,我们使用了一个简单的匹配查询来搜索标题中包含"Elasticsearch"的文档。
总结
在本教程中,我们学习了如何在Elasticsearch中创建索引、导入数据、进行数据搜索以及一些性能优化建议。希望这些内容能够帮助您在海量级数据中实现快速搜索。