访问网站时IP被阻止
有些网站会设置特定规则来限制用户的访问,例如频率限制、单一账户多次登录等。
网站为了保护自身安全和用户体验,会设置防御机制,将涉嫌恶意行为的IP地址加入黑名单并屏蔽访问。如果用户在使用网站时违反了这些规则,就会出现这种情况。
例如,我们使用爬虫爬取网站数据的时候,就会过多的请求网站,这样可能会导致IP地址被网站屏蔽。就是用户在短时间内发送了大量请求,网站可能会误认为其是恶意行为,从而采取屏蔽措施。
解决的方法其一就是请求的时候更换IP地址。
代理IP的爬取
要更换IP地址,其实我是最喜欢白嫖的了,我们可以爬取代理IP网站的免费IP来使用,不过,经过我的验证,免费的代理IP几乎没有可用的。。。
思路分析:
1、找代理IP的网站,一般他们都有免费IP提供。
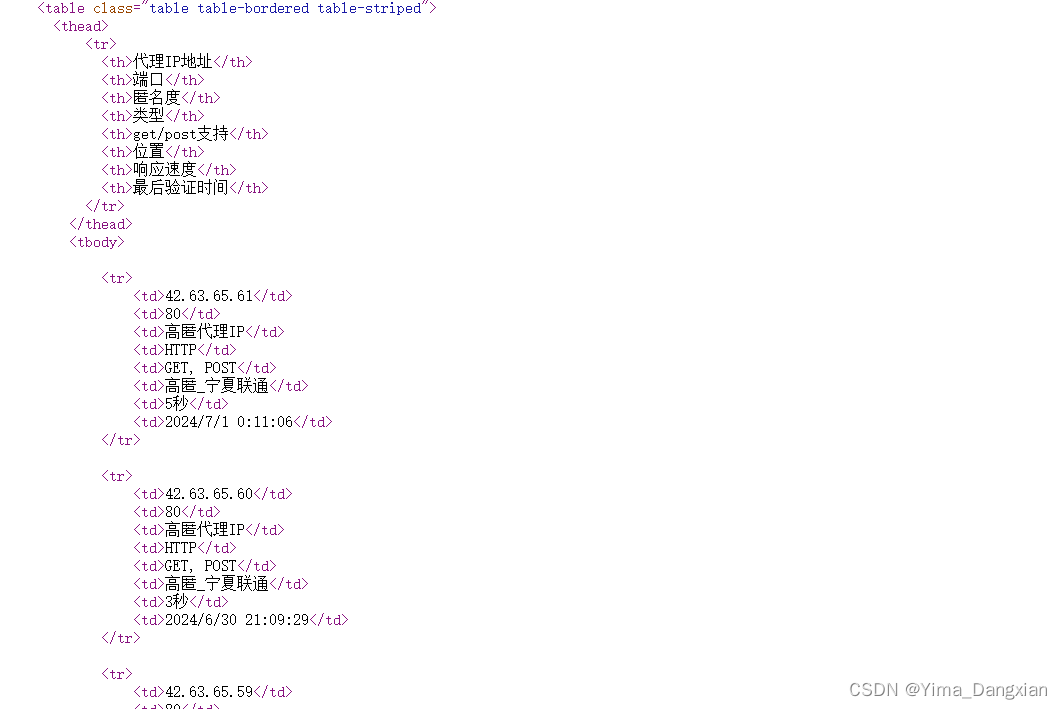
2、看数据是静态还是动态,一般翻页后URL地址会更新那这个网页一般就是静态数据,反之为动态。
3、以下爬取的代理IP地址是个静态页面,里面的IP数据可以直接用xpath、bs4语法提取:
4、最后存入txt文件中
以下是爬取免费代理IP及使用的脚本:
python
import requests
from fake_useragent import UserAgent
from lxml import etree
import json


# 请求获取IP数据及端口号
def request_ip():
    ip_list = list()
    ip_dict = dict()
    headers = {
        'User-Agent': UserAgent().random
    }
    for page in range(1, 7):
        url = f'http://www.ip3366.net/?stype=1&page={page}'
        response = requests.get(url, headers=headers)
        if response.status_code == 200:
            html = etree.HTML(response.text)
            ips = html.xpath('//div[@id="list"]/table/tbody/tr/td[1]/text()')
            ports = html.xpath('//div[@id="list"]/table/tbody/tr/td[2]/text()')
            for i in range(0, 15):
                ip_dict["ip"] = ips[i]
                ip_dict["port"] = ports[i]
                ip_list.append(ip_dict)
            print(ip_list)
        else:
            print(response.status_code)
    verify_and_save(ip_list)


# 获取的IP数据进行爬取验证及存储
def verify_and_save(ip_list):
    headers = {
        'User-Agent': UserAgent().random
    }
    for temp in ip_list:
        proxies = {
            'http': 'http://' + temp['ip'] + ':' + temp['port'],
            'https': 'http://' + temp['ip'] + ':' + temp['port']
        }
        with open('ip.txt', 'a', encoding='utf-8') as f:
            f.write(json.dumps(temp, ensure_ascii=False, indent=4) + '\n')
        print('ip代理:', proxies)
        try:
            response = requests.get('https://www.baidu.com/', headers=headers, proxies=proxies, timeout=3)
            if response.status_code == 200:
                print(response.text)
                with open('success_ip.txt', 'a', encoding='utf-8') as f:
                    f.write(json.dumps(temp, ensure_ascii=False, indent=4) + '\n')
        except Exception as e:
            print('请求超时:', e)


if __name__ == '__main__':
    request_ip()
但是最终没有生成success_ip.txt文件,我一开始以为程序有bug,结果发现是真的一个能用的IP都没有,所以公开的免费IP基本是不可用的。