本文将简单介绍如何在Windows环境下通过Ollama本地部署大语言模型(LLM),并通过OpenWebUI实现访问。
一、准备工作
1. 系统要求
- 操作系统:Windows 10 或更新版本
- 内存:16GB 以上
- GPU:性能和显存足够,如RTX 3060以上
二、安装Ollama
1. 下载和安装
-
访问Ollama的官网下载适用于Windows的安装包
https://ollama.com/download

-
运行下载的安装包,按照提示完成安装。默认安装路径为:
C:\Users\username\AppData\Local\Programs\Ollama

2. 配置环境变量
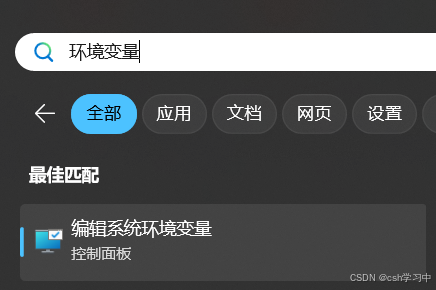
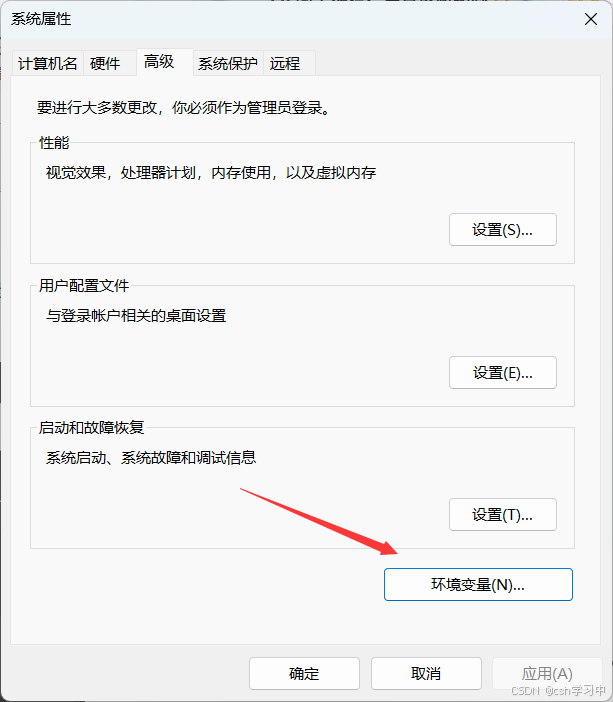
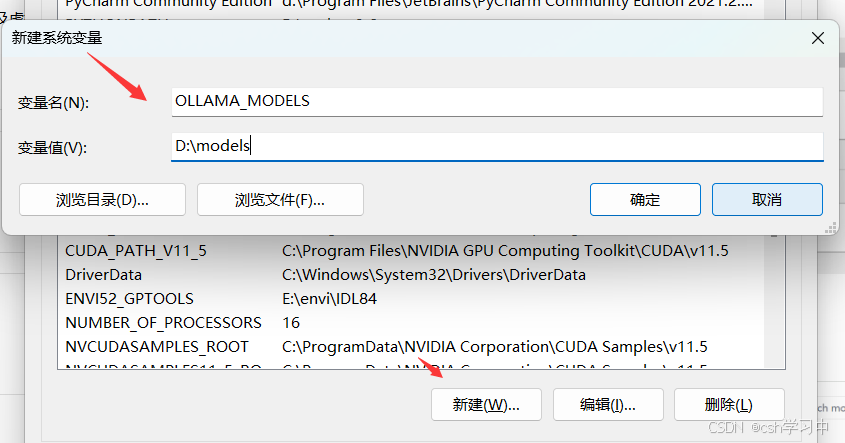
同时,因为默认安装和模型下载路径为C盘,为了更改模型的下载路径,可以在环境变量中这样修改:
三、运行Ollama模型
1. 下载模型
Ollama支持多种LLM模型,例如Llama2、Llama3等。你可以使用以下命令下载并运行模型:
ollama run llama2如果Ollama找不到模型,它会自动下载。下载完成后,你可以在命令行中输入提示以测试模型。
2. 列出本地模型
使用以下命令查看已下载的模型列表:
ollama list四、安装OpenWebUI
1. 下载和安装
OpenWebUI是一个用户友好的Web界面,便于与LLM进行交互。你可以从其GitHub仓库下载最新版本。以下是非Docker方式的安装步骤:
-
下载OpenWebUI的安装包,并解压到指定目录。
-
打开命令行,进入OpenWebUI的解压目录,运行以下命令安装依赖:
npm install
安装完成后,启动OpenWebUI:
npm start2. 配置和访问
启动后,OpenWebUI将在本地的3000端口运行。你可以在浏览器中访问http://localhost:3000查看和使用Web界面。
五、实现公网访问
如果你需要在公网环境中访问本地部署的LLM,可以使用内网穿透工具如cpolar:
安装并配置cpolar,具体步骤请参考cpolar官网,并运行以下命令将本地的3000端口暴露到公网:
cpolar http 3000获取公网地址后,你可以在任何地方通过该地址访问OpenWebUI界面。
【参考资料】