1.环境准备
需要linux操作系统,并安装了docker环境
此处使用虚拟机演示。(虚拟机和docker看参考我之前写的文章)
VirtualBox安装Oracle Linux 7.9全流程-CSDN博客
VirtualBox上的Oracle Linux虚拟机安装Docker全流程-CSDN博客
简单演示搭建ES+FileBeat+Kibana进行日志采集、上报、展示、搜索流程。
2.创建elk网络
docker network create elk

3.docker拉取并启动ES
docker run -d \
--name=elasticsearch \
-v es-data:/usr/share/elasticsearch/data \
-e ES_JAVA_OPTS="-Xms256m -Xmx512m" \
-e "discovery.type=single-node" \
-e "xpack.security.enabled=false" \
--net elk \
-p 9200:9200 -p 9300:9300 \
镜像比较大,执行需要耐心等待下。
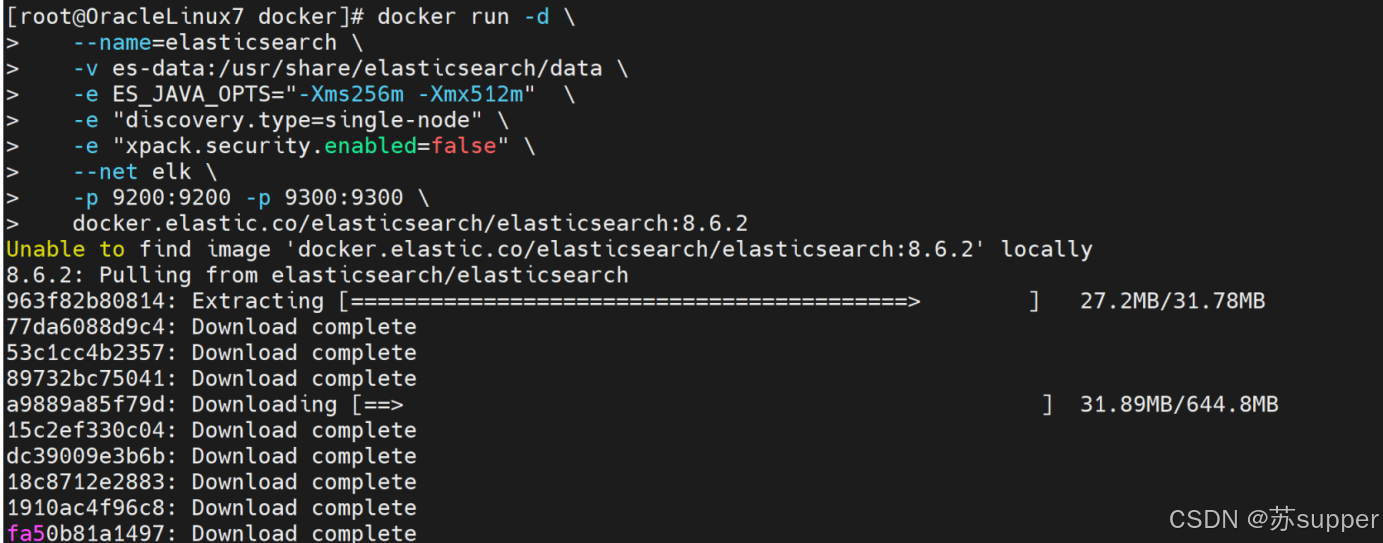
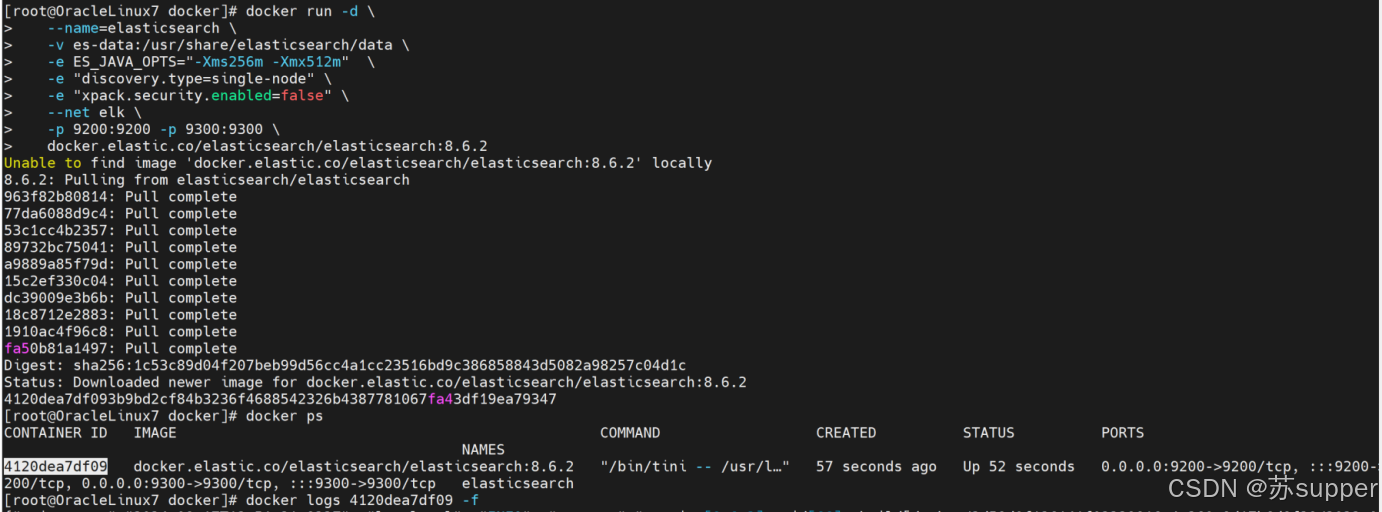
Elasticsearch容器启动成功。
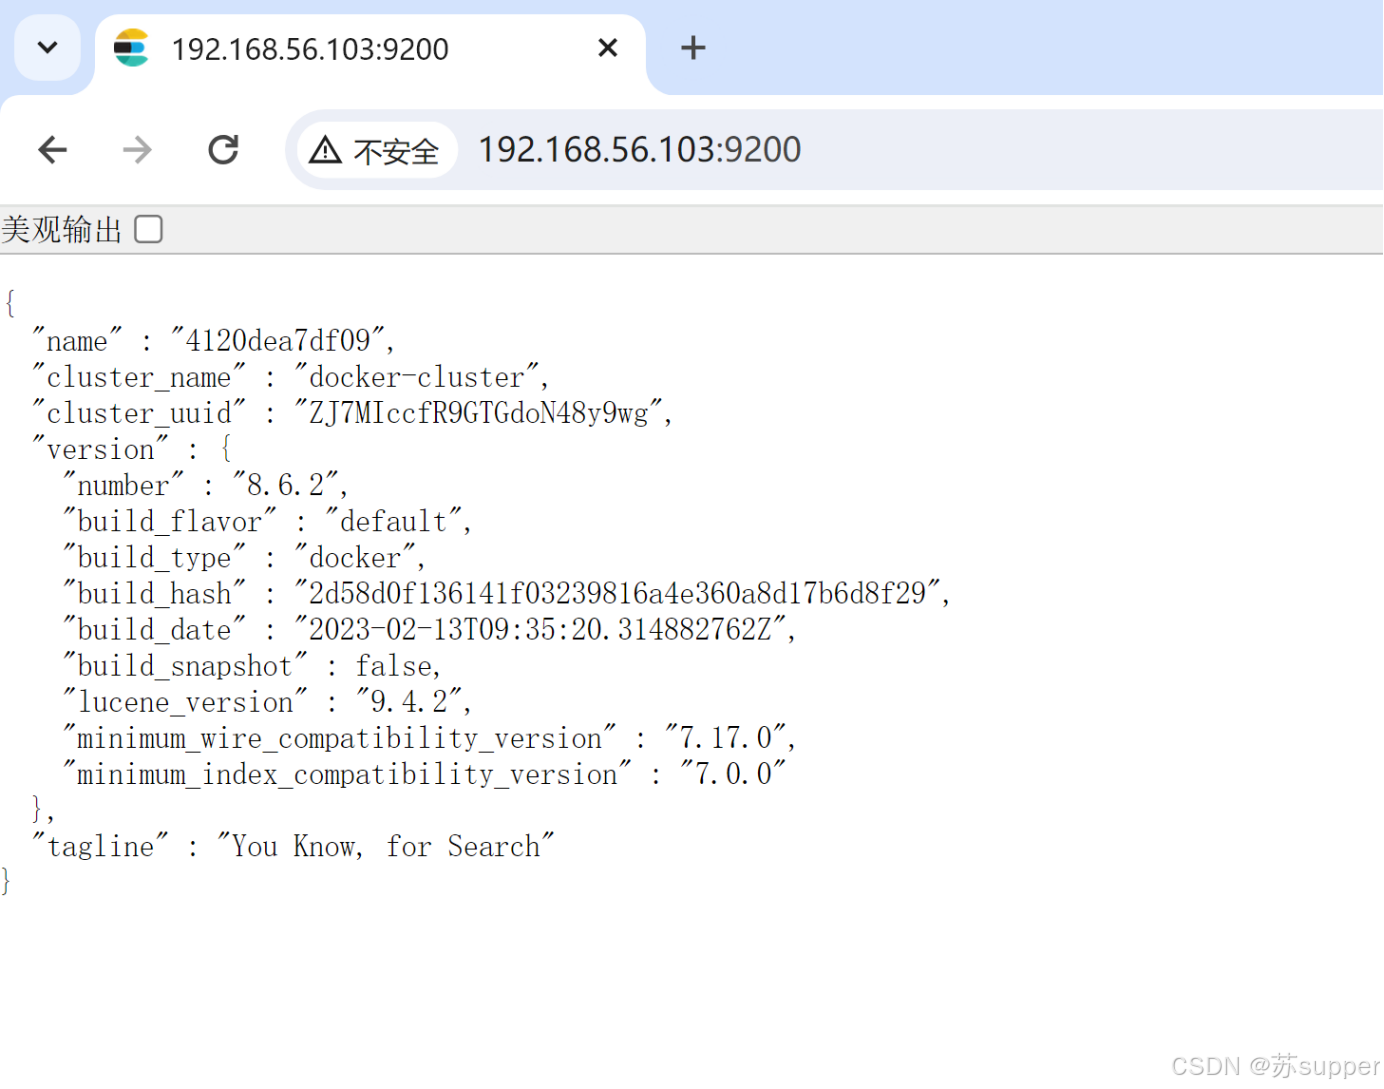
访问http://192.168.56.103:9200 显示如下
4.docker拉取并启动kibana
docker run -d \
--name=kibana \
-e ELASTICSEARCH_HOSTS=http://elasticsearch:9200 \
-e I18N_LOCALE=zh-CN \
--net elk \
-p 5601:5601 \
docker.elastic.co/kibana/kibana:8.6.2
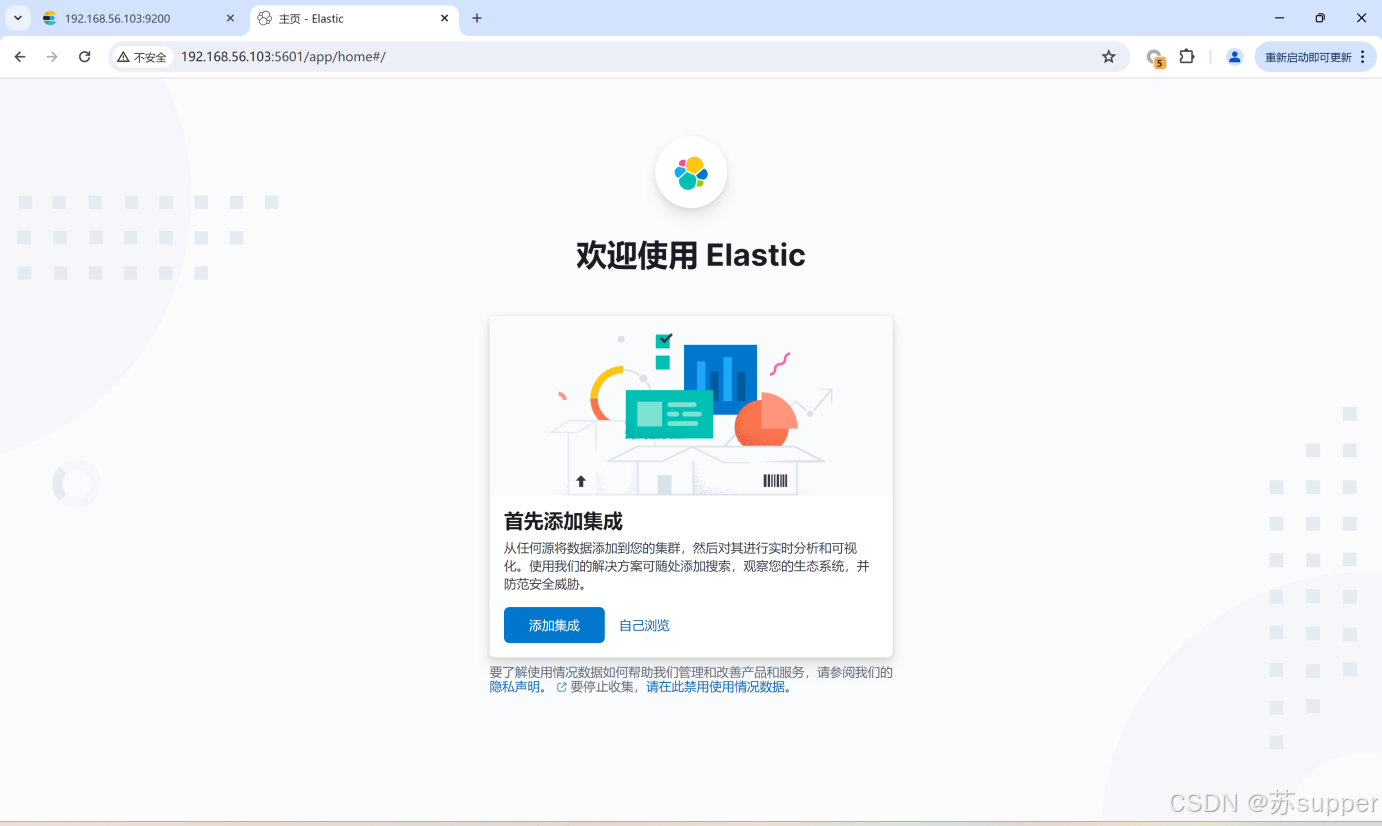
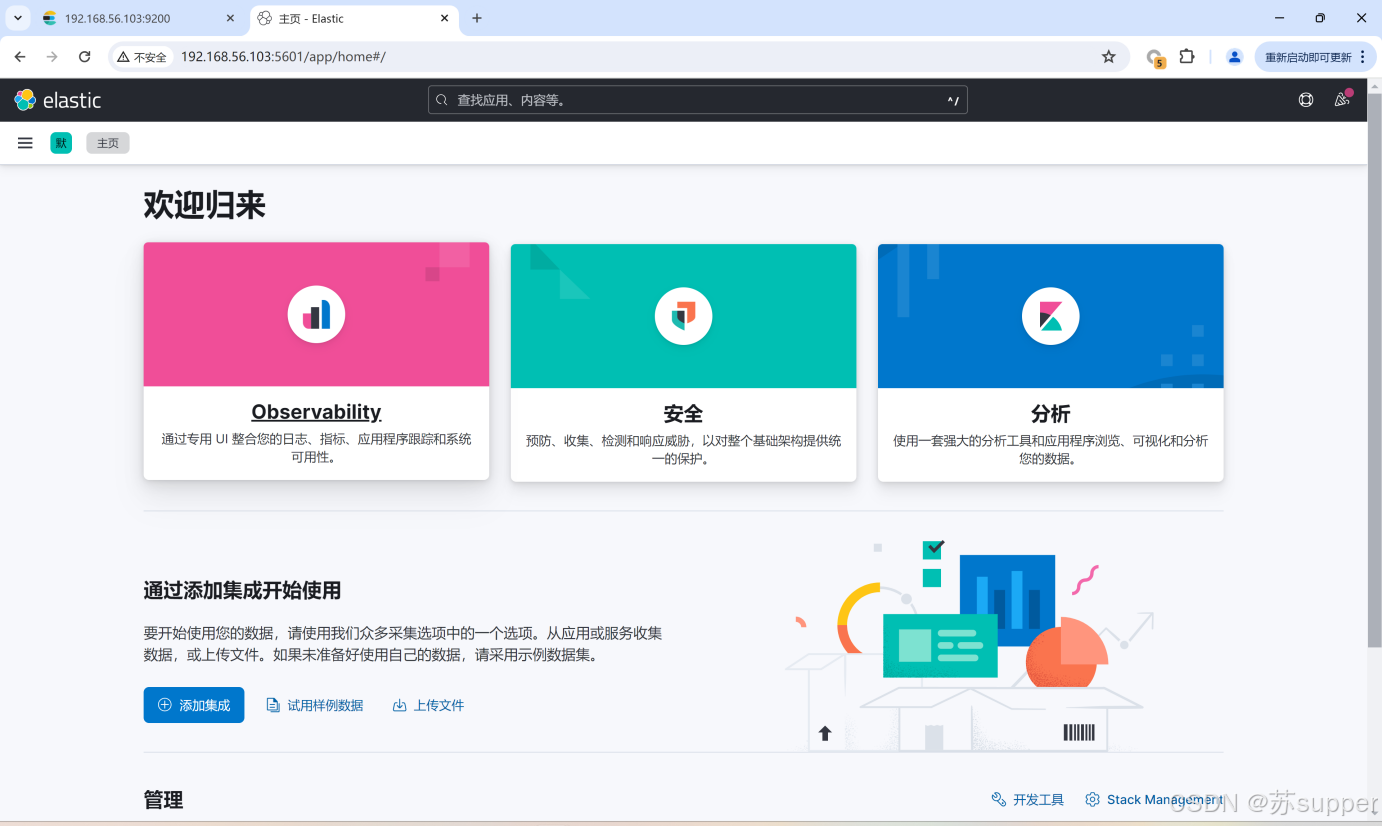
kibana容器启动成功#查看运行的容器
docker ps -a
#观察kibana容器日志输出
docker logs kibana --tail 20 -f

5.安装filebeat日志采集
5.1 安装filebeat
wget https://artifacts.elastic.co/downloads/beats/filebeat/filebeat-8.6.2-x86_64.rpm
rpm -ivh filebeat-8.6.2-x86_64.rpm

5.2 修改filebeat配置
cd /etc/filebeat
mv filebeat.yml filebeat.yml.bak
vim filebeat.yml
添加如下:
filebeat.inputs:
- type: log
enabled: true
paths:
/var/log/*log
/var/log/messages
setup.ilm.enabled: false
setup.template.name: "test"
setup.template.pattern: "test-*"
output.elasticsearch:
hosts: "http://localhost:9200"
index: "test-%{+yyyy.MM.dd}"

5.3启动filebeat
#测试配置是否正确
filebeat test config
#测试一下 Filebeat 和 Elasticsearch 是否连接成功
#设置初始环境filebeat setup -e
#启动filebeat
systemctl start filebeat
#查看filebeat的日志
tail -20f /var/log/messages


6.kibana配置数据视图及展示搜索日志
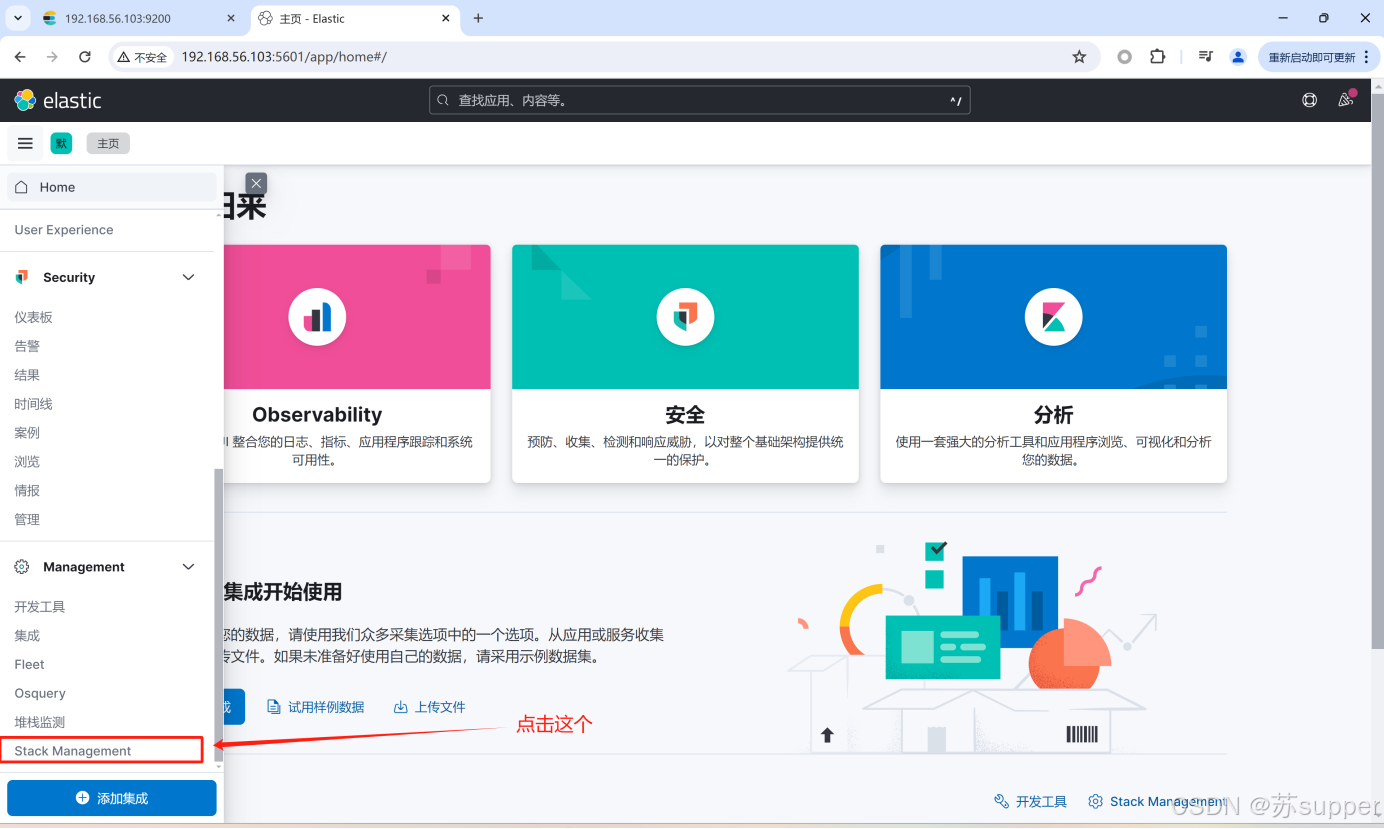
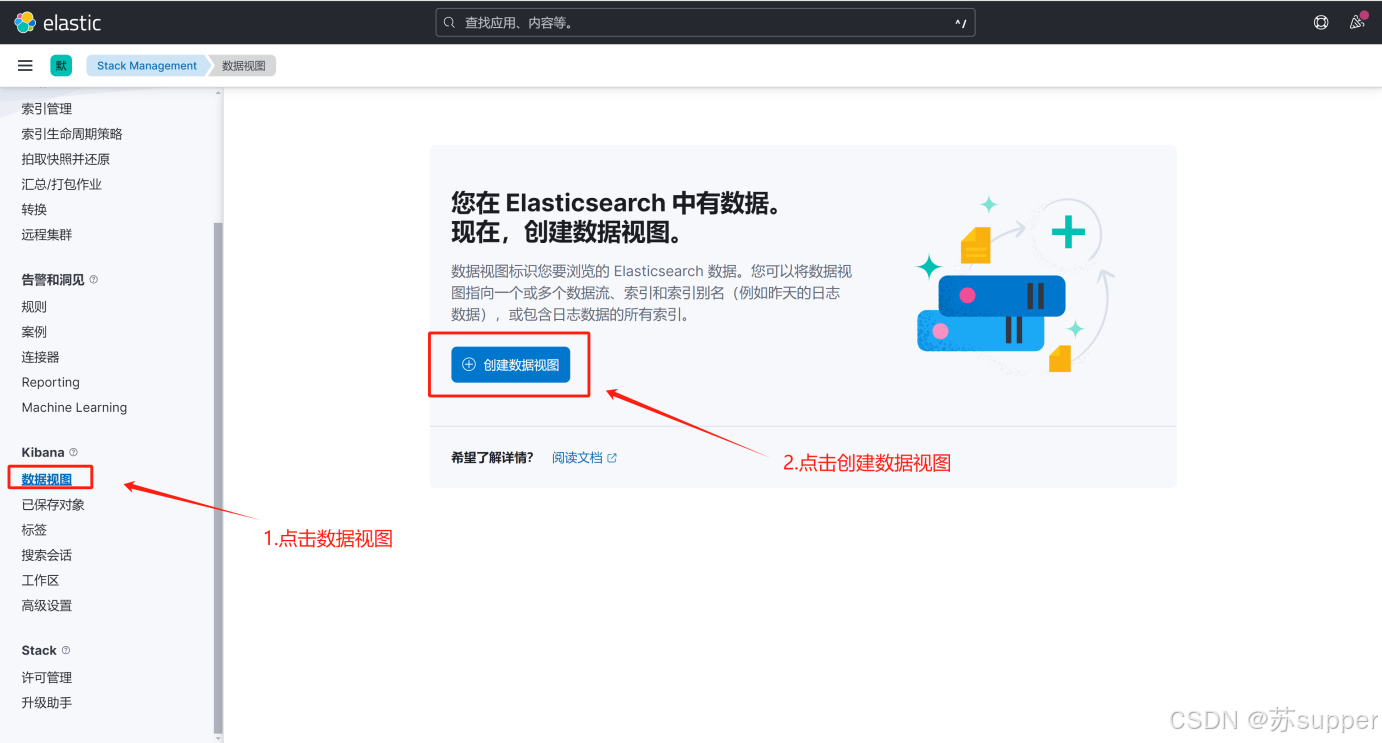
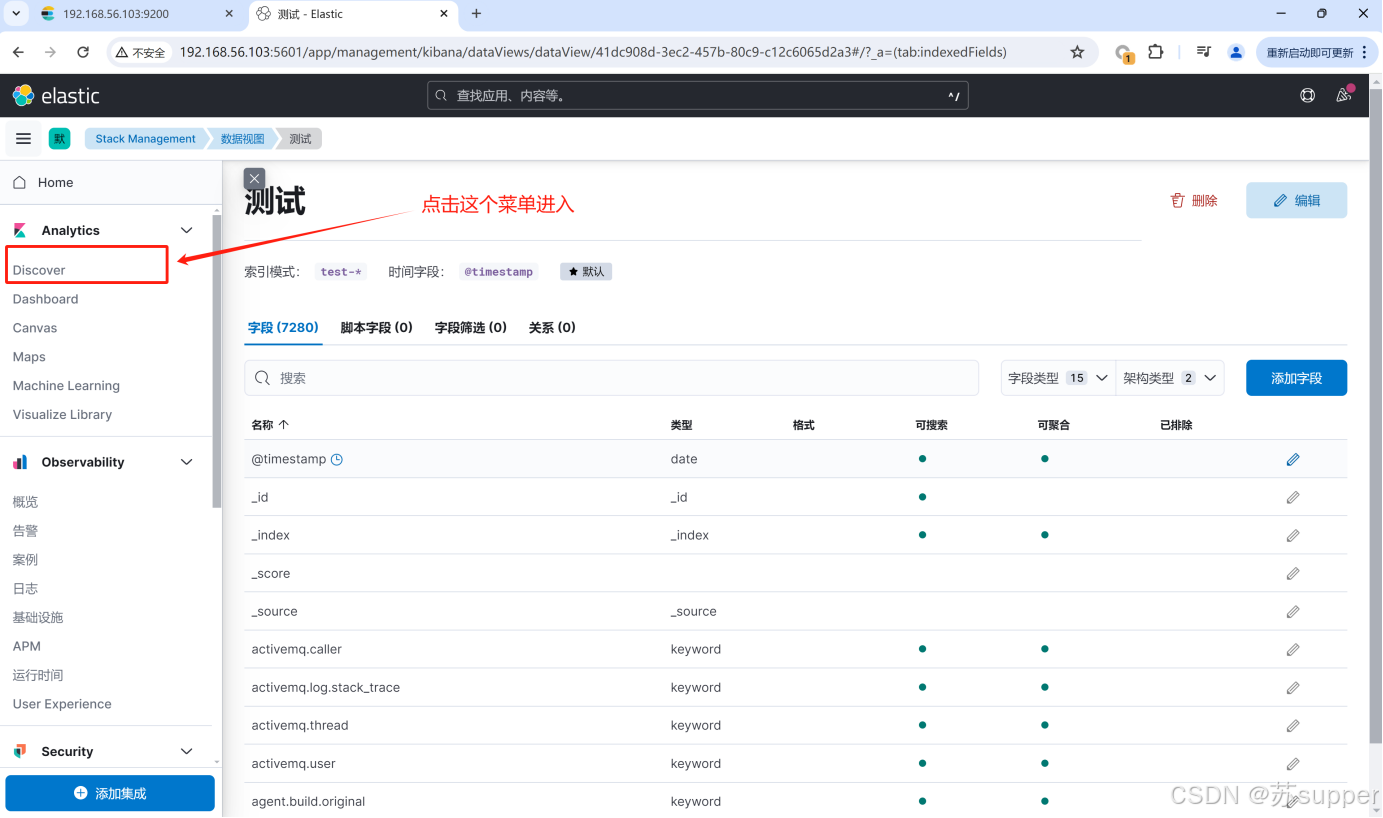
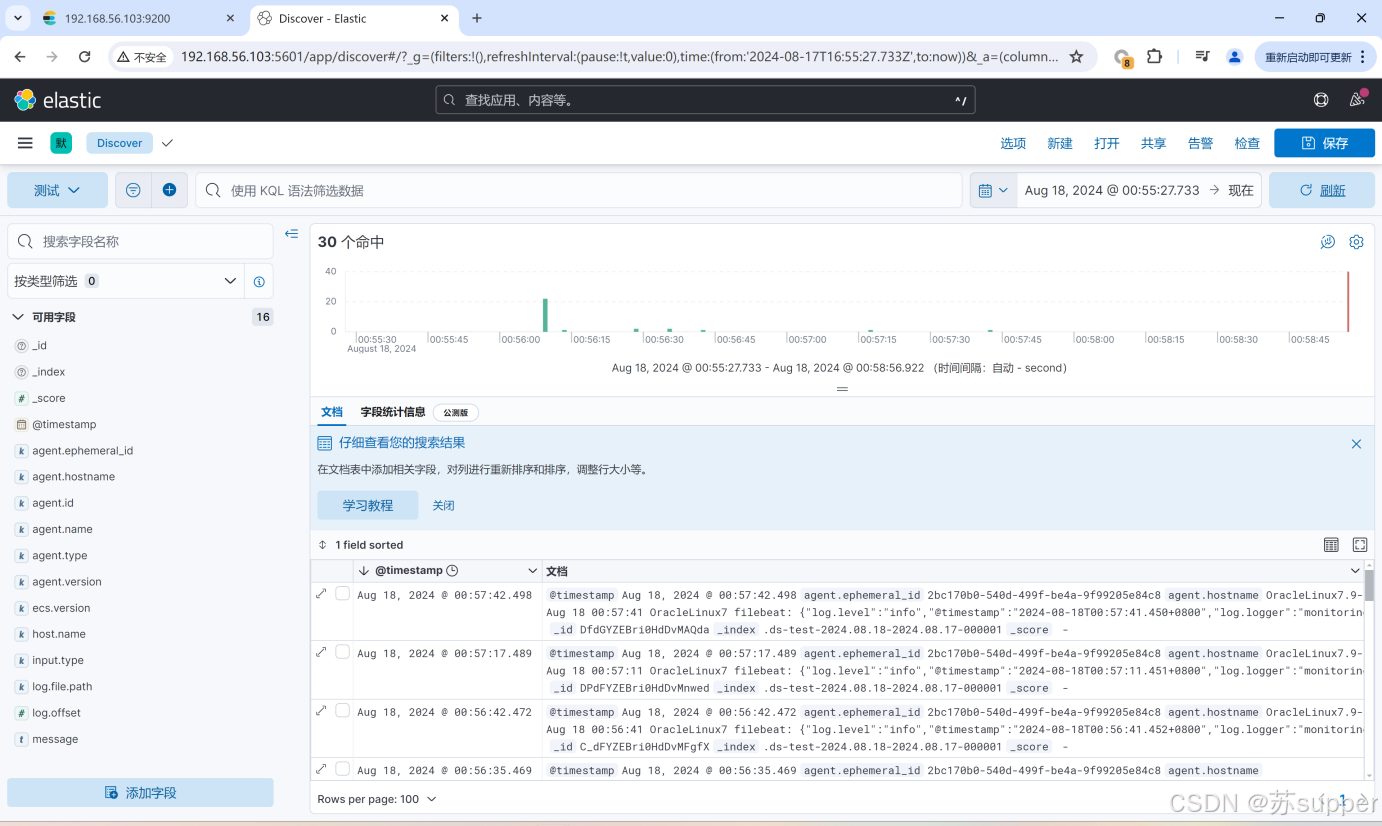
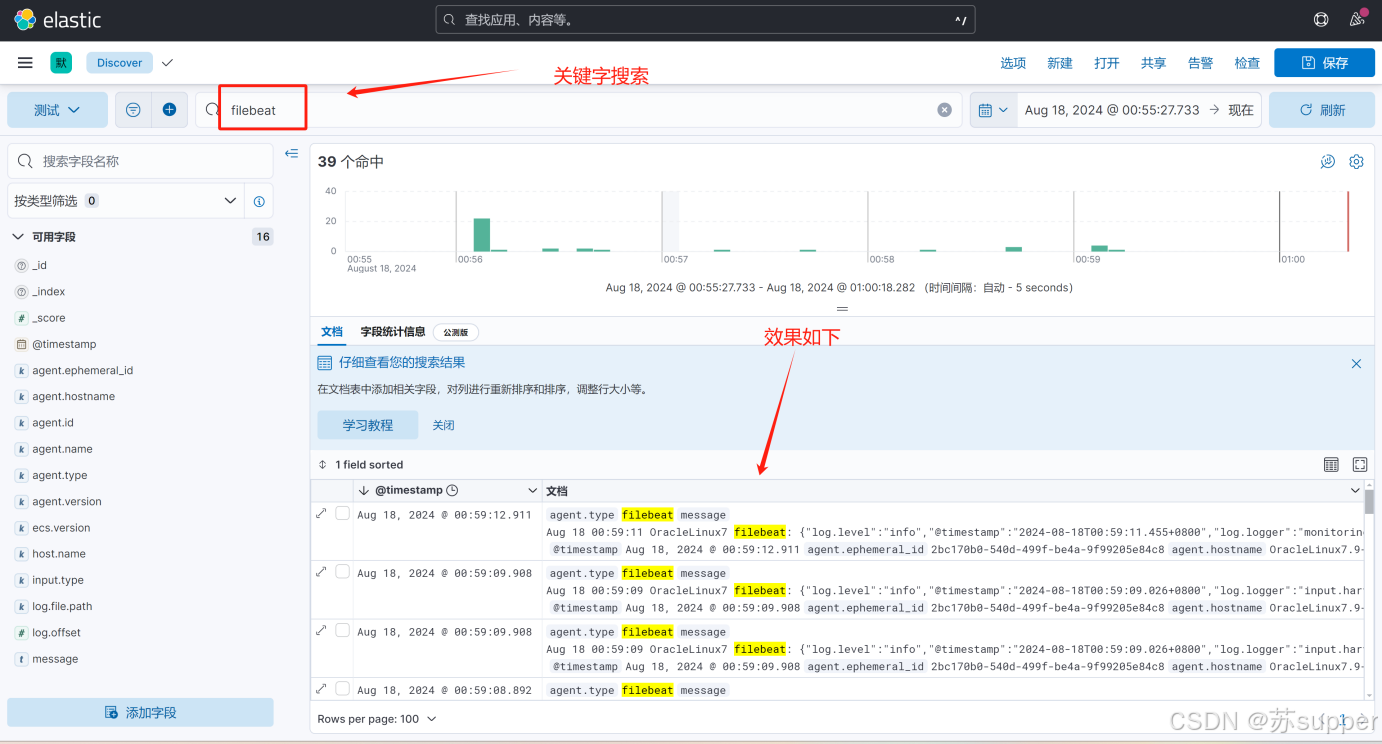
最终能看到日志已经加载到ES上了,在kibana上的效果如下:
这些匹配的规则文件都会被上报到es中
/var/log/*log #这个是符合log后缀的文件
/var/log/messages #这个是filebeat的日志文件