文章目录
环境配置(必看)
Anaconda-创建虚拟环境的手把手教程相关环境配置看此篇文章,本专栏深度学习相关的版本和配置,均按照此篇文章进行安装。
头文件引用
python
from sklearn.datasets import load_boston
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import Ridge
from sklearn.metrics import mean_squared_error
import joblib
1.保存模型
代码工程
python
将模型信息保存到my_ridge.pkl文件中
python
def linear3():
    """
    岭回归对波士顿房价进行预测
    :return:
    """
    # 1.获取数据集
    boston = load_boston()
    print(f"特征数量: {boston.data.shape}")
    # 2.划分数据集
    x_train, x_test, y_train, y_test = train_test_split(boston.data, boston.target, random_state=22)
    # 3.标准化
    transfer = StandardScaler()
    x_train = transfer.fit_transform(x_train)
    x_test = transfer.transform(x_test)
    # 4.预估器     alpha:正则化力度  max_iter:迭代次数
    estimator = Ridge(alpha=0.5, max_iter=10000)
    estimator.fit(x_train, y_train)

    # 保存模型
    joblib.dump(estimator, "my_ridge.pkl")

    # 5.得出模型
    print(f"岭回归权重系数为: {estimator.coef_}")
    print(f"岭回归权重为: {estimator.intercept_}")
    # 6.模型评估
    y_predict = estimator.predict(x_test)
    # print(f"预测房价: {y_predict}")
    error = mean_squared_error(y_test, y_predict)
    print(f"岭回归-均方误差: {error} \n")
运行结果
生成文件
python
此文件中保存的是模型的信息
2.加载模型
代码工程
python
def read_model():
    """
    加载本地模型信息
    :return:
    """
    # 1.获取数据集
    boston = load_boston()
    print(f"特征数量: {boston.data.shape}")
    # 2.划分数据集
    x_train, x_test, y_train, y_test = train_test_split(boston.data, boston.target, random_state=22)
    # 3.标准化
    transfer = StandardScaler()
    x_train = transfer.fit_transform(x_train)
    x_test = transfer.transform(x_test)
    # 加载模型
    estimator = joblib.load("my_ridge.pkl")
    # 得出模型
    print(f"岭回归权重系数为: {estimator.coef_}")
    print(f"岭回归权重为: {estimator.intercept_}")
    # 模型评估
    y_predict = estimator.predict(x_test)
    # print(f"预测房价: {y_predict}")
    error = mean_squared_error(y_test, y_predict)
    print(f"岭回归-均方误差: {error} \n")
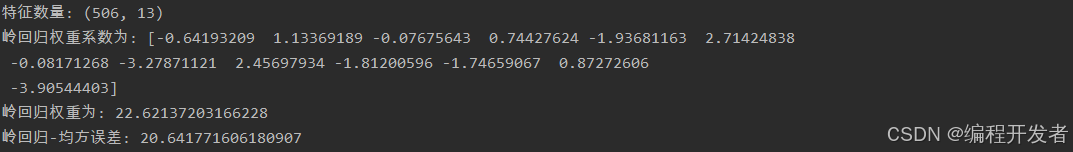
运行结果
可以和上边保存模型的运行结果做对比,对比的结果是一样的,说明保存模型参数成功
