拉链表的设计与实现
数据同步问题
背景
- 例如:MySQL中有一张用户表: tb_user,每个用户注册完成以后,就会在用户表中新增该用户的信息,记录该用户的id、手机号码、用户名、性别、地址等信息。

- 每天都会有用户注册,产生新的用户信息
- 每天都需要将MySQL中的用户数据同步到Hive数据仓库中
- 需要对用户的信息做统计分析,例如统计新增用户的个数、用户性别分布
- 地区分布、运营商分布等指标
如果已经同步的数据发生变化怎么办?
- 2021-01-02:MySQL中新增2条用户注册数据,并且有1条用户数据发生更新
- 新增两条用户数据011和012
- 008的addr发生了更新,从gz更新为sh

- 2021-01-03:Hive需要对2号的数据进行同步更新处理
- 问题:新增的数据会直接加载到Hive表中,但是更新的数据如何存储在Hive表中?

解决方案
方案一:在Hive中用新的addr覆盖008的老的addr,直接更新

优点:实现最简单,使用起来最方便
缺点:没有历史状态,008的地址是1月2号在sh,但是1月2号之前是在gz的,如果要查询008的1月2号之前的addr就无法查询,也不能使用sh代替
方案二:每次数据改变,根据日期构建一份全量的快照表,每天一张表

优点:记录了所有数据在不同时间的状态
缺点:冗余存储了很多没有发生变化的数据,导致存储的数据量过大
方案三:构建拉链表,通过时间标记发生变化的数据的每种状态的时间周期

功能与应用场景
拉链表专门用于解决在数据仓库中数据发生变化如何实现数据存储的问题。- 拉链表的设计是将
更新的数据进行状态记录,没有发生更新的数据不进行状态存储,用于存储所有数据在不同时间上的所有状态,通过时间进行标记每个状态的生命周期,查询时,根据需求可以获取指定时间范围状态的数据,默认用9999-12-31等最大值来表示最新状态。
实现过程

SQL实现
1、创建拉链表
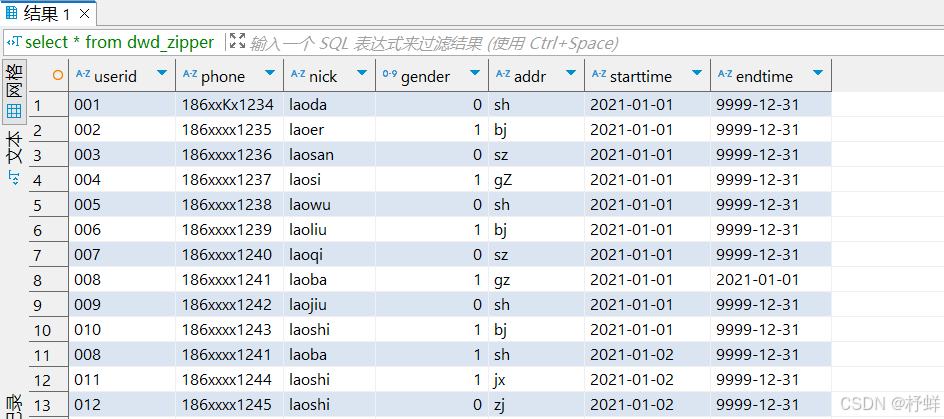
zipper.txt
001	186xxKx1234	laoda	0	sh	2021-01-01	9999-12-31
002	186xxxx1235	laoer	1	bj	2021-01-01	9999-12-31
003	186xxxx1236	laosan	0	sz	2021-01-01	9999-12-31
004	186xxxx1237	laosi	1	gZ	2021-01-01	9999-12-31
005	186xxxx1238	laowu	0	sh	2021-01-01	9999-12-31
006	186xxxx1239	laoliu	1	bj	2021-01-01	9999-12-31
007	186xxxx1240	laoqi	0	sz	2021-01-01	9999-12-31
008	186xxxx1241	laoba	1	gz	2021-01-01	9999-12-31
009	186xxxx1242	laojiu	0	sh	2021-01-01	9999-12-31
010	186xxxx1243	laoshi	1	bj	2021-01-01	9999-12-31
SQL:
sql
-- 1、创建拉链表
create table dwd_zipper(
	userid string,
	phone string,
	nick string,
	gender int,
	addr string,
	starttime string,
	endtime string
) row format delimited fields terminated by '\t';

load data local inpath '/root/hivedata/zipper.txt' into table dwd_zipper;

select * from dwd_zipper;
2、模拟增量数据采集
zipper_update.txt
008	186xxxx1241	laoba	1	sh	2021-01-02	9999-12-31
011	186xxxx1244	laoshi	1	jx	2021-01-02	9999-12-31
012	186xxxx1245	laoshi	0	zj	2021-01-02	9999-12-31
SQL:
sql
-- 2、增量数据
create table ods_zipper_update(
	userid string,
	phone string,
	nick string,
	gender int,
	addr string,
	starttime string,
	endtime string
) row format delimited fields terminated by '\t';

load data local inpath '/root/hivedata/zipper_update.txt' into table ods_zipper_update;
3、创建临时表
sql
-- 3、创建临时表
create table dwd_zipper_tmp(
	userid string,
	phone string,
	nick string,
	gender int,
	addr string,
	starttime string,
	endtime string
) row format delimited fields terminated by '\t';
4、合并历史拉链表与增量表
sql
-- 4、合并历史拉链表与增量表
insert overwrite table dwd_zipper_tmp
select * from ods_zipper_update
union all
-- 查询原来拉链表的所有数据,并将这次需要更新的数据的endtime更改为值的starttime
select
	a.userid,
	a.phone,
	a.nick,
	a.gender,
	a.addr,
	a.starttime,
	-- 如果这条数据没有更新或者这条数据不是要更改的数据,就保留原来的值,否则就改为新数据的开始时间-1
	if(b.userid is null or a.endtime < '9999-12-31',a.endtime,date_sub(b.starttime,1)) as endtime
from dwd_zipper a left join ods_zipper_update b on a.userid=b.userid;
5、覆盖拉链表
sql
-- 5、覆盖拉链表
insert overwrite table dwd_zipper
select * from dwd_zipper_tmp;
6、查看拉链表