Efficient image generation with Stable Diffusion models and AITemplate using AMD GPUs

2024年1月24日,作者是[Douglas Jia](https://rocm.blogs.amd.com/authors/douglas-jia.html#djia "Douglas Jia")
Stable Diffusion 已成为图像生成领域的突破性进展,帮助用户将文本描述转化为引人入胜的视觉输出。
Stable Diffusion 的核心是一种独特的方法,称为_扩散建模_。这一过程在正向传递中将现有图像逐渐引入噪声,直到它变得无法识别。然后,在文本提示的指导下,模型细致地反向执行该过程,逐步将噪声图像还原成与文本输入相符的清晰且有意义的表示。这一创新技术使Stable Diffusion能够以非凡的逼真度和对文本输入的严格遵循,生成图像。
通过仔细控制扩散过程并结合文本指导,模型有效地捕捉到文本的本质,将抽象概念转化为生动的视觉表现。
Stable Diffusion 的多功能性不仅限于文本到图像生成,其能力还涵盖一系列图像处理任务,包括图像到图像转换和修补。
-
图像到图像转换涉及在保留主要特征(如风格、色彩调色板和结构)的同时,将一个图像转换为另一个图像。
-
修补 侧重于通过用合理且一致的细节填充缺失或损坏的区域,恢复损坏或不完整的图像。
AITemplate在增强Stable Diffusion的性能和效率方面起到了关键作用。这个开源的Python框架将AI模型转化为高性能的C++ GPU模板代码,以加速推理。它通过分析模型架构,然后融合和优化特定于该架构的层和操作,从而生成充分利用目标硬件(特别是AMD GPU)能力的高度优化代码。
通过支持AMD MatrixCore架构,AITemplate通过高效利用硬件资源进一步提升性能。这转化为更快的推理时间、更流畅的图像生成以及更简化和用户友好的体验。
在这篇博客中,我们将使用预训练的Stable Diffusion模型,在AMD GPU上结合AITemplate进行文本到图像生成。您也可以独立探索图像到图像生成和修补的步骤。
设置运行环境
在安装ROCm及其兼容包之后,您可以在AMD GPU上运行Stable Diffusion模型。具体安装步骤请参考[ROCm安装指南](https://rocm.docs.amd.com/projects/install-on-linux/en/latest/tutorial/quick-start.html "ROCm安装指南")。
在本博客中,我们在以下环境中测试了代码片段:ROCm 5.7、Ubuntu 22.04、Python 3.10 和 Pytorch 2.0.1。为了方便起见,您可以直接在Linux系统中拉取并运行Docker容器,使用以下代码:
docker pull rocm/pytorch
docker run -it --ipc=host --network=host --device=/dev/kfd --device=/dev/dri \
           --group-add video --cap-add=SYS_PTRACE --security-opt seccomp=unconfined \
           --name=sdxl rocm/pytorch:rocm5.7_ubuntu22.04_py3.10_pytorch_2.0.1 /bin/bash
进入运行中的Docker容器(或其他合适的PyTorch/ROCm环境)后,您需要安装必要的Python包,特别是AITemplate。
注意,[Meta Incubator](https://github.com/facebookincubator "Meta Incubator")上的AITemplate包可能与ROCm不兼容。我们建议从[ROCmSoftwarePlatform](https://github.com/ROCmSoftwarePlatform "ROCmSoftwarePlatform")仓库克隆代码,并使用以下代码安装AITemplate包:
bash
git clone --recursive --branch ds-blog https://github.com/ROCmSoftwarePlatform/AITemplate

cd AITemplate/python
python setup.py bdist_wheel
pip install dist/aitemplate-*.whl
要安装其他必要的包,请使用:
bash
pip3 install diffusers transformers click accelerate生成带有文本提示的图像
首先,下载 diffusers 管道文件。该模型是 stabilityai/stable-diffusion-2-1,这是从 stable-diffusion-2 (768-v-ema.ckpt) 微调而来的。生成图像的分辨率为 768 x 768 像素。
bash
cd ../examples/05_stable_diffusion/

python3 scripts/download_pipeline.py \
--model-name "stabilityai/stable-diffusion-2-1"
然后,编译模型。
bash
python3 scripts/compile.py --width 768 --height 768你可以通过提供不同的提示语来测试编译后的模型。例如:
bash
python3 scripts/demo_alt.py --hf-hub-or-path stabilityai/stable-diffusion-2-1 --width 768 --height 768 \
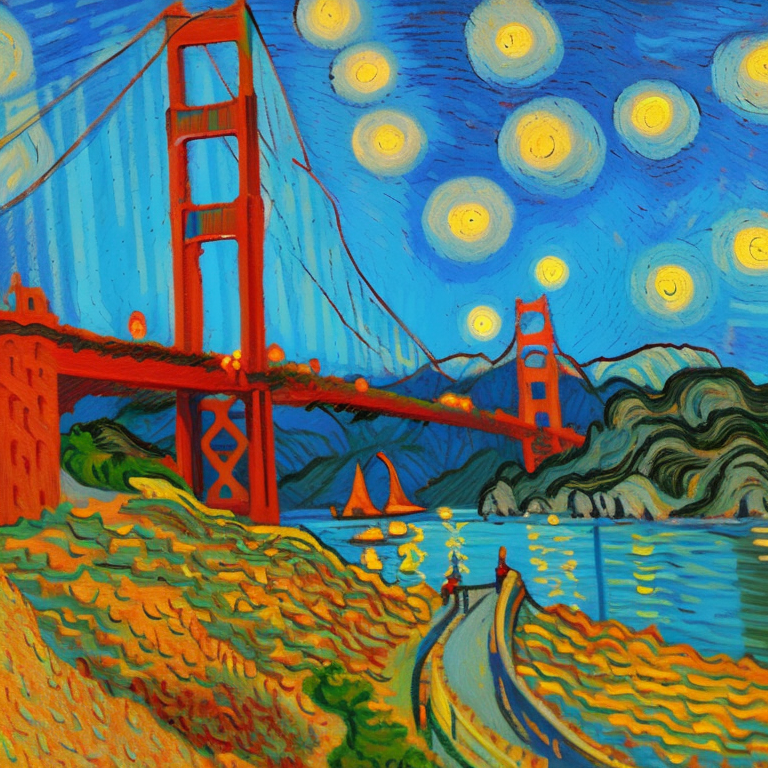
--prompt "A Van Gogh-inspired landscape painting of Golden Gate Bridge, capturing the swirling brushstrokes\
 and vibrant colors characteristic of the artist's style."
生成的图像保存在 AITemplate/examples/05_stable_diffusion/ 文件夹中,文件名为 example_ait.png。
以上梵高风格的提示语会生成一幅图像。
你还可以尝试以下提示语:
-
"森林中的房子,黑夜,空气中漂浮的叶子,荧光蘑菇,清晰的焦点,非常连贯,非常详细,对比鲜明,活力四射,数字绘图"
-
"一幅写实的人像画,背景是郁郁葱葱的绿色植被,一位年轻女子有着飘逸的红发和明亮的绿色眼睛,温暖地微笑。"
-
"一幅经典的油画,描绘了盛大的宴会场景,贵族和女士穿着精美的服装,在吊灯柔和的光辉下宴饮。"
-
"像素艺术风格的繁忙赛博朋克都市景观,霓虹灯照亮摩天大楼,立体广告投射出鲜艳的光芒。"