引言:
损失函数(Loss Function)是机器学习和深度学习中非常重要的一个概念。用于衡量模型的预测值与真实值之间的差异,从而指导模型优化其参数以最小化这种差异。
一、损失函数作用
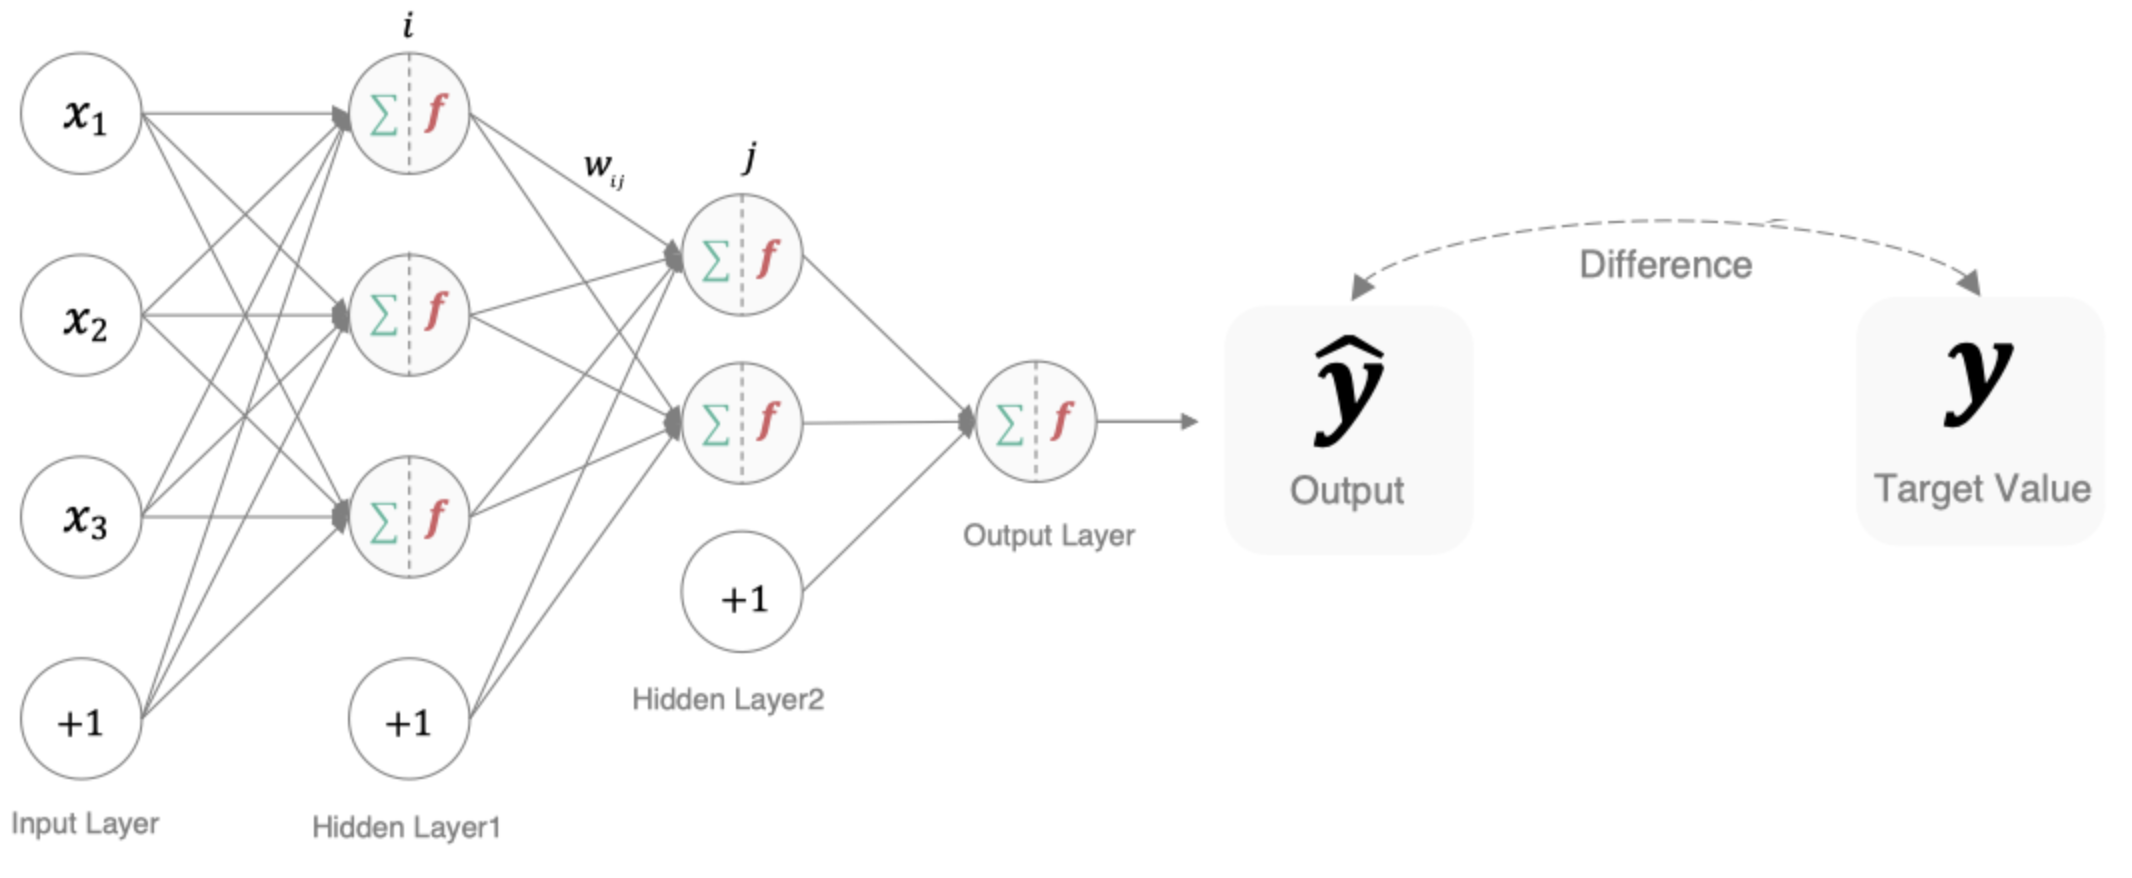
- 量化误差:损失函数是将预测值和真实值之间的差异转化为一个标量值。
- 优化目标:通过最小化损失函数,模型可以逐步调整参数以提高预测的准确性,用来优化模型参数。
- 评估模型性能:反映模型预测结果与目标值的匹配程度。
二、常见损失函数
1. 回归问题
| 损失函数 | 公式 | 特点 | 适用场景 |
|---|---|---|---|
| 均方误差(MSE) | L = 1 n ∑ i = 1 n ( y i − y ^ i ) 2 L = \frac{1}{n} \sum_{i=1}^{n} (y_i - \hat{y}_i)^2 L=n1∑i=1n(yi−y^i)2 | 放大误差,对离群点敏感 | 标准线性回归 |
| 平均绝对误差(MAE) | L = 1 n ∑ i = 1 n ∣ y i − y ^ i ∣ L = \frac{1}{n} \sum_{i=1}^{n} \vert y_i - \hat{y}_i\vert L=n1∑i=1n∣yi−y^i∣ | 抗噪强,优化不稳定 | 离群点多的回归 |
| Huber Loss | L = { 1 2 ( y i − y ^ i ) 2 if ∣ y i − y ^ i ∣ ≤ δ δ ∣ y i − y ^ i ∣ − 1 2 δ 2 其他 L = \begin{cases} \frac{1}{2}(y_i - \hat{y}_i)^2 & \text{if } \vert y_i - \hat{y}_i\vert \leq \delta \\ \delta \vert y_i - \hat{y}_i\vert - \frac{1}{2}\delta^2 & \text{其他} \end{cases} L={21(yi−y^i)2δ∣yi−y^i∣−21δ2if ∣yi−y^i∣≤δ其他 | 平衡 MAE 和 MSE | 鲁棒回归任务 |
| Log-Cosh Loss | L = ∑ log ( cosh ( y ^ − y ) ) L = \sum \log(\cosh(\hat{y} - y)) L=∑log(cosh(y^−y)) | 平滑的 MAE | 对离群点略鲁棒 |
2. 分类问题
| 损失函数 | 公式 | 特点 | 适用场景 |
|---|---|---|---|
| 交叉熵损失(Binary Cross Entropy) | L = − 1 n ∑ i = 1 n y i log ( y \^ i ) + ( 1 − y i ) log ( 1 − y \^ i ) L = -\frac{1}{n} \sum_{i=1}^{n} \left y_i \\log(\\hat{y}_i) + (1 - y_i) \\log(1 - \\hat{y}_i) \\right L=−n1∑i=1nyilog(y\^i)+(1−yi)log(1−y\^i) | 二分类 | 逻辑回归、二分类神经网络 |
| 交叉熵损失(Categorical Cross Entropy) | L = − 1 n ∑ i = 1 n ∑ j = 1 k y i j log ( y ^ i j ) L = -\frac{1}{n} \sum_{i=1}^{n} \sum_{j=1}^{k} y_{ij} \log(\hat{y}_{ij}) L=−n1∑i=1n∑j=1kyijlog(y^ij) | 多分类 | Softmax 输出 |
| 稀疏分类交叉熵(Sparse Categorical Cross Entropy) | 使用类索引而不是 one-hot | 节省内存 | 类别数较多 |
| Focal Loss | 添加调节因子处理样本不平衡 | 小样本分类 | 检测、医学图像分类 |
3. 其他问题
| 损失函数 | 应用 | 说明 |
|---|---|---|
| 相对熵(KL Divergence) | 分布拟合 | 常见于 NLP / VAE |
| Contrastive Loss | 度量学习 | Siamese 网络 |
| Triplet Loss | 排序学习 | 图像识别、人脸匹配 |
| CTC Loss | 序列对齐 | 语音识别、OCR 等 |
| Dice Loss / IoU Loss | 图像分割 | 非常常用于医学图像 |
三、如何选择损失函数
| 任务类型 | 输出形式 | 推荐损失函数 | PyTorch API |
|---|---|---|---|
| 回归(无离群) | 连续数值 | MSE | nn.MSELoss() |
| 回归(有离群) | 连续数值 | MAE / Huber | nn.L1Loss() / nn.HuberLoss() |
| 二分类 | 概率(Sigmoid) | Binary Cross Entropy | nn.BCELoss() / nn.BCEWithLogitsLoss() |
| 多分类 | 概率(Softmax) | Cross Entropy | nn.CrossEntropyLoss() |
| 多标签分类 | 多个 Sigmoid 输出 | nn.BCEWithLogitsLoss() |
多标签分类问题 |
| 图像分割 | 概率图 | Dice Loss / Cross Entropy | 自定义 Dice Loss |
| NLP(语言模型) | 词分布 | KL Divergence / CE | nn.KLDivLoss() / nn.CrossEntropyLoss() |
| 度量学习 | 特征嵌入 | Contrastive / Triplet | 自定义损失函数 |
四、举个🌰
python
import numpy as np

# 真实值和预测值
y_true = np.array([1.0, 2.0, 3.0])
y_pred = np.array([1.2, 1.8, 2.5])

# 1. 均方误差 (MSE)
mse = np.mean((y_true - y_pred) ** 2)
print(f"均方误差: {mse:.4f}")

# 2. 均绝对误差 (MAE)
mae = np.mean(np.abs(y_true - y_pred))
print(f"均绝对误差: {mae:.4f}")

# 3. Huber损失 (delta=1.0)
delta = 1.0
diff = np.abs(y_true - y_pred)
huber = np.mean(np.where(diff <= delta, 0.5 * diff ** 2, delta * diff - 0.5 * delta ** 2))
print(f"Huber损失: {huber:.4f}")

# 4. 二分类交叉熵 (假设y_true是0/1标签,y_pred是概率)
y_true_binary = np.array([0, 1, 1])
y_pred_binary = np.array([0.2, 0.8, 0.9])
cross_entropy = -np.mean(y_true_binary * np.log(y_pred_binary + 1e-10) +
                         (1 - y_true_binary) * np.log(1 - y_pred_binary + 1e-10))
print(f"二分交叉熵: {cross_entropy:.4f}")
log
均方误差: 0.1100
均绝对误差: 0.3000
Huber损失: 0.0550
二分交叉熵: 0.1839
五、总结
损失函数是机器学习和深度学习中不可或缺的一部分,合理选择和设计损失函数可以显著提高模型的性能。