KNN(K-近邻),全称K-Nearest Neighbors,是一种常用的分类算法 。
KNN算法的历史可以追溯到1957年 ,当时Cover和Hart提出了"最近邻分类"的概念。
但是,这个算法真正得到广泛认知和应用是在1992年 ,由Altman发表的一篇名为"K-Nearest Neighbors"的文章。
近年来,随着大数据和机器学习的快速发展,KNN算法因其简单且表现优秀,被广泛应用于各种数据分类问题中。
1. 算法概述
KNN算法的基本原理是:在特征空间中,如果一个样本的最接近的k个邻居 中大多数属于某一个类别,则该样本也属于这个类别。
换句话说,KNN算法假设类别是由其邻居决定的。
那么,KNN算法判断数据是否相似是关键,也就是数据之间的距离是如何计算的呢?
最常用的距离计算公式有:
- 曼哈顿距离:L1(xi,xj)=∑nl=1|x(l)i−x(l)j|L1(xi,xj)=∑l=1n|xi(l)−xj(l)|
- 欧氏距离:L2(xi,xj)=(∑nl=1|x(l)i−x(l)j|2)12L2(xi,xj)=(∑l=1n|xi(l)−xj(l)|2)12
- 闵可夫斯基距离:Lp(xi,xj)=(∑nl=1|x(l)i−x(l)j|2)1pLp(xi,xj)=(∑l=1n|xi(l)−xj(l)|2)1p
- 等等
使用不同的距离,就会得到不同的分类效果。
2. 创建样本数据
这次用scikit-learn中的样本生成器make_classification来生成分类用的样本数据。
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification

# 分类数据的样本生成器
X, y = make_classification(n_samples=1000, n_classes=4, n_clusters_per_class=1)
plt.scatter(X[:, 0], X[:, 1], marker="o", c=y, s=25)

plt.show()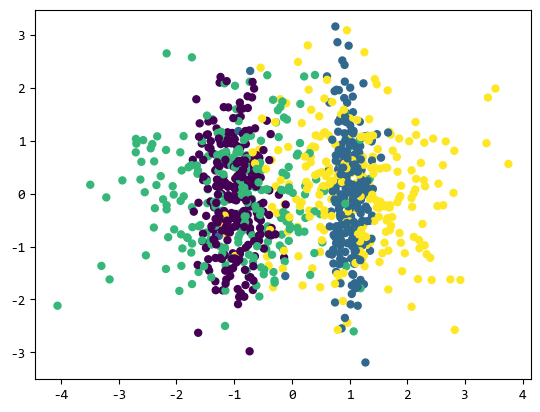
关于样本生成器 的详细内容,请参考:TODO
3. 模型训练
首先,分割训练集 和测试集。
from sklearn.model_selection import train_test_split

# 分割训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)这次按照8:2的比例来划分训练集和测试集。
然后用scikit-learn中的KNeighborsClassifier模型来训练:
from sklearn.neighbors import KNeighborsClassifier

# 定义KNN模型(设置4个分类,因为样本数据是4个分类)
reg = KNeighborsClassifier(n_neighbors=4)

# 训练模型
reg.fit(X_train, y_train)

# 在测试集上进行预测
y_pred = reg.predict(X_test)KNeighborsClassifier的主要参数包括:
- n_neighbors :这是
kNN算法中的k值 ,即选择最近的k个点。默认值为5。 - weights :此参数默认为'
uniform',也可以设置为'distance',或者用户自定义的函数。其中,'uniform'表示所有的邻近点的权重都是相等的,'distance'表示距离近的点比距离远的点的影响大。 - algorithm :此参数默认为'
auto',也可以设置为'auto','ball_tree','kd_tree',或'brute'。这决定了在计算最近邻时使用的算法。 - leaf_size:此参数默认为30,也可以设置为一个整数,用于指定传递给构建叶子节点时使用的最小样本数。
- p :此参数默认为2,也可以设置为一个值<=1。这决定了在计算
Minkowski距离度量时使用的p值。 - metric :此参数默认为'
minkowski',也可以设置为'euclidean','manhattan'等。这决定了距离度量方法。 - metric_params:此参数默认为None,也可以是一个字典,包含了额外的关键字参数传递给距离度量函数。
- n_jobs:此参数默认为None,也可以是一个大于等于1的整数,表示可用于执行并行计算的CPU数量。
最后验证模型的训练效果:
# 比较测试集中有多少个分类预测正确
correct_pred = np.sum(y_pred == y_test)

print("预测正确率:{}%".format(correct_pred/len(y_pred)*100))

# 运行结果
预测正确率:68.5%
模型使用了默认的参数,可以看出,模型正确率不高。
感兴趣的同学可以试试调整KNeighborsClassifier的参数,看看是否可以提高模型的预测正确率。
4. 总结
KNN算法被广泛应用于各种不同的应用场景,如图像识别、文本分类、垃圾邮件识别、客户流失预测等。
这些场景的一个共同特点是,需要对一个未知的样本进行快速的分类或预测。
KNN算法主要优势在于:
- 简单直观 :
KNN算法的概念简单直观,容易理解和实现。 - 适用于小样本数据 :
KNN算法在小样本数据上的表现往往优于其他机器学习算法。 - 对数据预处理要求较低 :
KNN算法不需要 对数据进行复杂的预处理,例如标准化、归一化等。
不过,KNN算法也有不足之处:
- 计算量大: 对于大型数据集,
KNN算法可能需要大量的存储空间和计算时间,因为需要计算每个样本与所有已知样本的距离。 - 选择合适的K值困难 :K值的选择对结果影响很大,选择不当可能会导致结果的不稳定。
- 对噪声数据敏感 :如果数据集中存在噪声数据,
KNN算法可能会受到较大影响。
关注灵活就业新业态,了解更多程序员兼职项目,关注公账号:贤才宝(贤才宝https://www.51xcbw.com)