前言
"结巴"中文分词:做最好的 Python 中文分词组件
上一篇文章讲了使用TF-IDF+分类器范式进行企业级文本分类的案例。其中提到了中文场景不比英文场景,在喂给模型之前需要进行分词操作。
分词的手段有很多,其中最常用的手段还是Jieba库进行分词。(大模型除外,大模型的因为分词对输入的token很重要,所以需要单独训练自己的Tokenizer)
下面这篇文章就来讲一讲Jieba分词的原理和使用吧~~
还是老规矩,从原理出发,并使用代码帮忙辅助理解。
(结巴说话就像在分词一样,不知道作者当初是不是这么想的起了个这个名字)
1.原理
官网上对Jieba分词的原理描述如下:
- 基于前缀词典实现高效的词图扫描,生成句子中汉字所有可能成词情况所构成的有向无环图(DAG)
- 采用动态规划查找最大概率路径,找出基于词频的最大切分组合
- 对于未登录词,采用了基于汉字成词能力的HMM模型,使用了Viterbi算法
是不是很抽象,完全不懂他在说啥。
So,I'm coming,我的作用就到了,就让我来给大家详细讲一下它到底是怎么回事吧
1.前缀词典(前缀树或Trie)
其中每个节点代表一个字符串的前缀。每个节点的字节点代表的字服饰该前缀的延伸。这样就可以高效的实现字符串集合的存储和查询操作,特别是前缀匹配。
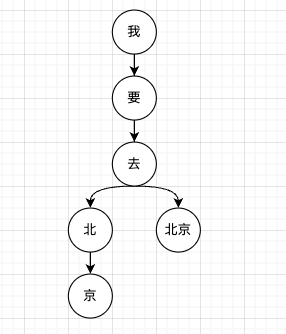
- 结构
- 根节点:不含字符,通常代表一个空字符串
- 边:从一个节点到另一个节点的变表示一个字符
- 节点:每个节点代表从根节点到当前节点的字符序列
- 叶子节点:完整的字符串
- 基本操作
- 插入(Insert):将一个字符串插入到 Trie 中。
- 搜索(Search):检查一个字符串是否存在于 Trie 中。
- 前缀匹配(Prefix Search):查找以某个前缀开头的所有字符串。
- 前缀树代码
字典树(Trie)是一种专门用于处理字符串集合的数据结构,尤其适用于前缀匹配操作
python
class TrieNode:
    def __init__(self):
        self.children = {}
        self.is_end_of_word = False

class Trie:
    def __init__(self):
        self.root = TrieNode()

    def insert(self, word):
        node = self.root
        for char in word:
            if char not in node.children:
                node.children[char] = TrieNode()
            node = node.children[char]
        node.is_end_of_word = True

    def search(self, word):
        node = self.root
        for char in word:
            if char not in node.children:
                return False
            node = node.children[char]
        return node.is_end_of_word

    def starts_with(self, prefix):
        node = self.root
        for char in prefix:
            if char not in node.children:
                return False
            node = node.children[char]
        return True

# 使用示例
trie = Trie()
trie.insert("apple")
print(trie.search("apple"))    # 输出: True
print(trie.search("app"))      # 输出: False
print(trie.starts_with("app")) # 输出: True
trie.insert("app")
print(trie.search("app")) # 输出: True- 有向图环图代码
是更通用的数据结构
python
class TrieNode:
    def __init__(self):
        self.children = {}
        self.is_end_of_word = False

class Trie:
    def __init__(self):
        self.root = TrieNode()

    def insert(self, word):
        node = self.root
        for char in word:
            if char not in node.children:
                node.children[char] = TrieNode()
            node = node.children[char]
        node.is_end_of_word = True

    def search(self, word):
        node = self.root
        for char in word:
            if char not in node.children:
                return False
            node = node.children[char]
        return node.is_end_of_word

def build_dag(sentence, trie):
    n = len(sentence)
    dag = {i: [] for i in range(n)}

    for i in range(n):
        node = trie.root
        j = i
        while j < n and sentence[j] in node.children:
            node = node.children[sentence[j]]
            if node.is_end_of_word:
                dag[i].append(j + 1)
            j += 1

    return dag

# 示例词典和句子
words = ["有", "资格", "讨论", "黑客", "精神", "技术", "工作者", "拒绝", "铜臭", "然后", "分享", "转", "强"]
trie = Trie()
for word in words:
    trie.insert(word)

sentence = "有资格讨论黑客精神的技术工作者首先是要拒绝铜臭然后是要分享技术。"
dag = build_dag(sentence, trie)

# 打印 DAG
for key in dag:
print(f'{key}: {dag[key]}')- 有向无环图和前缀树的区别
- 用途不同
- Trie 主要用于存储和快速查找字符串集合,适合前缀匹配。
- DAG 用于表示从起点到终点的所有可能路径,适合处理句子的所有分词路径
- 结构不同
- Trie 的结构是树形的,每个插入的字符串有一条唯一路径。
- DAG 的结构是图形的,允许多个路径表示不同的词组合。(允许一个节点有多条边指向多个节点)
- 用途不同
2.动态规划
- 定义概率模型 :对于每个词w ,定义其概率P(w )。通常,这个概率是基于词频统计得出 的: P(w) = 词w的频率 / 语料库中总词数
- 定义动态规划状态:定义 dpi表示从句子开始到第i个字的最大概率路径的概率
- 动态规划递推:从句子末尾向开头 遍历,对于每个位置i :dpi = max(P(w) * dpj) , 其中w是从 i 到 j 的词, j > i
- 记录最优路径: 在计算dpi的同时,记录导致最大概率的切分点j。这通常用一个route数组来存储。
- 回溯构建最优分词结果:从句首开始,根据route数组回溯,即可得到最优分词序列。
具体实现步骤:
- 初始化:dpn = 1 , n为句子长度 routen = n
- 从后向前遍历句子: for i in range(n-1, -1, -1): dpi = 0 for j in DAGi: # j是从i开始可能的词的结束位置 prob = P(sentencei:j+1) * dpj+1 if prob > dpi: dpi = prob routei = j
python
for i in range(n-1, -1, -1):
	dp[i] = 0
	for j in DAG[i]: # j是从i开始可能的词的结束位置
		prob = P(sentence[i:j+1]) * dp[j+1]
		if prob > dp[i]:
			dp[i] = prob
route[i] = j- 分词结果回溯:
python
i = 0
result = []
while i < n:
	j = route[i]
	result.append(sentence[i:j+1])
	i = j + 1
这种方法的优点是:
- 考虑了词的概率(频率),有利于选择更常见的词组合。
- 使用动态规划,避免了重复计算,提高了效率。
- 能够全局最优化,找到整个句子的最佳分词方案。
3.隐马尔可夫模型与维特比算法
这里比较难,鉴于HMM在NLP领域乃至整个人工智能领域的重要性,我会之后专门出一篇文章来进行详细说明。
这一步主要用于处理未登录词(Out-Of-Vocabulary, OOV),即在词典中没有出现的词。
1.HMM模型概述:
隐马尔可夫模型(Hidden Markov Model, HMM)在这里用于模拟汉字的成词能力。我们将词的边界视为隐藏状态,观察到的是汉字序列。
2.HMM的要素:
- 状态集合: S = {B, M, E, S}
B: 词的开头, M: 词的中间, E: 词的结尾, S: 单字成词 - 观察集合: O = {所有可能的汉字}
- 初始状态概率: π
- 状态转移概率: A
- 发射概率(观察概率): B
3.Viterbi算法:
用于找出最可能的隐藏状态序列,即最可能的分词方案。
4.具体实现步骤:
-
模型训练:
使用已分词的语料库 来估计HMM的参数 (π, A, B)。(Baum-Welch算法)
-
Viterbi算法实现:
a. 初始化:
对于每个字c_i和每个可能的状态s:
V 0 s = π s ∗ B s c 0 V0s = πs * Bsc_0 V0s=πs∗Bsc0
p a t h 0 s = s path0s = s path0s=sb. 递推:
对于t从1到T-1 (T是句子长度):
对于每个当前状态s:
V t s = m a x ( V t − 1 s ′ ∗ A s ′ s ∗ B s c t ) Vts = max(Vt-1s' * As's * Bsc_t) Vts=max(Vt−1s′∗As′s∗Bsct)
p a t h t s = p a t h t − 1 a r g m a x ( s ′ ) + s pathts = patht-1argmax(s') + s pathts=patht−1argmax(s′)+sc. 终止:
最优路径的概率 = m a x ( V T − 1 s ) max(VT-1s) max(VT−1s)
最优路径 = p a t h T − 1 a r g m a x ( s ) pathT-1argmax(s) pathT−1argmax(s)
-
根据最优路径进行分词:
将连续的BM*E序列或单独的S标记为一个词。
5.优点:
- 能够处理未登录词,提高分词系统的鲁棒性。
- 考虑了汉字的上下文信息,有助于提高分词准确性。
- Viterbi算法保证了在HMM模型假设下的全局最优解。
6.限制:
- HMM模型假设状态之间是马尔可夫的,这在实际语言中可能不总是成立。
- 需要大量已分词的语料库来训练模型参数。
- 对于非常罕见的字符组合,可能表现不佳。
4.综合示例:用"我要去北京"串联全流程
假设词典包含以下词及词频:
python
{"我": 1000, "要": 800, "去": 1500, "北京": 2000, "北": 500, "京": 300}步骤1:构建DAG
原始句子:0 1 2 3 4
          我 要 去 北 京
DAG构建过程:
位置0:"我"是词 → [1]
位置1:"要"是词 → [2]
位置2:"去"是词 → [3]
位置3:"北"是词 → [4]
         "北京"是词 → [5]
位置4:"京"是词 → [5]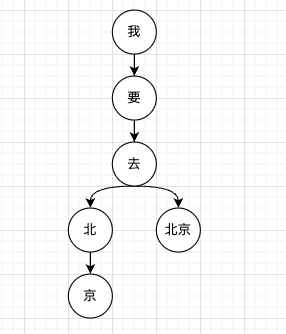
最终DAG:
0: [1]
1: [2]
2: [3]
3: [4,5]  # 既可以单独切分"北",也可以合并为"北京"
4: [5]
步骤2:动态规划计算
计算最大概率路径(假设总词频为10000):
dp[5] = 1
dp[4] = 300/10000 * 1 = 0.03
dp[3] = max(
    500/10000 * dp[4] = 0.0015,
    2000/10000 * dp[5] = 0.2
) → 0.2
dp[2] = 1500/10000 * dp[3] = 0.03
dp[1] = 800/10000 * dp[2] = 0.0024
dp[0] = 1000/10000 * dp[1] = 0.00024
最优路径回溯:
0→1→2→3→5 → 分词为 ["我", "要", "去", "北京"]步骤3:HMM处理未登录词
假设现在有个句子:"我要去清华"("清华"不在词典中)
HMM模型通过以下状态序列判断:
汉 字: 清  华
HMM状态: B  E  # 组成双字词
概率计算:
P(清|B) * P(华|E) * P(B→E) > P(清|S) * P(华|S)
最终切分为 ["我", "要", "去", "清华"]
5.关键点总结
-
词典优先:先用前缀词典找到所有可能的词组合
-
概率最优:通过动态规划选择全局最优的常见词组合
-
容错机制:HMM处理词典未覆盖的新词,保证对未知词汇的处理能力
-
效率平衡:Trie提升查找效率,动态规划避免重复计算,HMM仅在必要时触发
2.实践应用
1.精确模式分词
python
import jieba

text = "结巴分词是一个很好用的中文分词工具"
words = jieba.cut(text, cut_all=False)
print("精确模式:" + "/".join(words))
# 输出:
# 精确模式:结巴/分词/是/一个/很/好/用/的/中文/分词/工具
2.全模式分词
python
words = jieba.cut(text, cut_all=True)
print("全模式:" + "/".join(words))
# 输出:
# 全模式:结巴/分词/是/一个/很/好/用/的/中文/分词/工具
3.搜索引擎模式
python
words = jieba.cut_for_search(text)
print("搜索引擎模式:" + "/".join(words))
# 输出:
# 搜索引擎模式:结巴/分词/是/一个/很/好/用/的/中文/分词/工具
4.添加自定义词典
python
import os

with open("user_dict.txt", "w", encoding="utf-8") as f:
    f.write("结巴分词 100\n")
    f.write("自然语言处理 100")

jieba.load_userdict("user_dict.txt")
# user_dict.txt 文件内容示例:
# 结巴分词 n
# 自然语言处理 n

text = "结巴分词在自然语言处理中非常有用"
words = jieba.cut(text)
print("使用自定义词典:" + "/".join(words))
# 输出: 使用自定义词典:结巴分词/在/自然语言处理/中/非常/有用
5.词性标注
python
import jieba.posseg as pseg

words = pseg.cut(text)
for word, flag in words:
    print(f"{word} {flag}")
# 输出:
# 结巴分词 x
# 在 p
# 自然语言处理 x
# 中 f
# 非常 d
# 有用 v
6.TF-IDF分析(Term Frequency-Inverse Document Frequency)
python
from jieba import analyse

text = "结巴分词是一个很好用的中文分词工具,对中文自然语言处理很有帮助"
tfidf = analyse.extract_tags(text, topK=5, withWeight=True)
for word, weight in tfidf:
    print(f"{word} {weight}")
# 输出:
# 中文 2.0370262532875
# 结巴分词 1.4943459378625
# 自然语言处理 1.4943459378625
# 分词 1.462931634325
# 工具 0.764681704455
7.获取词语位置信息
python
result = jieba.tokenize(text)
for tk in result:
    print("word %s\t\t start: %d \t\t end:%d" % (tk[0], tk[1], tk[2]))

# word 结巴分词		 start: 0 		 end:4
# word 是		 start: 4 		 end:5
# word 一个		 start: 5 		 end:7
# word 很		 start: 7 		 end:8
# word 好		 start: 8 		 end:9
# word 用		 start: 9 		 end:10
# word 的		 start: 10 		 end:11
# word 中文		 start: 11 		 end:13
# word 分词		 start: 13 		 end:15
# word 工具		 start: 15 		 end:17
# word ,		 start: 17 		 end:18
# word 对		 start: 18 		 end:19
# word 中文		 start: 19 		 end:21
# word 自然语言处理		 start: 21 		 end:27
# word 很		 start: 27 		 end:28
# word 有		 start: 28 		 end:29
# word 帮助		 start: 29 		 end:31
3.总结和展望
在这篇文章中,我们十分深入的理解了什么是结巴分词,从最底层的原理出发,利用代码进行辅助,并用一个例子将整个内容串起来。最后还有对Jieba库的一个简单说明。
相信大家在度过这篇文章之后,应该对Jieba分词不再陌生了吧。
思考题🤔
- 结巴分词的时间复杂度是多少呢?为什么企业中还是这么热衷于结巴分词呢?
下期预告🚀
1.最早的预训练语言模型W2C及其变体