强化学习(Reinforcement Learning, RL)和深度学习(Deep Learning, DL)是人工智能领域两个重要的研究方向,虽然二者可以结合(如深度强化学习),但其核心思想、目标和应用场景存在本质区别。
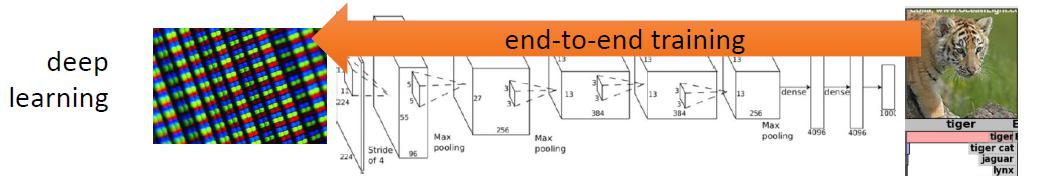
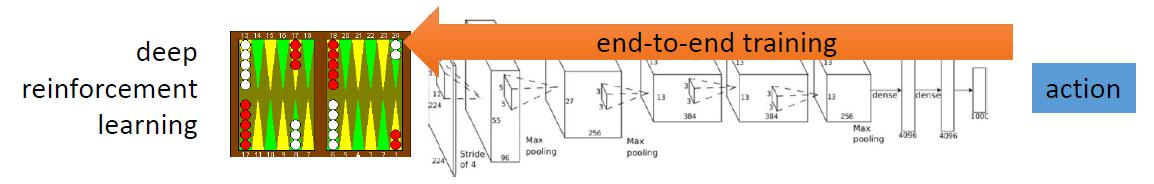
1. 定义与核心目标
| 维度 | 强化学习 | 深度学习 |
|---|---|---|
| 核心定义 | 面向决策的交互学习:通过与环境的试错交互,学习最大化长期奖励的最优策略。 | 面向模式的表示学习:通过多层神经网络从数据中提取特征,完成分类、回归等任务。 |
| 核心目标 | 学习一个策略(Policy),指导智能体在动态环境中做出最优决策。 | 学习一个函数(Function),从输入数据到输出标签的映射(如分类、生成)。 |
2. 数据依赖与交互性
| 维度 | 强化学习 | 深度学习 |
|---|---|---|
| 数据来源 | 数据通过智能体与环境的实时交互产生(如游戏中的动作序列)。 | 依赖预先收集的静态数据集(如ImageNet图像库)。 |
| 数据标签 | 无显式标签,通过奖励信号(Reward)间接反馈动作质量。 | 需要明确的监督标签(如分类任务的类别标签)。 |
| 数据动态性 | 数据分布随策略改变而动态变化(非独立同分布)。 | 假设数据独立同分布,分布固定。 |
3. 训练机制对比
| 维度 | 强化学习 | 深度学习 |
|---|---|---|
| 优化目标 | 最大化累积奖励期望值 | 最小化损失函数 |
| 反馈机制 | 延迟反馈:奖励可能仅在多步动作后获得(如围棋终局的胜负)。 | 即时反馈:每个输入样本都有对应的标签或损失值。 |
| 探索与利用 | 必须平衡探索(尝试新动作)和利用(选择已知最优动作)。 | 无需显式探索,数据分布由数据集决定。 |
4. 算法与模型结构
| 维度 | 强化学习 | 深度学习 |
|---|---|---|
| 典型算法 | Q-Learning、策略梯度(PG)、Actor-Critic、PPO、DQN | 卷积神经网络(CNN)、循环神经网络(RNN)、Transformer、生成对抗网络(GAN) |
| 模型角色 | 策略(Policy)或价值函数(Value Function)的表示工具。 | 直接作为端到端的预测或生成模型。 |
| 输入输出 | 输入:环境状态(State); 输出:动作(Action)或动作价值(Q-Value)。 | 输入:原始数据(如图像、文本); 输出:标签、特征或生成内容。 |
5. 典型应用场景
| 强化学习 | 深度学习 |
|---|---|
| 游戏AI(AlphaGo、Dota 2 Bot) | 图像分类(ResNet)、目标检测(YOLO) |
| 机器人控制(机械臂抓取、双足行走) | 自然语言处理(BERT、GPT) |
| 自动驾驶(路径规划、决策系统) | 语音识别(WaveNet)、图像生成(Stable Diffusion) |
| 资源调度(5G网络优化、计算集群任务分配) | 医疗影像分析、推荐系统 |
6. 核心挑战对比
| 强化学习 | 深度学习 |
|---|---|
| 稀疏奖励:关键动作的奖励信号可能极少(如迷宫探索)。 | 数据依赖:需要大量标注数据。 |
| 探索效率:高维动作空间下的采样复杂度高。 | 过拟合风险:模型复杂时易记忆训练数据。 |
| 非平稳环境:策略变化导致环境反馈分布偏移。 | 可解释性差:黑箱模型难以追溯决策逻辑。 |
7. 两者结合:深度强化学习(DRL)
将深度学习作为强化学习的函数近似器,解决传统RL在高维状态/动作空间下的局限性:
- 经典算法:DQN(深度Q网络)、DDPG(深度确定性策略梯度)
- 核心思想 :用深度神经网络替代Q表或线性策略,例如:
Q(s,a;θ)≈神经网络(s)→a的价值 - 应用场景:Atari游戏(像素输入→动作决策)、机器人仿真控制。
总结
- 强化学习 是动态决策引擎,关注"在未知环境中如何行动";
- 深度学习 是静态模式提取器,关注"如何从数据中抽象特征";
- 深度强化学习则结合二者优势,实现"从高维感知到复杂决策"的端到端学习。