Spark-Streaming核心编程

  1. Kafka数据源的两种API对比

ReceiverAPI:在早期版本中使用,需专门的Executor接收数据再发送给其他Executor计算。由于接收和计算的Executor速度可能不同,当接收速度大于计算速度时,计算节点易出现内存溢出问题,当前版本已不适用。

DirectAPI:由计算的Executor主动消费Kafka数据,速度可自行控制。

  1. Kafka 0-10 Direct模式实践

需求:利用SparkStreaming从Kafka读取数据,进行简单计算后打印到控制台。

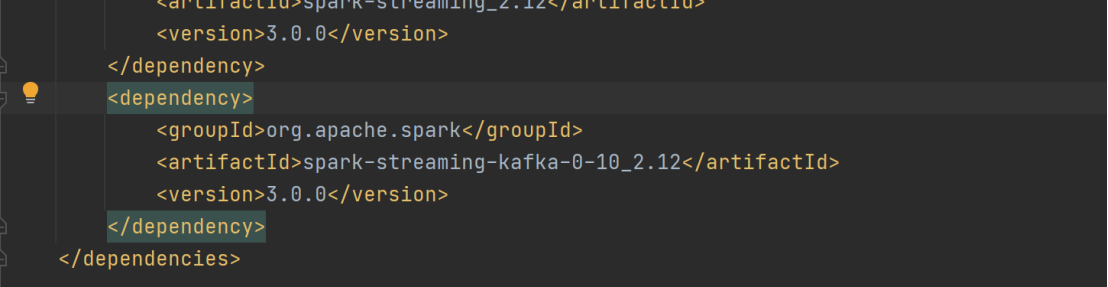
导入依赖:添加 org.apache.spark:spark - streaming - kafka - 0 - 10_2.12:3.0.0 依赖,为后续代码实现提供支持。
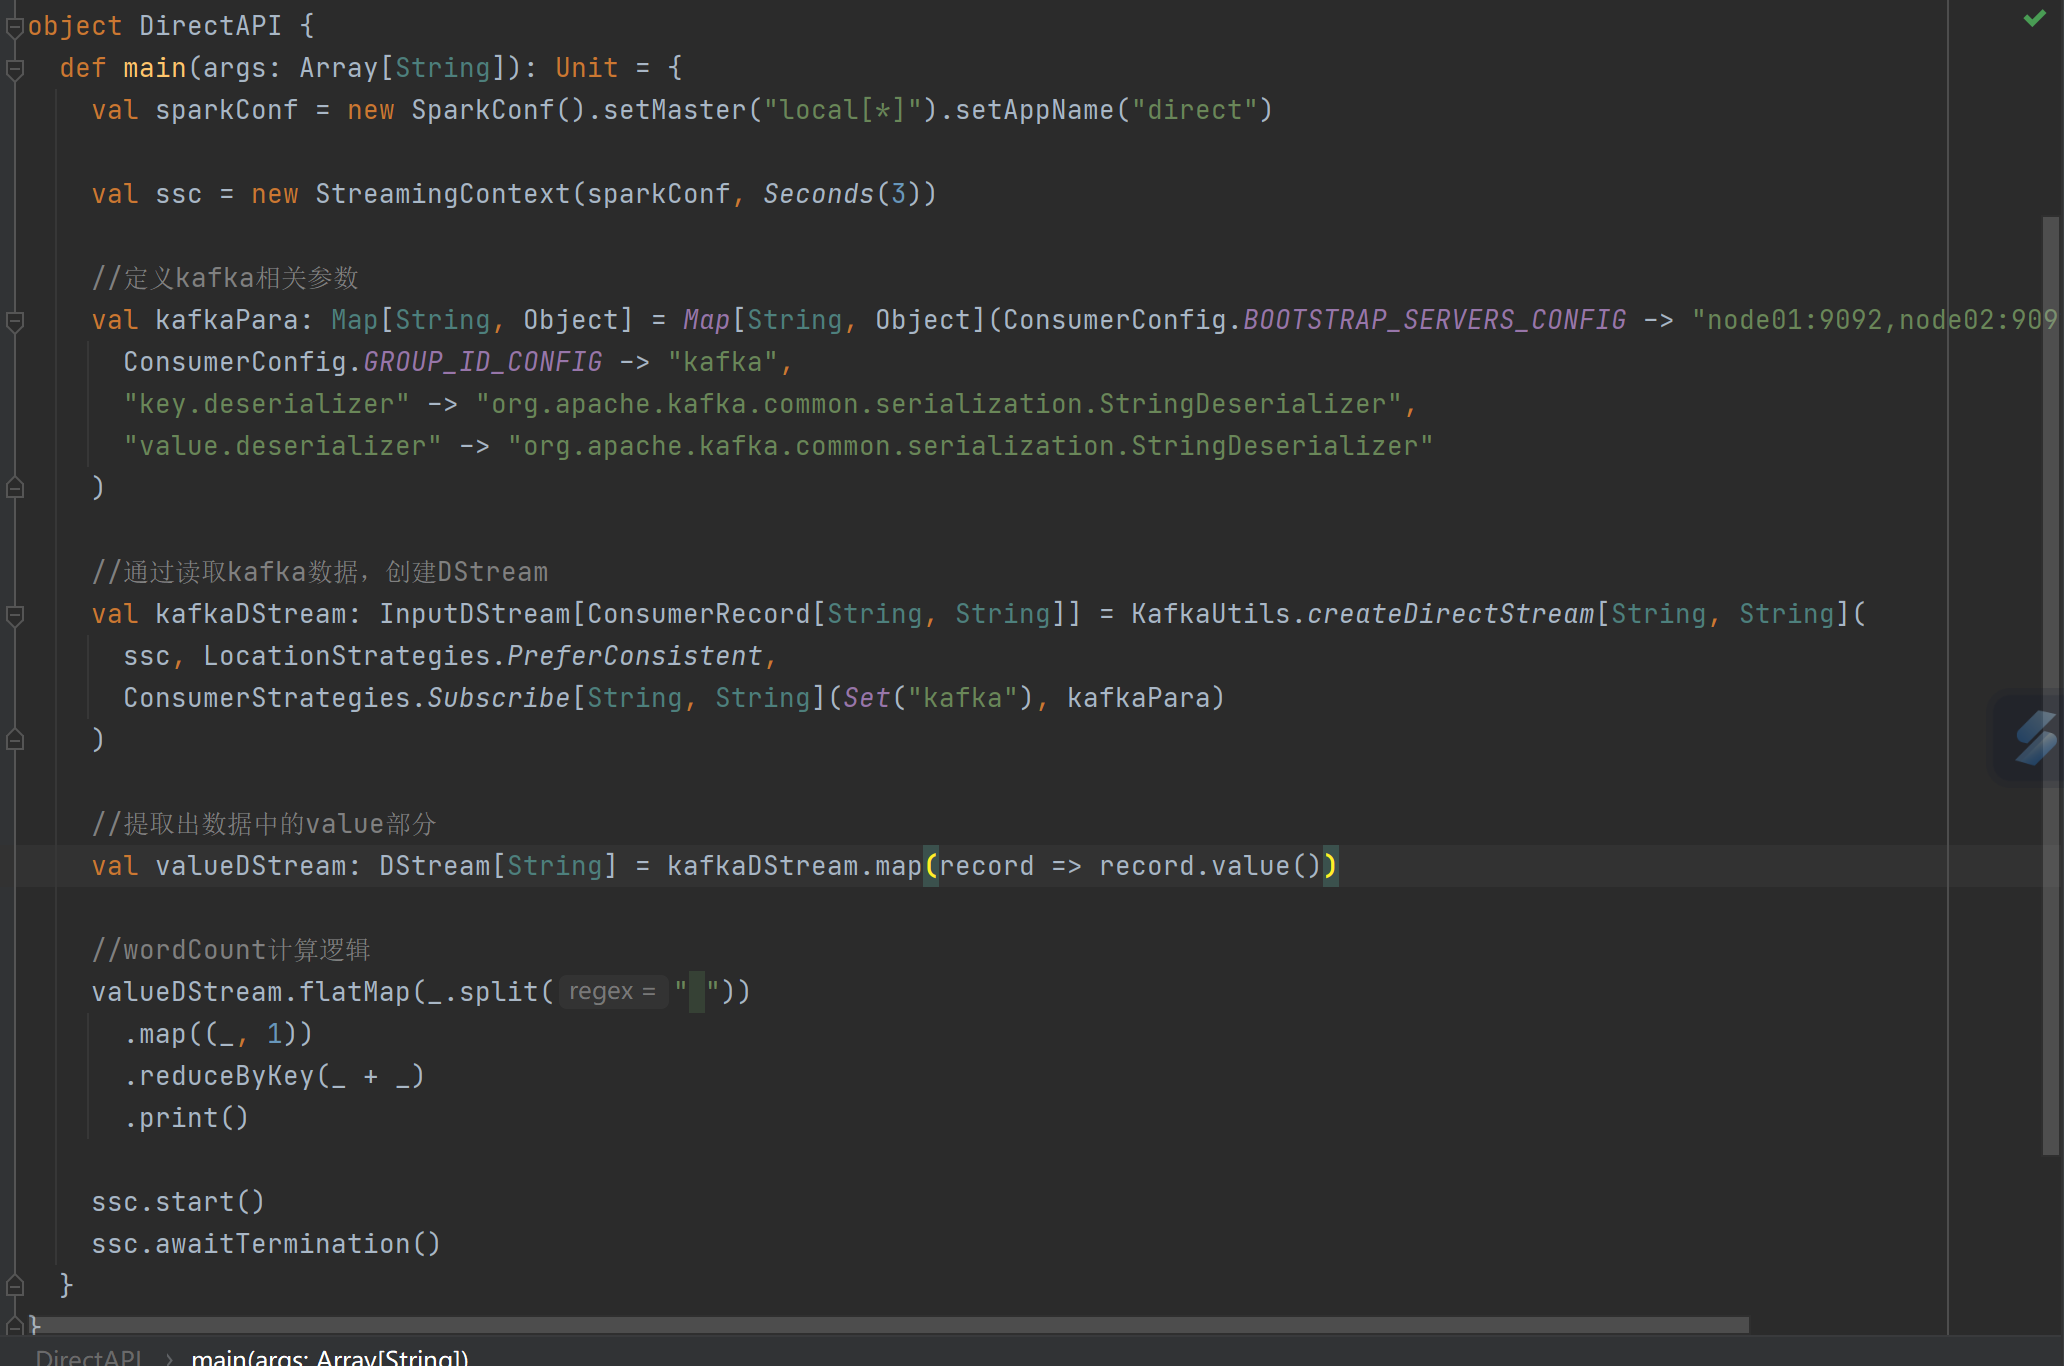
代码编写:创建SparkConf和StreamingContext,设置相关参数。定义Kafka参数,通过KafkaUtils.createDirectStream读取Kafka数据创建DStream,提取数据中的value部分,进行wordCount计算并打印结果,最后启动StreamingContext等待终止。
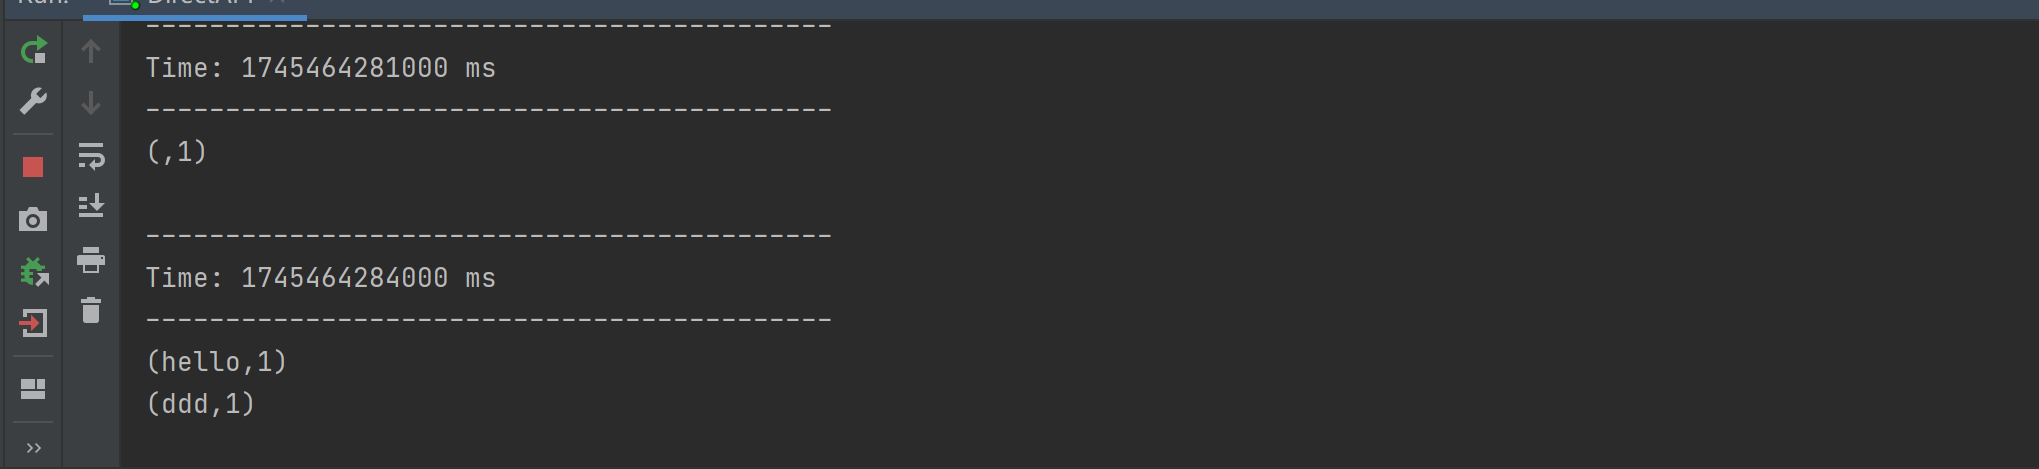
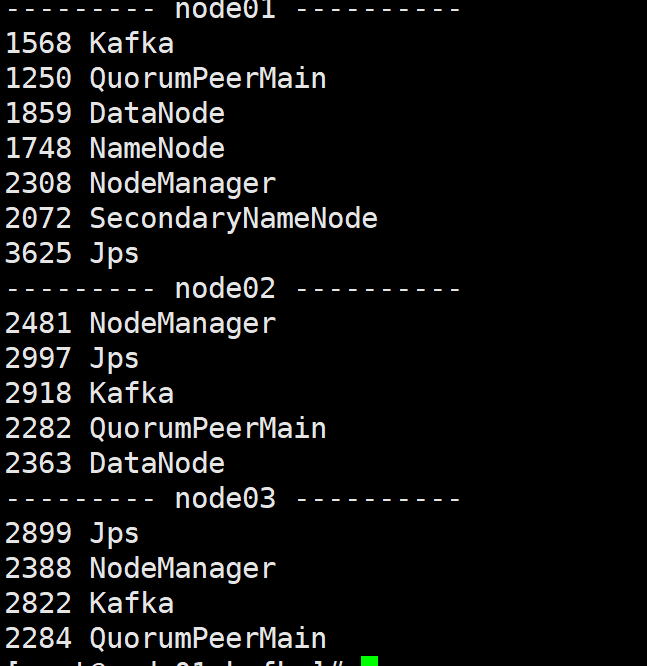
环境准备与操作流程:开启Kafka集群;使用 kafka - console - producer.sh 启动Kafka生产者并向指定topic发送数据;运行程序处理Kafka生产的数据;通过 kafka - consumer - groups.sh 查看消费进度,可了解数据消费情况。

相关推荐
派小心.17 分钟前
网站统计采样数据的误差核对
大数据·服务器·前端·数据库·人工智能·小程序·数据分析
阿里云大数据AI技术43 分钟前
在 EMR Serverless Spark 中访问 Fluss
人工智能·spark
JAVA_AI人工智能项目实战1 小时前
大模型结构演进.学习笔记
大数据·人工智能·语言模型·架构
donk13141 小时前
React Native for OpenHarmony 实战:三方库 react-native-step-indicator 的鸿蒙化适配指南
分布式·react native·react.js·wpf·harmonyos
古法老登瞎折腾1 小时前
大数据智能运维实战(二):准备一个可复现的运维实验环境
java·大数据·运维·spring ai·mcp
数字新视界1 小时前
机房动环监控助力智能管理
大数据·服务器·数据库·动环监控系统·动力与环境监控系统
坐吃山猪2 小时前
ES08-ES使用IK分词器
大数据·elasticsearch·搜索引擎
泡干脆面就番茄3 小时前
Hive-DML:Load-Insert-Export-Import四种数据进出方式
大数据·数据仓库·hive·hadoop
加百力3 小时前
沪指险守3700点,券商、银行午后发力,创业板跌近3%,半导体尾盘反扑,恒科指跌3%,科网股普跌
大数据
eBest数字化转型方案3 小时前
快消渠道 AI 落地路线:拍照、数据、决策三阶段的工程逻辑
大数据·人工智能