一、Spark概念:
Spark 是一种基于内存的快速、通用、可扩展的大数据分析计算引擎。
1、 Spark and Hadoop 的关系
(1)首先从时间节点上来看:
➢Hadoop
- 2006 年 1 月,Doug Cutting 加入 Yahoo,领导 Hadoop 的开发
- 2008 年 1 月,Hadoop 成为 Apache 顶级项目
- 2011 年 1.0 正式发布
- 2012 年 3 月稳定版发布
- 2013 年 10 月发布 2.X (Yarn)版本
➢Spark
- 2009 年,Spark 诞生于伯克利大学的 AMPLab 实验室
- 2010 年,伯克利大学正式开源了 Spark 项目
- 2013 年 6 月,Spark 成为了 Apache 基金会下的项目
- 2014 年 2 月,Spark 以飞快的速度成为了 Apache 的顶级项目
- 2015 年至今,Spark 变得愈发火爆。
(2)从功能上来看:
➢Hadoop
- Hadoop 是由 java 语言编写的,在分布式服务器集群上存储海量数据并运行分布式分析应用的开源框架
- 作为 Hadoop 分布式文件系统,HDFS 处于 Hadoop 生态圈的最下层,存储着所有的数据,支持着 Hadoop 的所有服务。它的理论基础源于 Google 的
- TheGoogleFileSystem 这篇论文,它是 GFS 的开源实现。
- MapReduce 是一种编程模型,Hadoop 根据 Google 的 MapReduce 论文将其实现,作为 Hadoop 的分布式计算模型,是 Hadoop 的核心。基于这个框架,分布式并行程序的编写变得异常简单。综合了 HDFS 的分布式存储和 MapReduce 的分布式计算,Hadoop 在处理海量数据时,性能横向扩展变得非常容易。
- HBase 是对 Google 的 Bigtable 的开源实现,但又和 Bigtable 存在许多不同之处。
- HBase 是一个基于 HDFS 的分布式数据库,擅长实时地随机读/写超大规模数据集。
➢Spark
- Spark 是一种由 Scala 语言开发的快速、通用、可扩展的大数据分析引擎
- Spark Core 中提供了 Spark 最基础与最核心的功能
- Spark SQL 是 Spark 用来操作结构化数据的组件。通过 Spark SQL,用户可以使用SQL 或者 Apache Hive 版本的 SQL 方言(HQL)来查询数据。
- Spark Streaming 是 Spark 平台上针对实时数据进行流式计算的组件,提供了丰富的处理数据流的 API。
总结:Spark 出现的时间相对较晚,并且主要功能主要是用于数据计算,所以其实 Spark 一直被认为是 Hadoop 框架的升级版。
2、Spark or Hadoop
- Hadoop MapReduce 由于其设计初衷并不是为了满足循环迭代式数据流处理,因此在多并行运行的数据可复用场景(如:机器学习、图挖掘算法、交互式数据挖掘算法)中存在诸多计算效率等问题。所以 Spark 应运而生,Spark 就是在传统的 MapReduce 计算框架的基础上,利用其计算过程的优化,从而大大加快了数据分析、挖掘的运行和读写速度,并将计算单元缩小到更适合并行计算和重复使用的 RDD 计算模型。
- 机器学习中 ALS、凸优化梯度下降等。这些都需要基于数据集或者数据集的衍生数据反复查询反复操作。MR 这种模式不太合适,即使多 MR 串行处理,性能和时间也是一个问题。数据的共享依赖于磁盘。另外一种是交互式数据挖掘,MR 显然不擅长。而Spark 所基于的 scala 语言恰恰擅长函数的处理。
- Spark 是一个分布式数据快速分析项目。它的核心技术是弹性分布式数据集(Resilient Distributed Datasets),提供了比 MapReduce 丰富的模型,可以快速在内存中对数据集进行多次迭代,来支持复杂的数据挖掘算法和图形计算算法。
- Spark和Hadoop的根本差异是多个作业之间的数据通信问题 : Spark多个作业之间数据通信是基于内存,而 Hadoop 是基于磁盘。
- Spark Task 的启动时间快。Spark 采用 fork 线程的方式,而 Hadoop 采用创建新的进程的方式。
- Spark 只有在 shuffle 的时候将数据写入磁盘,而 Hadoop 中多个 MR 作业之间的数据交互都要依赖于磁盘交互
- Spark 的缓存机制比 HDFS 的缓存机制高效。
二、Spark核心模块
- Spark Core :Spark Core 中提供了 Spark 最基础与最核心的功能,Spark 其他的功能如:Spark SQL,
- Spark Streaming,GraphX, MLlib 都是在 Spark Core 的基础上进行扩展的
- Spark SQL :Spark SQL 是 Spark 用来操作结构化数据的组件。通过 Spark SQL,用户可以使用 SQL 或者 Apache Hive 版本的 SQL 方言(HQL)来查询数据。
- Spark Streaming :Spark Streaming 是 Spark 平台上针对实时数据进行流式计算的组件,提供了丰富的处理数据流的 API。
- Spark MLlib :MLlib 是 Spark 提供的一个机器学习算法库。MLlib 不仅提供了模型评估、数据导入等额外的功能,还提供了一些更底层的机器学习原语。
- Spark GraphX :GraphX 是 Spark 面向图计算提供的框架与算法库。
三、Spark的运行模式
Spark 作为一个数据处理框架和计算引擎,被设计在所有常见的集群环境中运行, 在国内工作中主流的环境为 Yarn,不过逐渐容器式环境也慢慢流行起来。接下来,我们就分别看看不同环境下 Spark 的运行。
1、Local 模式
所谓的 Local 模式,就是不需要其他任何节点资源就可以在本地执行 Spark 代码的环境,一般用于教学,调试,演示等。
2、Standalone 模式
local 本地模式主要用于练习演示,真实工作中应用需提交到集群执行。接着介绍只使用 Spark 自身节点运行的独立部署(Standalone)模式,该模式体现经典的 master-slave 模式,并展示了集群规划,即 Linux1、Linux3 节点为 Worker,Linux2 节点为 Master 。
3、Yarn 模式
Spark 的独立部署模式由其自身提供计算资源,无需依赖其他框架,降低了与第三方资源框架的耦合性,独立性强。不过,Spark 主要是计算框架,资源调度并非其优势,与专业资源调度框架集成更可靠,国内工作中 Yarn 使用较为普遍。
4、K8S & Mesos 模式
Mesos 是 Apache 下的开源分布式资源管理框架,被称作分布式系统的内核,在 Twitter 广泛应用,管理着超 30 万台服务器上的应用部署。国内仍多使用传统 Hadoop 大数据框架,故 Mesos 框架使用较少,但两者原理相近。
5、Windows 模式
同学们自学时,启动虚拟机与集群过程繁琐,且占用大量系统资源,导致系统运行缓慢,影响学习效果与进度。而 Spark 提供了在 Windows 系统下启动本地集群的方式,使得学习者无需借助虚拟机,就能学习 Spark 基本使用 。
6、部署模式对比
模式 Spark 安装机器数 需启动的进程 所属者 应用场景
Local 1 无 Spark 测试
Standalone 3 Master 及 Worker Spark 单独部署
Yarn 1 Yarn 及 HDFS Hadoop 混合部署
7、端口号
➢Spark 查看当前 Spark-shell 运行任务情况端口号:4040(计算)
➢Spark Master 内部通信服务端口号:7077
➢Standalone 模式下,Spark Master Web 端口号:8080(资源)
➢Spark 历史服务器端口号:18080
➢Hadoop YARN 任务运行情况查看端口号:8088
四、Spark运行架构
1、运行架构:Spark 框架的核心是一个计算引擎,整体来说,它采用了标准 master-slave 的结构。
2、核心组件:对于 Spark 框架有两个核心组件:
(1)Driver
Spark 驱动器节点,用于执行 Spark 任务中的 main 方法,负责实际代码的执行工作。
Driver 在 Spark 作业执行时主要负责:
➢ 将用户程序转化为作业(job)
➢ 在 Executor 之间调度任务(task)
➢ 跟踪 Executor 的执行情况
➢ 通过 UI 展示查询运行情况
实际上,我们无法准确地描述 Driver 的定义,因为在整个的编程过程中没有看到任何有关Driver 的字眼。所以简单理解,所谓的 Driver 就是驱使整个应用运行起来的程序,也称之为Driver 类。
(2)Executor
Spark Executor 是集群中工作节点(Worker)中的一个 JVM 进程,负责在 Spark 作业中运行具体任务(Task),任务彼此之间相互独立。Spark 应用启动时,Executor 节点被同时启动,并且始终伴随着整个 Spark 应用的生命周期而存在。如果有 Executor 节点发生了故障或崩溃,Spark 应用也可以继续执行,会将出错节点上的任务调度到其他 Executor 节点上继续运行。
Executor 有两个核心功能:
- 负责运行组成 Spark 应用的任务,并将结果返回给驱动器进程
- 它们通过自身的块管理器(Block Manager)为用户程序中要求缓存的 RDD 提供内存式存储。RDD 是直接缓存在 Executor 进程内的,因此任务可以在运行时充分利用缓存数据加速运算。
3、在 Spark 集群独立部署环境中,Master 和 Worker 是核心组件。Master 作为进程,负责资源调度分配与集群监控,类似 Yarn 中的 ResourceManager(RM);Worker 也是进程,运行于集群服务器,由 Master 分配资源进行数据并行处理计算,类似 Yarn 中的 NodeManager(NM)。在 Hadoop 向 YARN 集群提交应用程序时,ApplicationMaster 是必备部分,它用于向资源调度器申请资源容器,运行任务、监控任务执行、跟踪任务状态及处理异常,实现了 ResourceManager(资源)和 Driver(计算)之间的解耦合 。
五、核心概念
该段文本主要介绍了Spark相关的概念和流程:
- Executor 与 Core:Spark Executor是工作节点中用于计算的JVM进程,提交应用时可指定计算节点个数及资源(内存和虚拟CPU核数量)。
2.并行度(Parallelism):分布式计算框架中多个任务同时执行,真正实现多任务并行,集群并行执行任务的数量即并行度,取决于框架默认配置,应用程序也可动态修改。
3.有向无环图(DAG):大数据计算引擎框架分四类,Hadoop的MapReduce将计算分Map和Reduce阶段,上层应用拆分算法困难,催生了支持DAG的框架(第二代计算引擎如Tez、Oozie,多为批处理任务),以Spark为代表的第三代计算引擎支持Job内部DAG及实时计算。DAG是由Spark程序映射成的数据流高级抽象模型,可表示程序拓扑结构,是有方向且不会闭环的由点和线组成的拓扑图形。
4.提交流程:开发人员写的应用程序通过Spark客户端提交给Spark运行环境执行计算的流程,不同部署环境提交过程基本相同有细微区别,国内更多将Spark应用部署到Yarn环境,这里提交流程基于Yarn环境。
5、Yarn Client模式中,用于监控和调度的Driver模块在客户端运行,常用于测试。具体流程为:Driver在任务提交的本地机器上启动,随后与ResourceManager通讯申请启动ApplicationMaster;ResourceManager分配container,在合适的NodeManager上启动ApplicationMaster,该Master向ResourceManager申请Executor内存;ResourceManager接到申请后分配container,ApplicationMaster在指定的NodeManager上启动Executor进程;Executor进程启动后反向向Driver注册,全部注册完成后Driver执行main函数;执行到Action算子时触发Job,依据宽依赖划分stage,生成TaskSet,再将task分发到各Executor上执行。
RDD相关概念
Spark 计算框架为了能够进行高并发和高吞吐的数据处理,封装了三大数据结构,用于处理不同的应用场景。三大数据结构分别是:
RDD : 弹性分布式数据集。累加器:分布式共享只写变量。广播变量:分布式共享只读变量
六、RDD
1、RDD:RDD(Resilient Distributed Dataset)叫做弹性分布式数据集,是 Spark 中最基本的数据处理模型。代码中是一个抽象类,它代表一个弹性的、不可变、可分区、里面的元素可并行计算的集合。
弹性
- 存储的弹性:内存与磁盘的自动切换;
- 容错的弹性:数据丢失可以自动恢复;
- 计算的弹性:计算出错重试机制;
- 分片的弹性:可根据需要重新分片。
- 分布式:数据存储在大数据集群不同节点上
- 数据集:RDD 封装了计算逻辑,并不保存数据
- 数据抽象:RDD 是一个抽象类,需要子类具体实现
- 不可变:RDD 封装了计算逻辑,是不可以改变的,想要改变,只能产生新的 RDD,在新的 RDD 里面封装计算逻辑
可分区、并行计算
2、核心属性
- 分区列表
RDD 数据结构中存在分区列表,用于执行任务时并行计算,是实现分布式计算的重要属性。
- 分区计算函数
Spark 在计算时,是使用分区函数对每一个分区进行计算。
- RDD 之间的依赖关系
RDD 是计算模型的封装,当需求中需要将多个计算模型进行组合时,就需要将多个 RDD 建立依赖关系。
- 分区器(可选)
当数据为 K-V 类型数据时,可以通过设定分区器自定义数据的分区。
- 首选位置(可选)
计算数据时,可以根据计算节点的状态选择不同的节点位置进行计算。
3、执行原理
从计算层面看,数据处理需计算资源(内存和CPU)与计算模型(逻辑),执
行时要协调整合二者。Spark框架执行时,先申请资源,再把应用程序的数据处理逻辑拆解为一个个计算任务,接着将任务发送到已分配资源的计算节点,依据指定计算模型进行数据计算,最终得出计算结果。
4、RDD 序列化
① 闭包检查:在Spark计算中,算子外代码在Driver端执行,算子内代码在Executor端执行,算子内常使用算子外数据形成闭包。若算子外数据无法序列化,就不能传给Executor执行会出错,所以执行任务前要检测闭包内对象能否序列化,此为闭包检测,且Scala2.12版本后闭包编译方式有变化。
② 序列化方法和属性:再次强调算子外代码在Driver端执行,算子内代码在Executor端执行。
③ Kryo序列化框架:Java序列化能处理任何类,但存在字节多、提交对象大的问题。出于性能考虑,Spark2.0开始支持Kryo序列化机制,其速度是Serializable的10倍。RDD在Shuffle数据时,简单数据类型、数组和字符串类型已在Spark内部用Kryo序列化,即便使用Kryo序列化,也需继承Serializable接口。
5、RDD 依赖关系
该段内容主要介绍了RDD的血缘关系、依赖关系、宽窄依赖、阶段和任务划分:
① RDD血缘关系:RDD支持粗粒度转换,通过记录创建RDD的一系列Lineage来保存元数据信息和转换行为,以便在部分分区数据丢失时重新运算和恢复数据。
② RDD依赖关系:指两个相邻RDD之间的关系,包括窄依赖和宽依赖等类型。
③ RDD窄依赖:每个父RDD的Partition最多被子RDD的一个Partition使用,可比喻为"独生子女"。
④ RDD宽依赖:同一个父RDD的Partition被多个子RDD的Partition依赖,会引发Shuffle,可比喻为"多生"。
⑤ RDD阶段划分:DAG有向无环图记录了RDD的转换过程和任务的阶段。
⑥ RDD任务划分:RDD任务切分包括Application(初始化SparkContext生成)、Job(一个Action算子生成一个)、Stage(数量等于宽依赖个数加1)、Task(一个Stage中最后一个RDD的分区个数),且Application->Job->Stage->Task每一层是1对n的关系。
6、创建RDD:在 Spark 中创建 RDD 的创建方式可以分为四种:
1)从集合(内存)中创建 RDD
2)从外部存储(文件)创建 RDD
由外部存储系统的数据集创建 RDD 包括:本地的文件系统,所有 Hadoop 支持的数据集, 比如 HDFS、HBase 等。
val fileRDD: RDDString = sparkContext.textFile("spark-core/input")
fileRDD.collect().foreach(println)
- 从其他 RDD 创建
主要是通过一个 RDD 运算完后,再产生新的 RDD。
- 直接创建 RDD(new)
使用 new 的方式直接构造 RDD,一般由 Spark 框架自身使用。
RDD并行度与分区
默认情况下,Spark 可以将一个作业切分多个任务(Task)后,发送给 Executor 节点并行计算,而能够并行计算的任务数量我们称之为并行度。这个数量可以在构建 RDD 时指定。记住,这里的并行执行的任务数量,并不是指的切分任务的数量
RDD转换算子:RDD 根据数据处理方式的不同将算子整体上分为 Value 类型、双 Value 类型和 Key-Value 类型。
七、Spark-SQL简介
1、Spark-SQL:
Spark SQL 是 Spark 用于结构化数据(structured data)处理的 Spark 模块。
- 背景:Hive是早期唯一运行在Hadoop上的SQL-on-Hadoop工具,但MapReduce计算因大量中间磁盘落地消耗I/O,效率低,催生了如Drill、Impala、Shark等SQL-on-Hadoop工具。Shark是伯克利实验室Spark生态组件,基于Hive开发,修改了内存管理、物理计划、执行模块,能运行在Spark引擎上,使SQL-on-Hadoop性能比Hive提高10-100倍。
- SparkSQL的产生:随着Spark发展,Shark对Hive依赖过多,制约了Spark组件集成,因此Spark团队提出SparkSQL项目。SparkSQL抛弃Shark原有代码,汲取其优点,如内存列存储、Hive兼容性等,重新开发。在数据兼容、性能优化、组件扩展方面优势明显,数据可从RDD、parquet文件、JSON文件获取,未来还支持RDBMS及NOSQL数据;性能上采用In-Memory Columnar Storage等技术,将引进Cost Model动态评估;组件方面语法解析器等都可重新定义扩展。
- Shark的结局:2014年6月1日Shark项目停止开发,团队资源转向SparkSQL项目,发展出SparkSQL和Hive on Spark两个支线。SparkSQL作为Spark生态一员,不再受限于Hive但兼容Hive;Hive on Spark是Hive发展计划,将Spark作为Hive底层引擎之一,Hive可采用多种引擎。
- SparkSQL的优势和编程抽象:对开发人员而言,SparkSQL可简化RDD开发,提高效率且执行快,实际工作中应用较多。其提供了DataFrame和DataSet两个编程抽象,类似Spark Core中的RDD。
2、Spark-SQL 特点
- 易整合。无缝的整合了 SQL 查询和 Spark 编程
- 统一的数据访问。使用相同的方式连接不同的数据源
- 兼容 Hive。在已有的仓库上直接运行 SQL 或者 HQL
- 标准数据连接。通过 JDBC 或者 ODBC 来连接
3、DataFrame:DataFrame是Spark中一种基于RDD的分布式数据集,具有以下特点:
类似二维表格且带Schema元信息:它类似于传统数据库中的二维表格,每一列都有名称和类型,如DataFrame清楚地知道数据集中包含哪些列及各列的名称和类型,而RDD无法得知所存数据元素的具体内部结构。
支持嵌套数据类型:与Hive类似,支持struct、array和map等嵌套数据类型。
API更友好:DataFrame API提供高层关系操作,比函数式的RDD API更友好,使用门槛更低。
懒执行且性能更高:与RDD一样是懒执行的,但性能比RDD高,因为其查询计划可通过Spark catalyst optimiser进行优化,能得到更优的执行计划。
4、DataSet 是什么
DataSet 是分布式数据集合。DataSet 是 Spark 1.6 中添加的一个新抽象,是 DataFrame 的一个扩展。它提供了 RDD 的优势(强类型,使用强大的 lambda 函数的能力)以及 Spark SQL 优化执行引擎的优点。DataSet 也可以使用功能性的转换(操作 map,flatMap,filter 等等)
➢ DataSet 是 DataFrame API 的一个扩展,是 SparkSQL 最新的数据抽象
➢ 用户友好的 API 风格,既具有类型安全检查也具有 DataFrame 的查询优化特性;
➢ 用样例类来对 DataSet 中定义数据的结构信息,样例类中每个属性的名称直接映射到 DataSet 中的字段名称;
➢ DataSet 是强类型的。比如可以有 DataSetCar,DataSetPerson。
➢ DataFrame 是 DataSet 的特列,DataFrame=DataSetRow ,所以可以通过 as 方法将 DataFrame 转换为 DataSet。Row 是一个类型,跟 Car、Person 这些的类型一样,所有的表结构信息都用 Row 来表示。获取数据时需要指定顺序
八、Spark-Streaming简介
- 定义与功能:Spark Streaming用于处理流式数据,支持Kafka、Flume、Twitter、TCP套接字等多种数据输入源,输入数据后可利用Spark的map、reduce、join、
window等高度抽象
原语进行运算,运算结果能保存到HDFS、数据库等地方。
- 抽象表示:类似于Spark基于RDD的概念,Spark Streaming使用离散化流(DStream)作为抽象表示,DStream是随时间推移收到数据的序列,内部每个
时间区间数据以RDD形式
存在,是RDD组成的序列,可看作是RDD在实时数据处理场景的封装。
3.特点:
易用:支持Java、Python、Scala等编程语言,编写实时计算程序可像编写离线
程序一样。
容错:无需额外代码和配置就能恢复丢失数据,对实时计算意义重大。
易整合:可在Spark上运行,允许重复使用相同代码进行批处理,实现实时处理
与离线处理
结合及交互式查询操作。
Spark-Streaming架构
Spark-Streaming架构图:
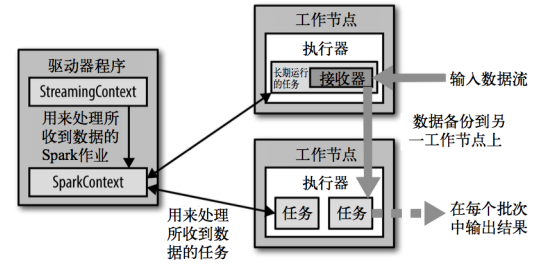
背压机制:这段内容主要介绍了Spark Streaming在数据接收速率控制方面的发展变化:
- Spark 1.5以前版本:用户可通过设置静态配置参数"spark.streaming.receiver.maxRate"限制Receiver的数据接收速率,能适配当前处理能力、防止内存溢出,但存在问题。如当producer数据生产速率和集群处理能力均高于maxRate时,会导致资源利用率下降。
- Spark 1.5及以后版本:为更好协调数据接收速率与资源处理能力,Spark Streaming从1.5版本开始能动态控制数据接收速率以适配集群处理能力。引入背压机制(Spark Streaming Backpressure),依据JobScheduler反馈的作业执行信息来动态调整Receiver数据接收率,可通过属性"spark.streaming.backpressure.enabled"控制是否启用该机制,默认不启用(值为false) 。