Spark,配置历史服务

配置历史服务

一、停止任务

进入/opt/module/spark-standalone/sbin, 运行命令:

./stop-all.sh

二、修改配置

进入 /opt/module/spark-standalone/conf/spark-default.conf.temple 先把名称改成spark-default.conf,再补充两个设置。如下所示具体代码如下:
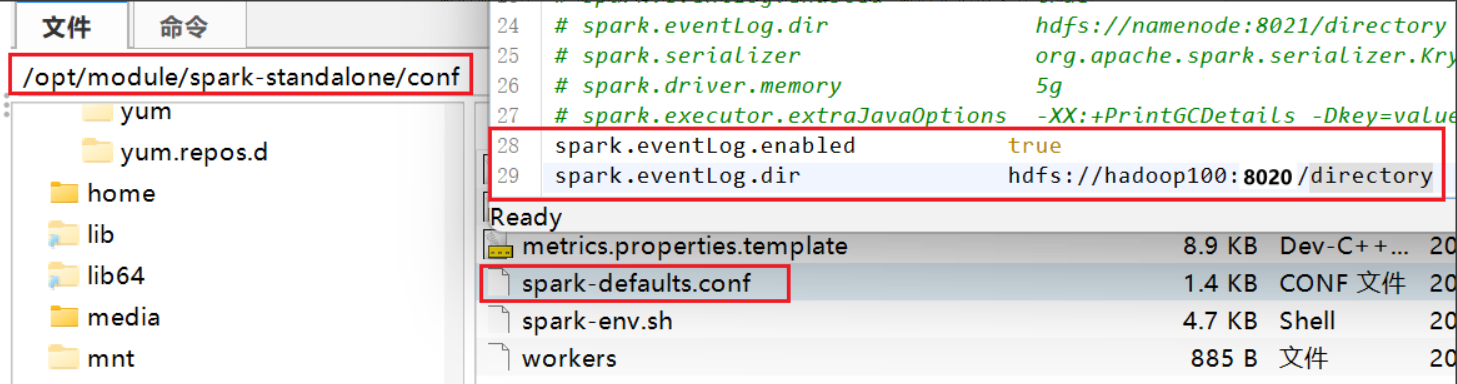
spark.eventLog.enabled true

spark.eventLog.dir hdfs://hadoop100:8020/directory

三、创建目录

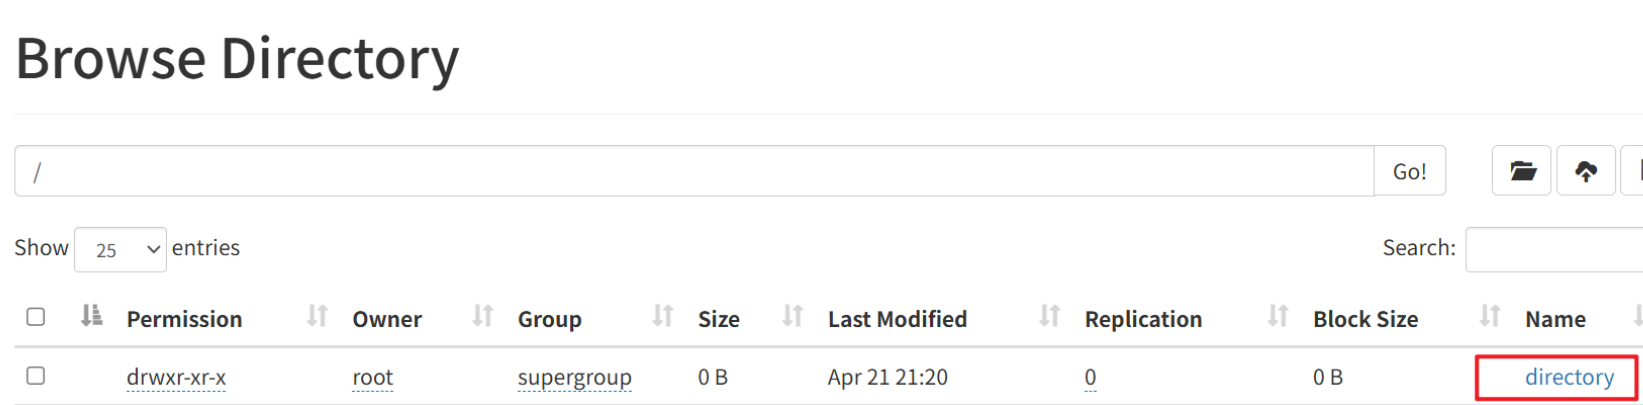
启动hadoop的hdfs服务(start-dfs.sh),并在根目录创建目录directory。可以通过命令行的方式来创建,也可以通过hadoop100:9870的页面操作来创建。
四、修改spark-env.sh文件

(注:4、5两步在上一条博客中直接一起配置了,所以这里可自行跳过)

添加一句设置:

export SPARK_HISTORY_OPTS="-Dspark.history.fs.logDirectory=hdfs://hadoop100:8020/directory"

五、分发配置文件

xsync /opt/module/spark-standalone/conf/

六、重启spark集群。

命令是 ./start-all.sh

七、启动历史服务器

命令是 ./start-history-server.sh

相关推荐
数字新视界7 小时前
数据中心DCIM管理系统助力提升机房管理效率与安全性
大数据·人工智能·物联网·信息与通信·动环监控系统
阿里云大数据AI技术8 小时前
孩子王基于阿里云Data Agent的智能体实践:300+Agent 覆盖400+业务场景
大数据·人工智能·agent
武子康10 小时前
H3-World 扩展跳跃与开门:新动作怎样进入训练数据?
大数据·人工智能·算法
软件技术NINI11 小时前
DeepSeek 大模型落地应用实战指南
大数据·人工智能
wuyk55514 小时前
Spider-第11讲-工程化改造与可维护性
大数据·爬虫·elasticsearch·搜索引擎
墨林陌15 小时前
AI 热点日报(2026-11-16):黄仁勋或重返英伟达,华为发具身世界模型,ChatGPT Wallet打通支付
大数据
starzy199015 小时前
Structured Streaming 结构化流概述:把流数据当作一张无限增长的表
大数据·spark
wuyk55516 小时前
Spider-第12讲-asyncio异步并发爬取
大数据·爬虫·elasticsearch·搜索引擎
筑梦之人16 小时前
Elasticsearch 9.x 从入门到精通(5/7):集群、分布式与运维
运维·分布式·elasticsearch
筑梦之人17 小时前
Elasticsearch 9.x 从入门到精通(4/7):聚合分析与文本分析
大数据·elasticsearch·jenkins