如何在sheel中运行Spark

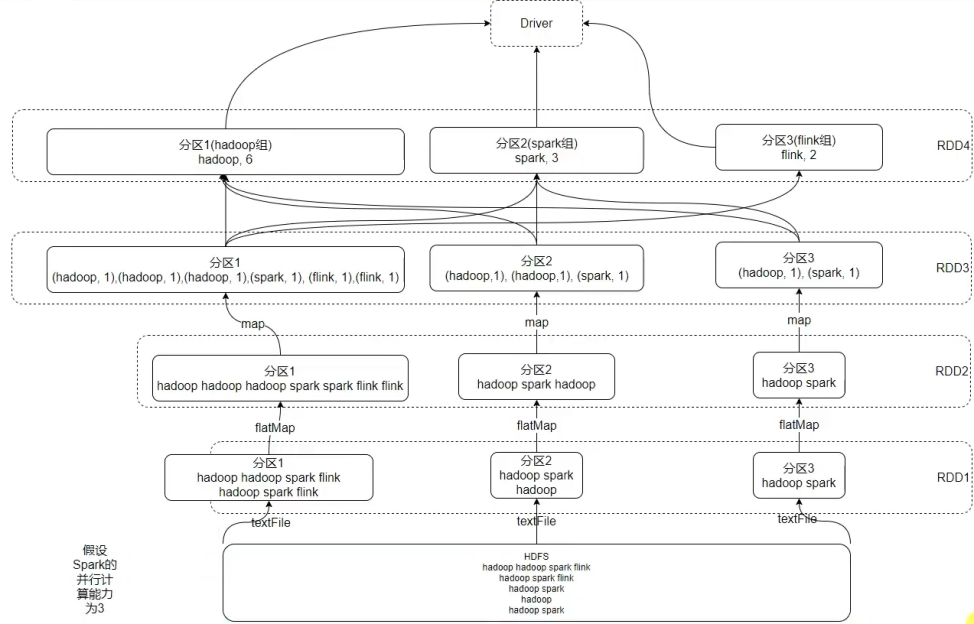
启动hdfs集群,打开hadoop100:9870,在wcinput目录下上传一个包含很多个单词的文本文件。

启动之后在spark-shell中写代码。
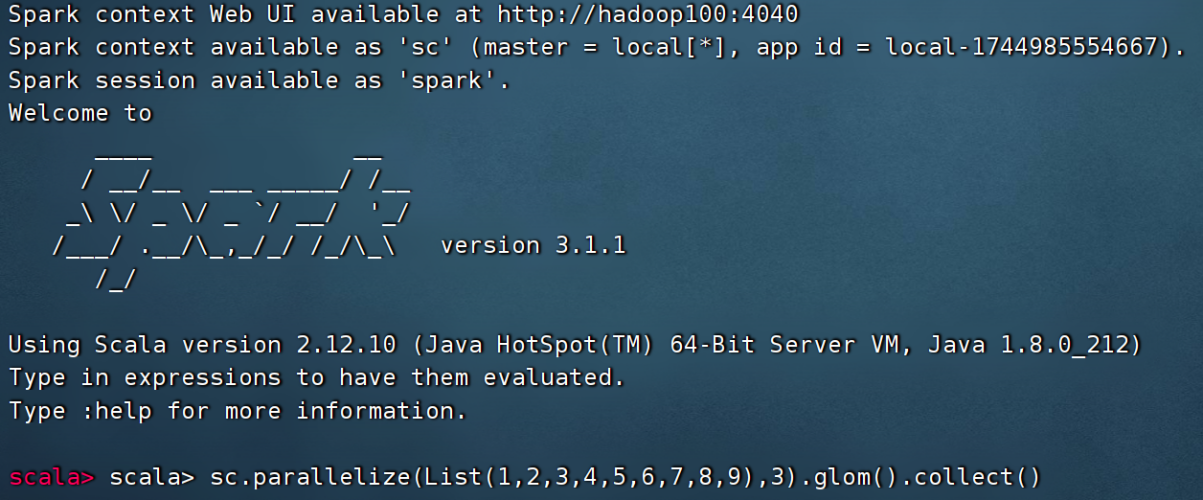

// 读取文件,得到RDD

val rdd1 = sc.textFile("hdfs://hadoop100:8020/wcinput/words.txt")

// 将单词进行切割,得到一个存储全部单词的RDD

val rdd2= fileRDD.flatMap(line => line.split(" "))

// 将单词转换为元组对象,key是单词,value是数字1

val rdd3= wordsRDD.map(word => (word, 1))

// 将元组的value按照key来分组,对所有的value执行聚合操作(相加)

val rdd4= wordsWithOneRDD.reduceByKey((a, b) => a + b)

// 收集RDD的数据并打印输出结果

rdd4.collect().foreach(println)
相关推荐
其实防守也摸鱼3 小时前
个人学习 Pwn 思路:从基础到漏洞利用的进阶路径
大数据·前端·人工智能·chrome·算法·安全·网络安全
美林数据Tempodata4 小时前
高职大数据技术专业升级的六个落地样本:从产业链需求库到实训室数据链路
大数据·人工智能·数字化转型·产教融合·ai教育
跨境卫士苏苏5 小时前
TikTokShop关联账户认定指引更新跨境代运营团队需要注意哪些管理责任
大数据·人工智能·市场营销·跨境电商·营销策略
迅易科技5 小时前
数据质量治理:从异常告警走向自动化根因诊断
大数据
组工部管理能手李哥6 小时前
一次政务知识库体验:AI回答之外,我更在意那行引用来源
大数据·人工智能·大模型·政务
GrowingIO技术社区6 小时前
SaaS与私有化部署怎么比较?责任、集成与成本
大数据·数据挖掘·产品
GrowingIO技术社区6 小时前
CDP项目如何评估?从业务问题到能力测试
大数据·数据分析
m0_715674436 小时前
政务泛监测体系能力排行:AI 重塑监测边界,治理的颗粒度革命
大数据·网络·人工智能·安全·网络安全·政务
GrowingIO技术社区8 小时前
多端用户身份怎么统一?OneID规则与验收清单
大数据·数据挖掘·数据分析
躺柒8 小时前
读数据安全架构设计与实践20安全政策文件体系(上)
大数据·人工智能·安全·数据安全·安全架构·安全体系