一 solr&es高亮
1.1 solr与es高亮功能
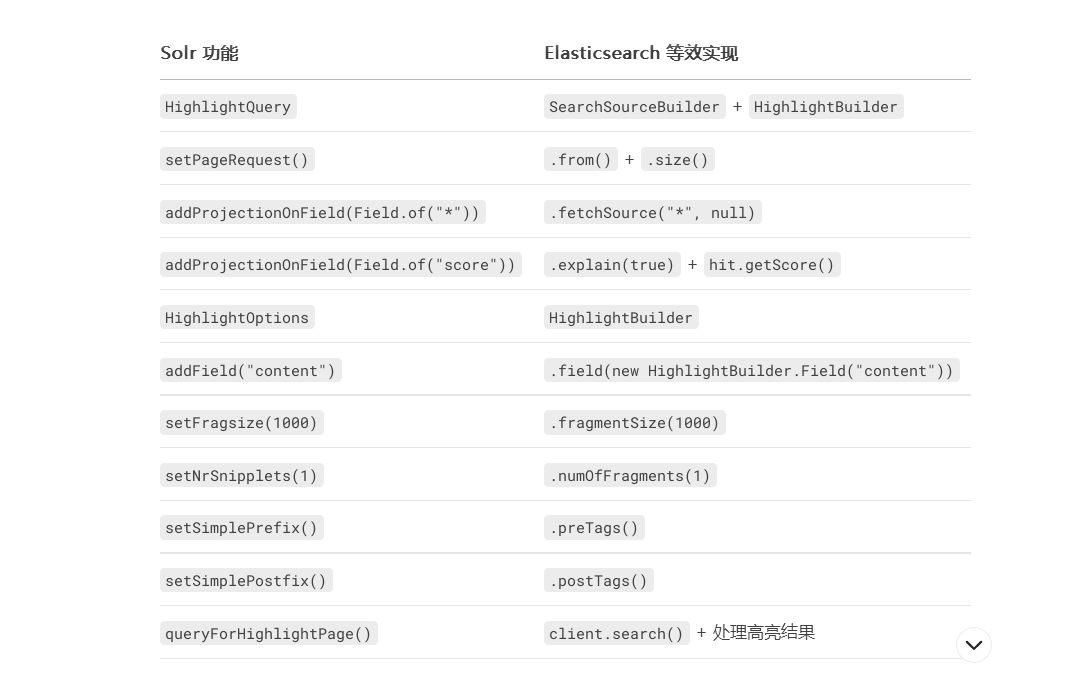
解释说明:
1)高亮配置:
fragmentSize(1000) 设置片段长度
numOfFragments(1) 指定返回的片段数量
preTags() 和 postTags() 设置高亮标记
2) 字段处理差异:
在 ES 中,使用 matchQuery 而非 termQuery 进行内容查询,因为:
matchQuery 会分析查询文本,更适合高亮
termQuery 用于精确匹配,不适合片段提取
3)得分处理:
explain(true) 使返回结果包含评分信息
通过 hit.getScore() 获取文档相关性得分
4) ****高亮结果提取:****获取第一个高亮片段的内容
hit.getHighlightFields().get("content").fragments()0.string()
https://chat.deepseek.com/a/chat/s/cfd96216-b726-4e00-9e9b-a74afa0d1c7f
1.2 es高亮功能代码
1代码
在 Elasticsearch 中实现与 Solr 高亮代码相同功能的 Java 代码如下。这段代码实现了相同的功能:分页查询、返回所有字段和得分、对指定字段进行高亮并返回指定数量的片段:
|----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| import org.elasticsearch.action.search.SearchRequest; import org.elasticsearch.action.search.SearchResponse; import org.elasticsearch.client.RequestOptions; import org.elasticsearch.client.RestHighLevelClient; import org.elasticsearch.common.unit.TimeValue; import org.elasticsearch.index.query.BoolQueryBuilder; import org.elasticsearch.index.query.QueryBuilders; import org.elasticsearch.search.SearchHit; import org.elasticsearch.search.builder.SearchSourceBuilder; import org.elasticsearch.search.fetch.subphase.highlight.HighlightBuilder; import org.elasticsearch.search.sort.ScoreSortBuilder; import org.elasticsearch.search.sort.SortOrder; import java.util.Map; // 1. 构建查询条件(使用之前的查询) BoolQueryBuilder boolQuery = QueryBuilders.boolQuery() .must(QueryBuilders.termQuery("title.keyword", retrievalRequest.getCollectionName())) .must(QueryBuilders.matchQuery("content", keyword)); // 使用matchQuery而非termQuery以支持高亮 // 2. 创建搜索源构建器 SearchSourceBuilder sourceBuilder = new SearchSourceBuilder() .query(boolQuery) .from((pageRequest.getPageNumber() - 1) * pageRequest.getPageSize()) // 分页起始位置 .size(pageRequest.getPageSize()) // 每页大小 .fetchSource("*", null) // 返回所有字段,相当于Solr的addProjectionOnField(Field.of("*")) .explain(true); // 返回得分,相当于Solr的addProjectionOnField(Field.of("score")) // 3. 构建高亮设置 HighlightBuilder highlightBuilder = new HighlightBuilder() .field(new HighlightBuilder.Field("content") // 要高亮的字段 .fragmentSize(1000) // 高亮片段长度 .numOfFragments(1) // 返回的片段数量 .preTags("<span style='color:red'>") // 高亮前缀 .postTags("</span>")) // 高亮后缀 .requireFieldMatch(true); // 只高亮匹配字段 // 4. 添加到搜索源 sourceBuilder.highlighter(highlightBuilder); // 5. 创建搜索请求 SearchRequest searchRequest = new SearchRequest("your_index_name"); // 对应Solr的"coll" searchRequest.source(sourceBuilder); // 6. 执行查询 SearchResponse response = client.search(searchRequest, RequestOptions.DEFAULT); // 7. 处理结果 for (SearchHit hit : response.getHits().getHits()) { // 获取原始字段 Map<String, Object> sourceAsMap = hit.getSourceAsMap(); // 获取高亮内容 if (hit.getHighlightFields().containsKey("content")) { String highlightedContent = hit.getHighlightFields().get("content").fragments()0.string(); // 将高亮内容设置到返回对象中 } // 获取得分 float score = hit.getScore(); } |