搭建spark伪分布集群

1.先查看虚拟机的默认名称,将其修改为vm01
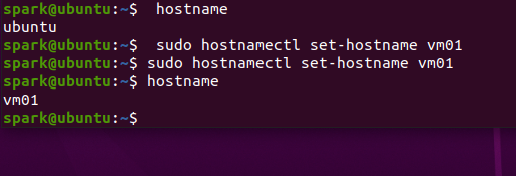
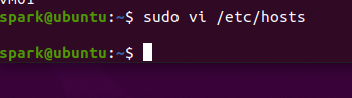
2.更改了主机名,还需要修改/etc/hosts文件,在这个文件设定了IP地址与主机名的对应关系,类似DNS域名服务器的功能
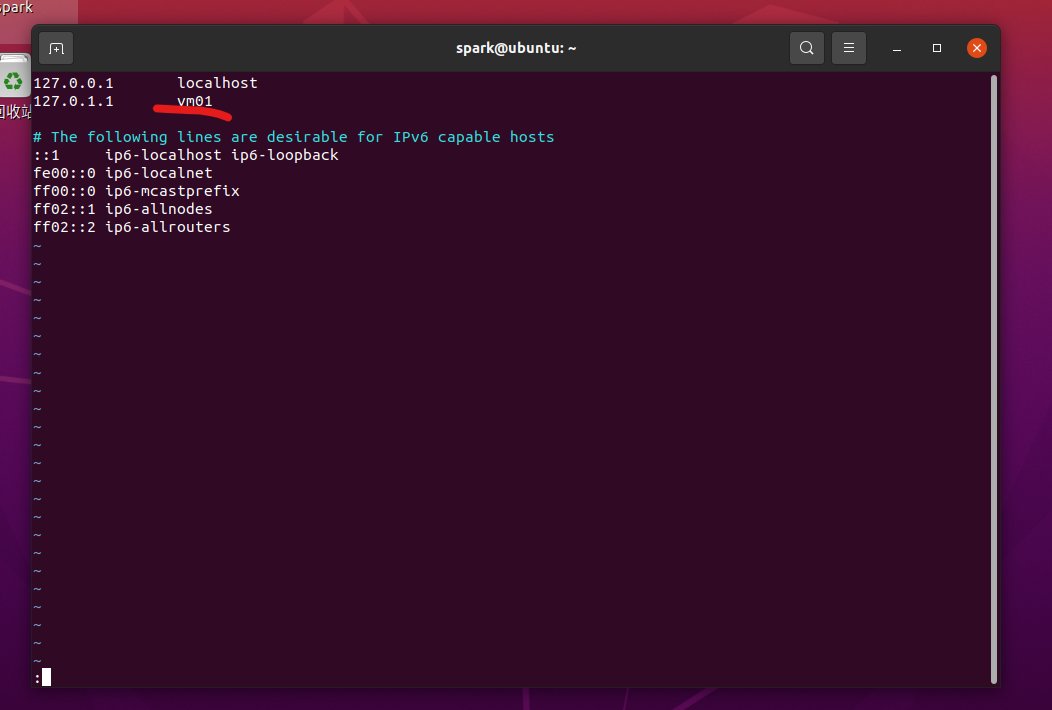
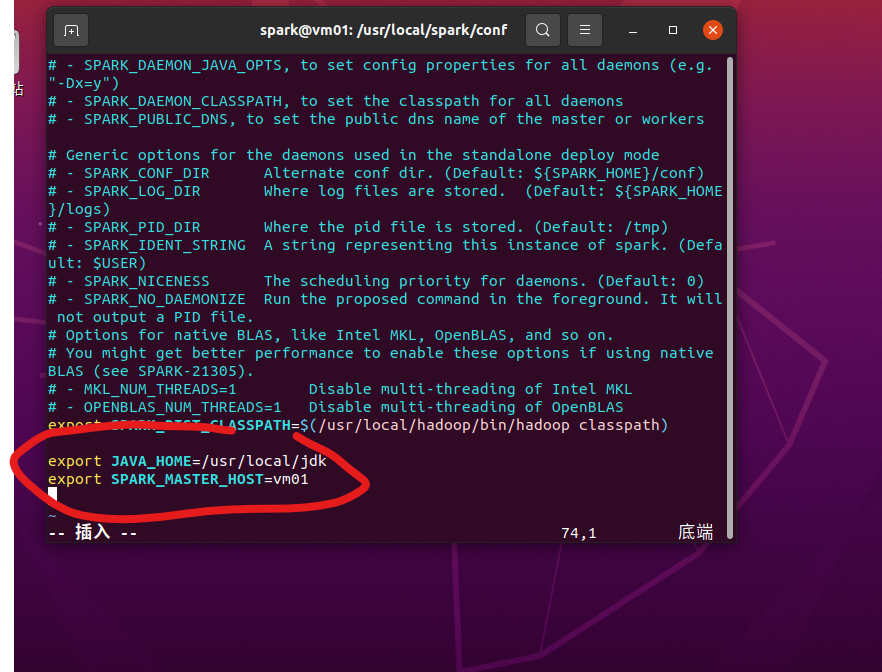
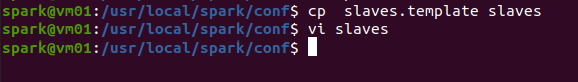
3.修改spark相关配置文件,包括spark-env.sh和slave两个文件
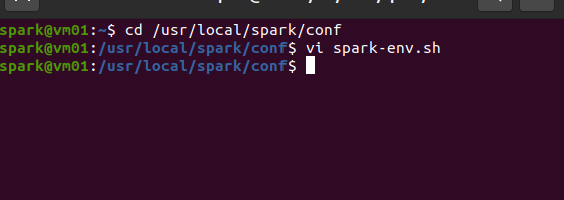
4.将localhost改为vm01 保存退出
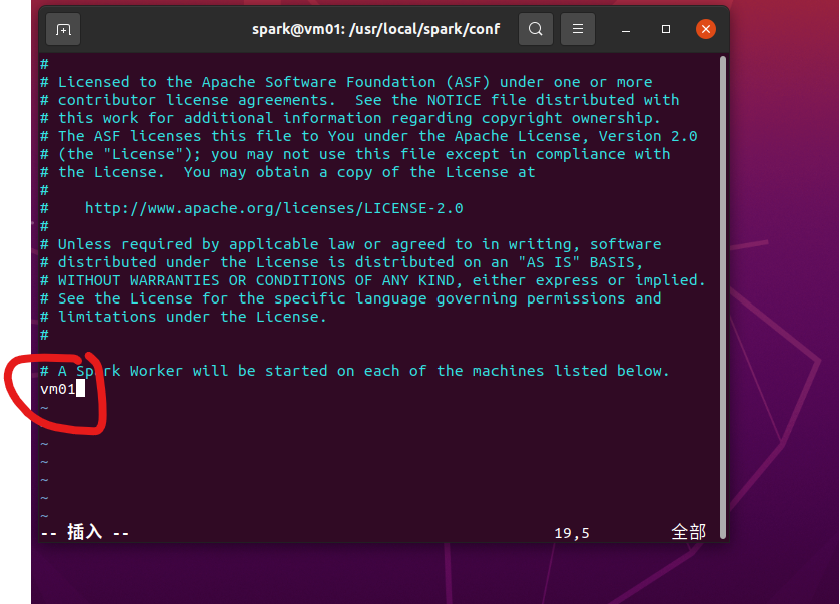
5.重启spark集群 出现worker和master表示成功

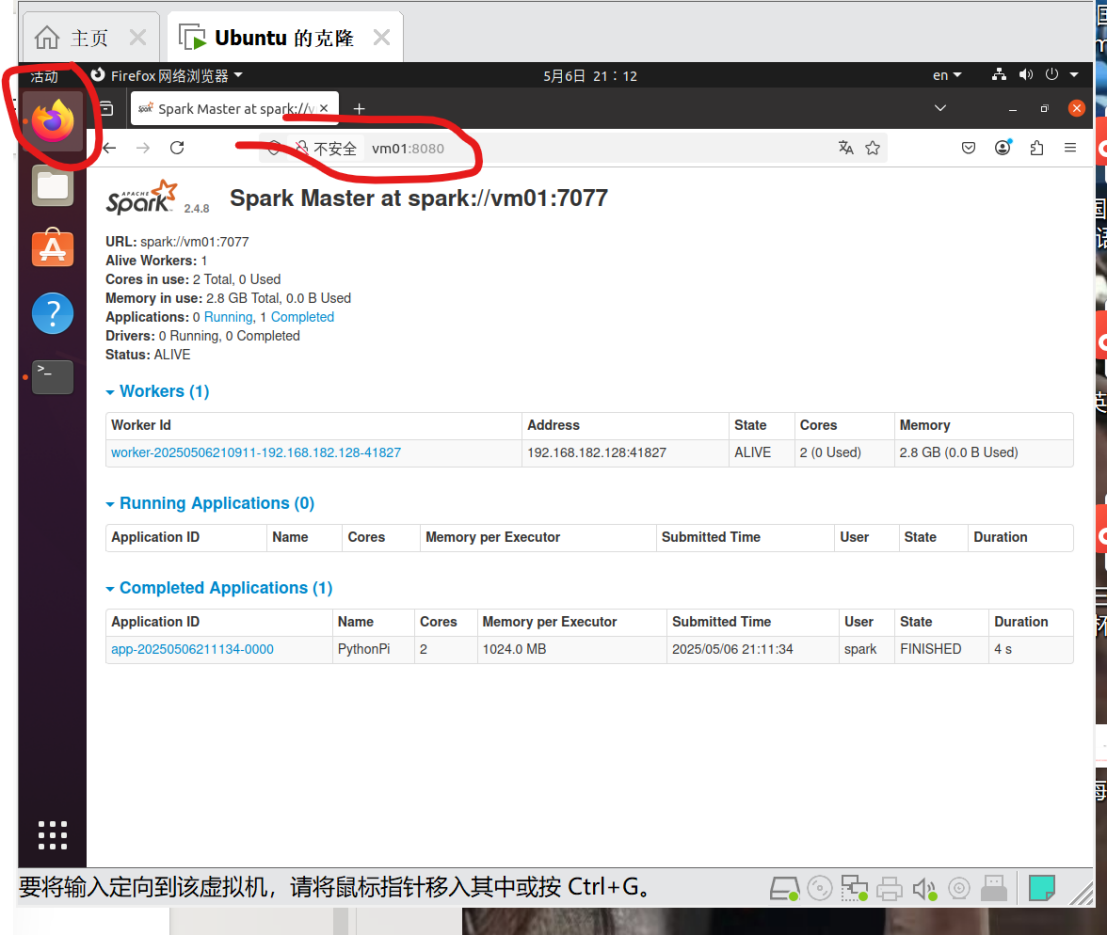
6.测试:
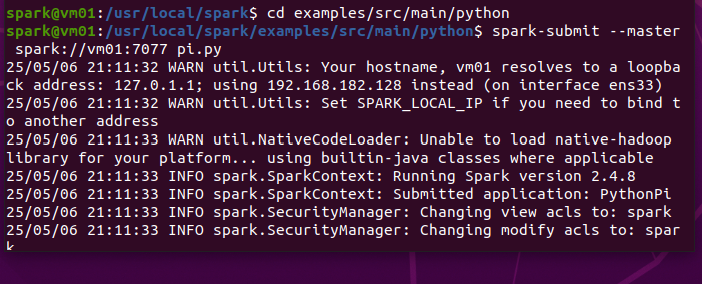
7.在浏览器输入:http://vm01:8080/ 查看
相关推荐
星恒随风10 小时前
MySQL 从零入门(三):表的约束详解
linux·服务器·数据库·笔记·mysql
喵个咪14 小时前
GoWind Admin 拆解:BI 大屏设计器——schema 即 JSON、resolver 注入与三张快照表的口径谱系
大数据·后端·go
武子康14 小时前
H3-World 的 11.3 小时训练数据,是怎样对齐成动作监督的?
大数据·人工智能·深度学习
坤坤子吖15 小时前
Linux网络编程:自定义应用层协议与 JSON 序列化
linux·服务器·网络·c++·笔记·json
青瓦梦滋15 小时前
Redis主从复制
服务器·数据库·redis·缓存·bootstrap
字节跳动数据平台15 小时前
火山引擎知识引擎VeKnow进化之路(下):让 AI 智能体更可用、更可信、更懂业务
大数据
Elastic 中国社区官方博客15 小时前
更少的位数,相同的召回率:DiskBBQ 更保守的自动校准扫描
大数据·运维·开发语言·人工智能·elasticsearch·搜索引擎
沫璃染墨16 小时前
从零入门计算机网络系列(十八):TCP连接管理详解——从三次握手与四次挥手到TIME_WAIT机制
运维·服务器·网络·c++·网络协议·tcp/ip·tcp
MyBili16 小时前
Chrome隐私安全配置:完整防护指南
大数据·chrome·谷歌浏览器·隐私安全·浏览器防护·cookie管理·上网痕迹清理
真上帝的左手16 小时前
19. 大数据-数据同步-工具
大数据·数据同步