服务器配置llama-factory问题解决

在配置运行llama-factory,环境问题后显示环境问题。这边给大家附上连接,我们的是liunx环境但是还是一样的。大家也记得先配置虚拟环境。

LLaMA-Factory部署以及微调大模型_llamafactory微调大模型-CSDN博客

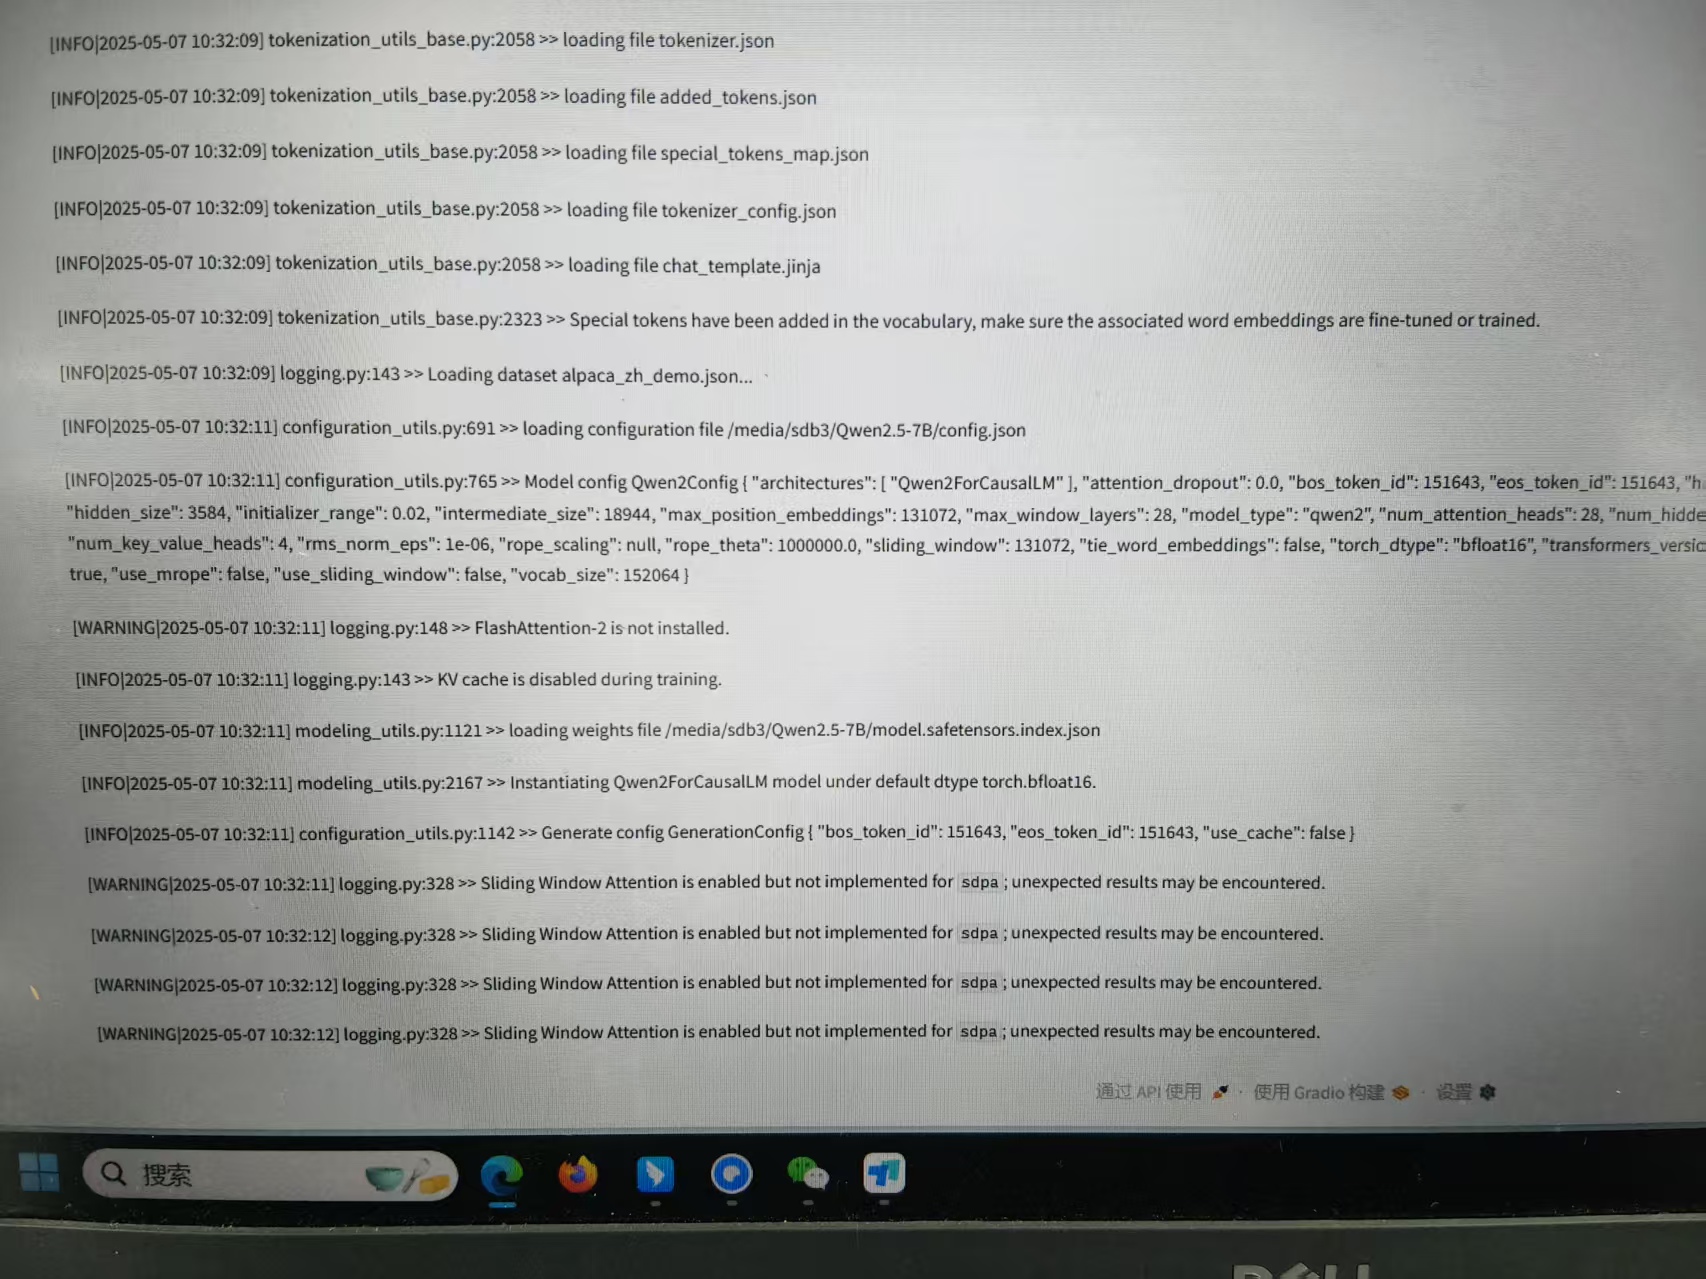
之后大家看看遇到的问题是不是我这样。
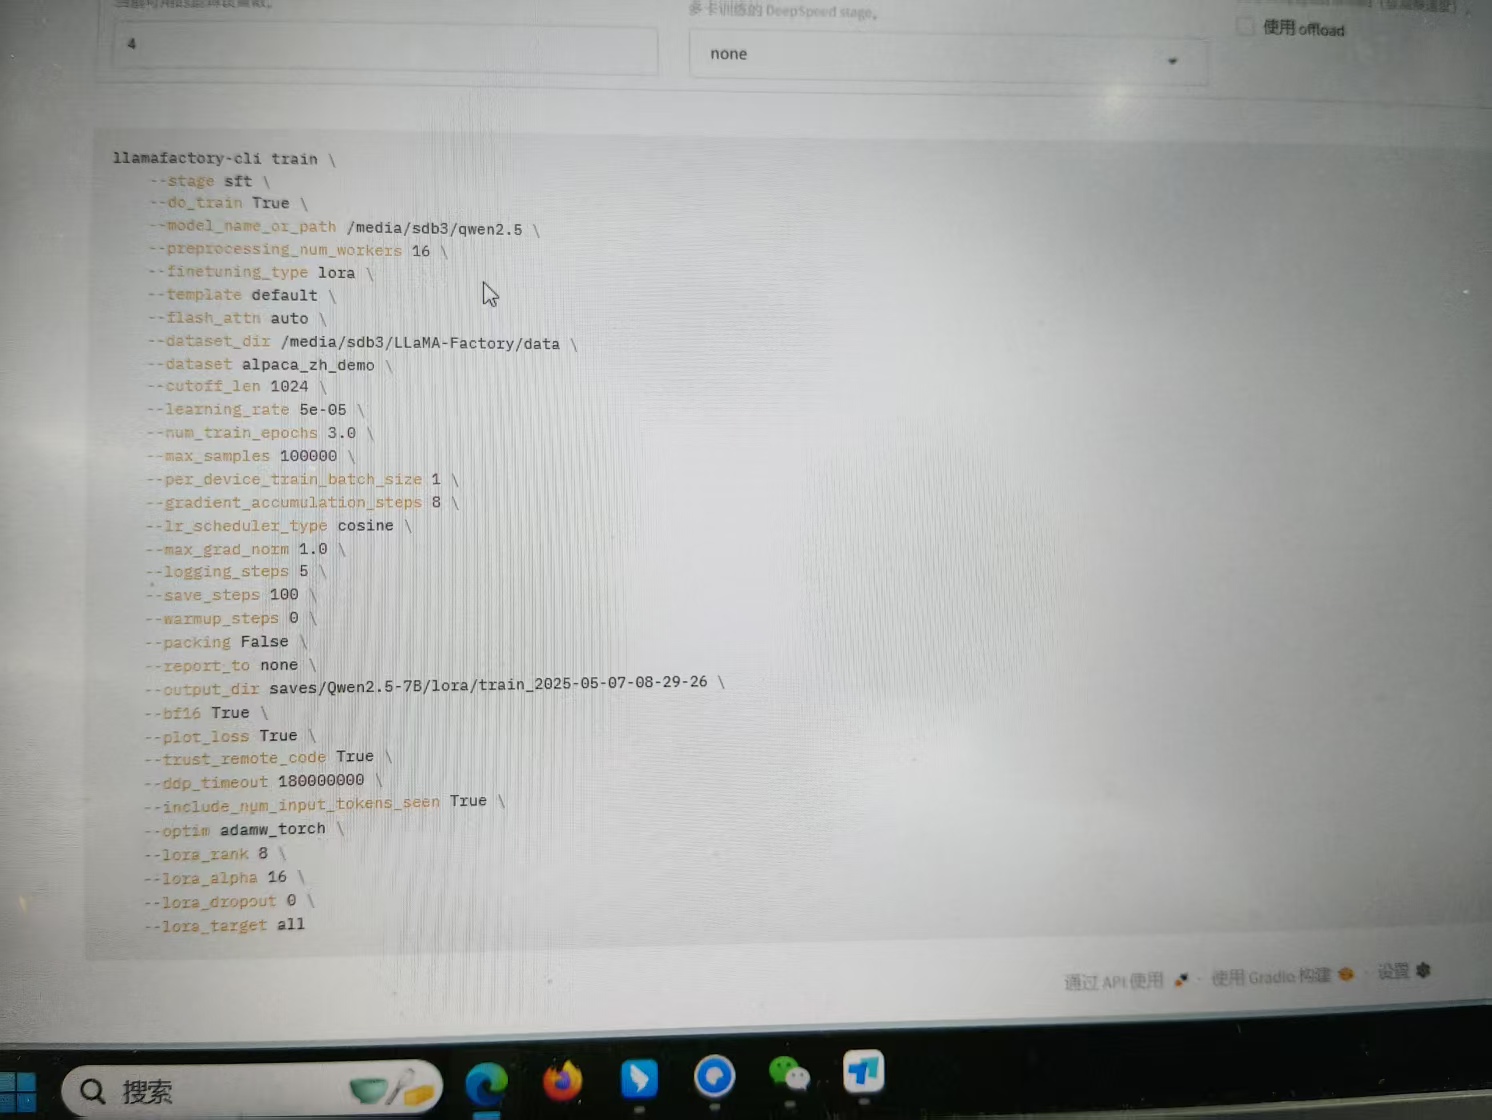
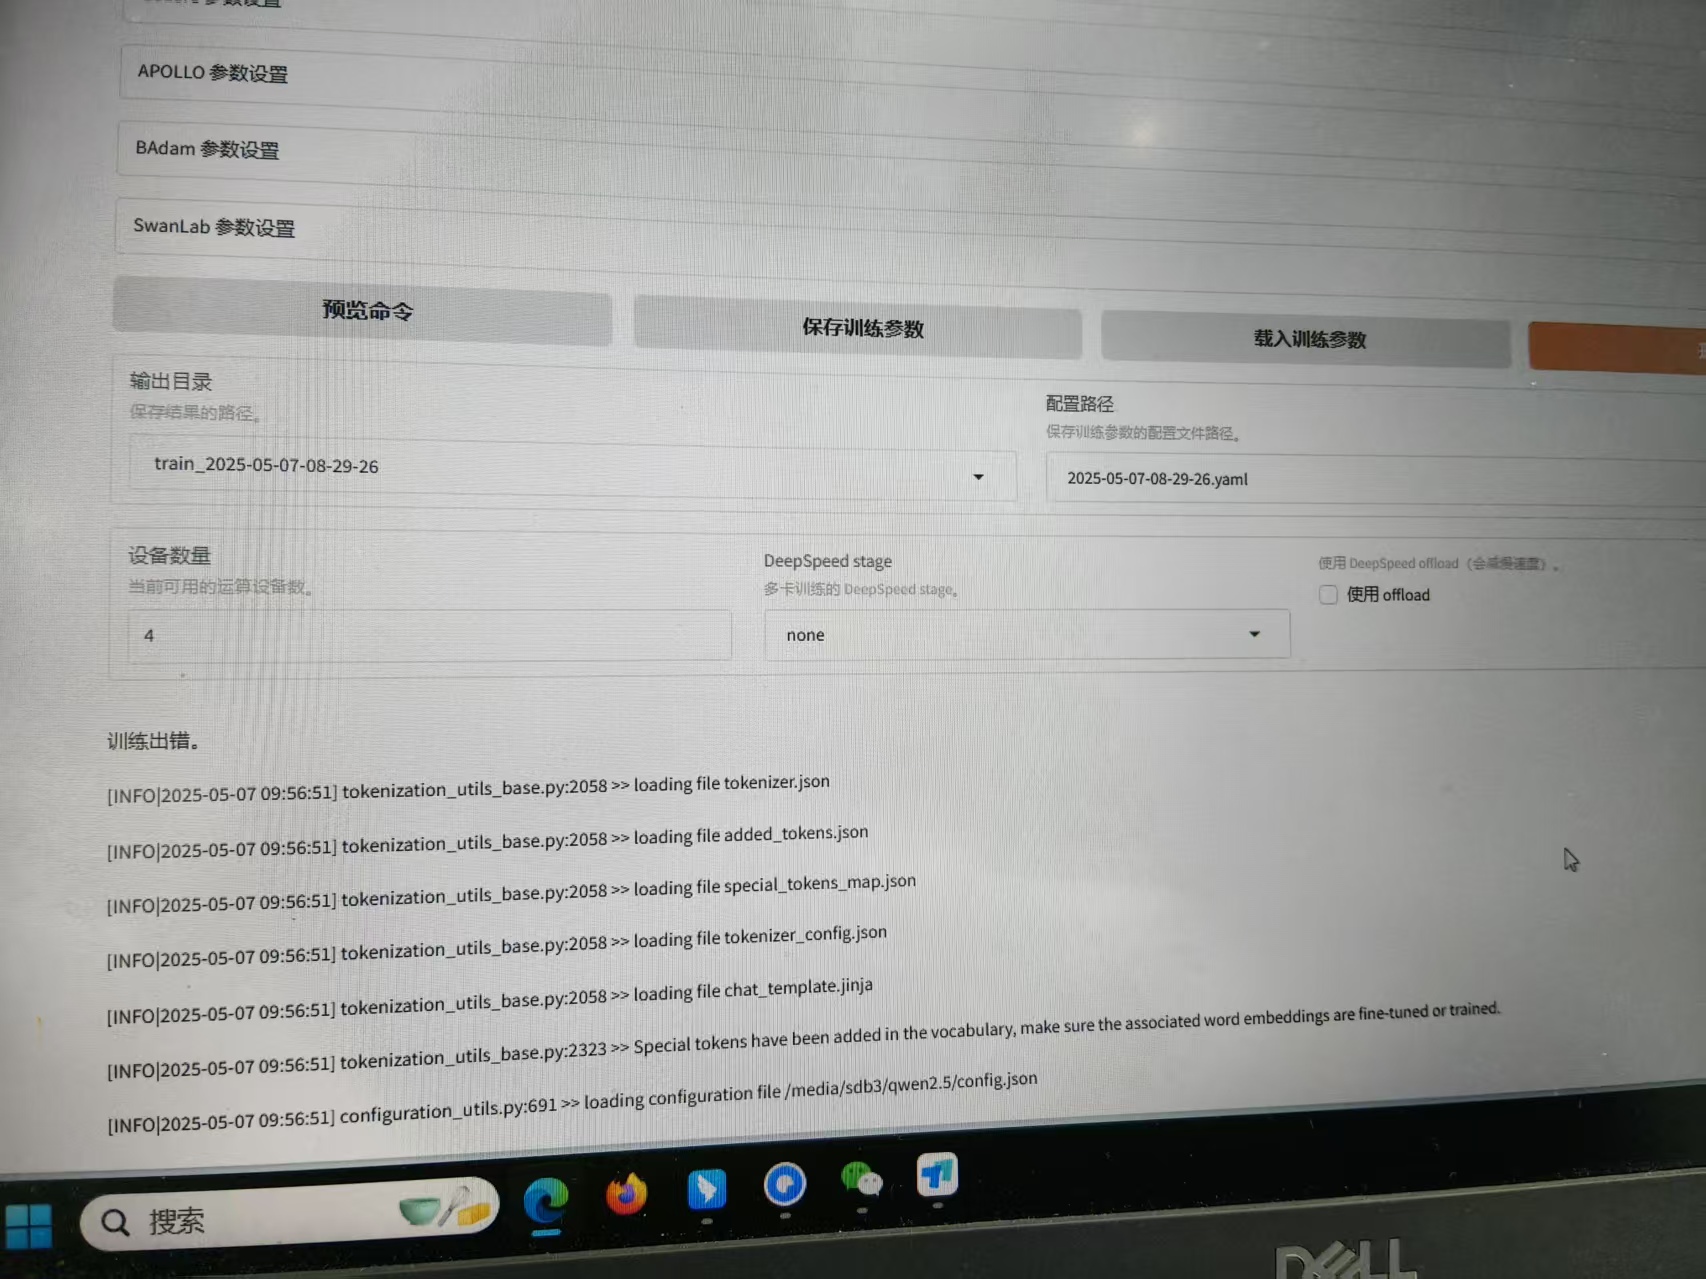
AI搜索的问题显示的是:
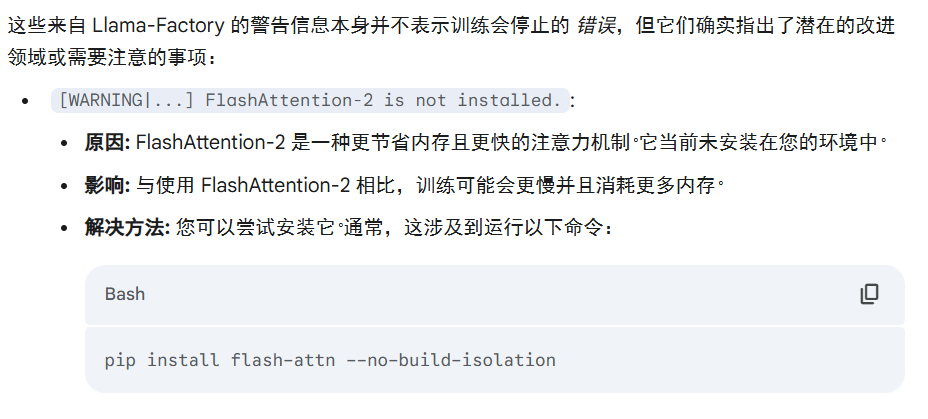
pip install flash-attn --no-build-isolation

这个不会安装cuda什么其他环境,那时候我更新了一下库,直接llama-factory瘫了。。

之后大家就可以美美调用了。

还有一个问题有时候显示缓存不足惹。。。。

相关推荐
GPU实战笔记2 天前
本地跑不动 llama.cpp,临时租云 GPU 怎么搭?从启动服务到环境复用
java·服务器·网络·人工智能·深度学习·llama
牛马工作号5 天前
RK3588 使用 rk-llama.cpp + RKNPU2 部署 Qwen3.5:从零开始的 NPU 本地大模型实战
人工智能·语言模型·llama
书源丶5 天前
Qwen3-Embedding-0.6B 纯 CPU
网络·语言模型·embedding·llama
论文复现现场6 天前
Llama/Qwen 70B 部署需要几张 RTX 4090?2卡、4卡、8卡显存、量化与 vLLM 选型
llama·qwen·vllm·大模型推理·大模型部署·rtx4090
谢白羽6 天前
在4×B300用SGLang部署DeepSeek-V4.1 Flash优化实录
笔记·python·llm·llama·sglang
renzao_ai10 天前
本地 35B 大模型部署实战:Ollama 跑 Ornith-35B 全流程
python·llama·免费ai大模型
Είναι η κοπέλα10 天前
本地大模型部署完全指南:Ollama / vLLM / llama.cpp / MLX 四大引擎横评与选型实战
macos·llama·vllm
小饕10 天前
RK3588 NPU 跑大模型实测:rknn-llm 解码 25.9 tok/s,是 llama.cpp 的 4 倍!附三天完整踩坑记录
人工智能·机器人·llama
一航jason10 天前
Android平台推理框架及试用场景模型对比
android·人工智能·ai·架构·ai编程·llama
一航jason10 天前
Android 端侧大模型推理框架对比
android·人工智能·ai·ai编程·llama·ai-native