文章目录
- [1. 单点问题](#1. 单点问题)
- [2. 主从模式](#2. 主从模式)
-
- [2.1 建立复制](#2.1 建立复制)
- [2.2 断开复制](#2.2 断开复制)
- [3. 拓扑结构](#3. 拓扑结构)
-
- [3.1 三种结构](#3.1 三种结构)
- [3.2 数据同步](#3.2 数据同步)
- [3.3 复制流程](#3.3 复制流程)
-
- [3.3.1 psync运行流程](#3.3.1 psync运行流程)
- [3.3.2 全量复制](#3.3.2 全量复制)
- [3.3.3 部分复制](#3.3.3 部分复制)
- [3.3.4 实时复制](#3.3.4 实时复制)
1. 单点问题
单点问题:某个服务器程序,只有一个节点 (只搞一个物理服务器,来部署这个服务器程序,机器挂了,服务就中断了),可用性难以保证、支持的并发量有限。
在分布式系统中为了解决单点问题,通常会把数据复制多个副本部署到其他服务器,满⾜故障恢复和负载均衡等需求。Redis也是如此,它为我们提供了复制的功能,实现了相同数据的多个Redis副本。
复制功能是高可用Redis的基础,哨兵和集群都是在复制的基础上构建的。
在分布式系统中,希望使用多个服务器来部署redis,存在以下几种方式:
- 主从模式
- 主从 + 哨兵
- 集群模式
2. 主从模式
在若干个redis节点中,有的是"主"节点,有的是"从节点",从节点上的数据要跟主节点保持一致。
redis的主从模式中,从节点上的数据,不允许修改,只能读取数据
由于主从节点上的数据是一致的,所以客户端从哪个节点上读取数据都是可以的,这也就相当于引入了更多的计算资源,支持的并发量也就高了。
主从模式,主要是针对"读操作"进行并发量和可用性的提高;对于写操作,无论是可用性还是并发,都是非常依赖主节点的
2.1 建立复制
在一台服务器上如何建立主从模式呢? - -启动多个redis-server进程
- 修改从节点配置文件(端口、后台运行)
- 启动进程
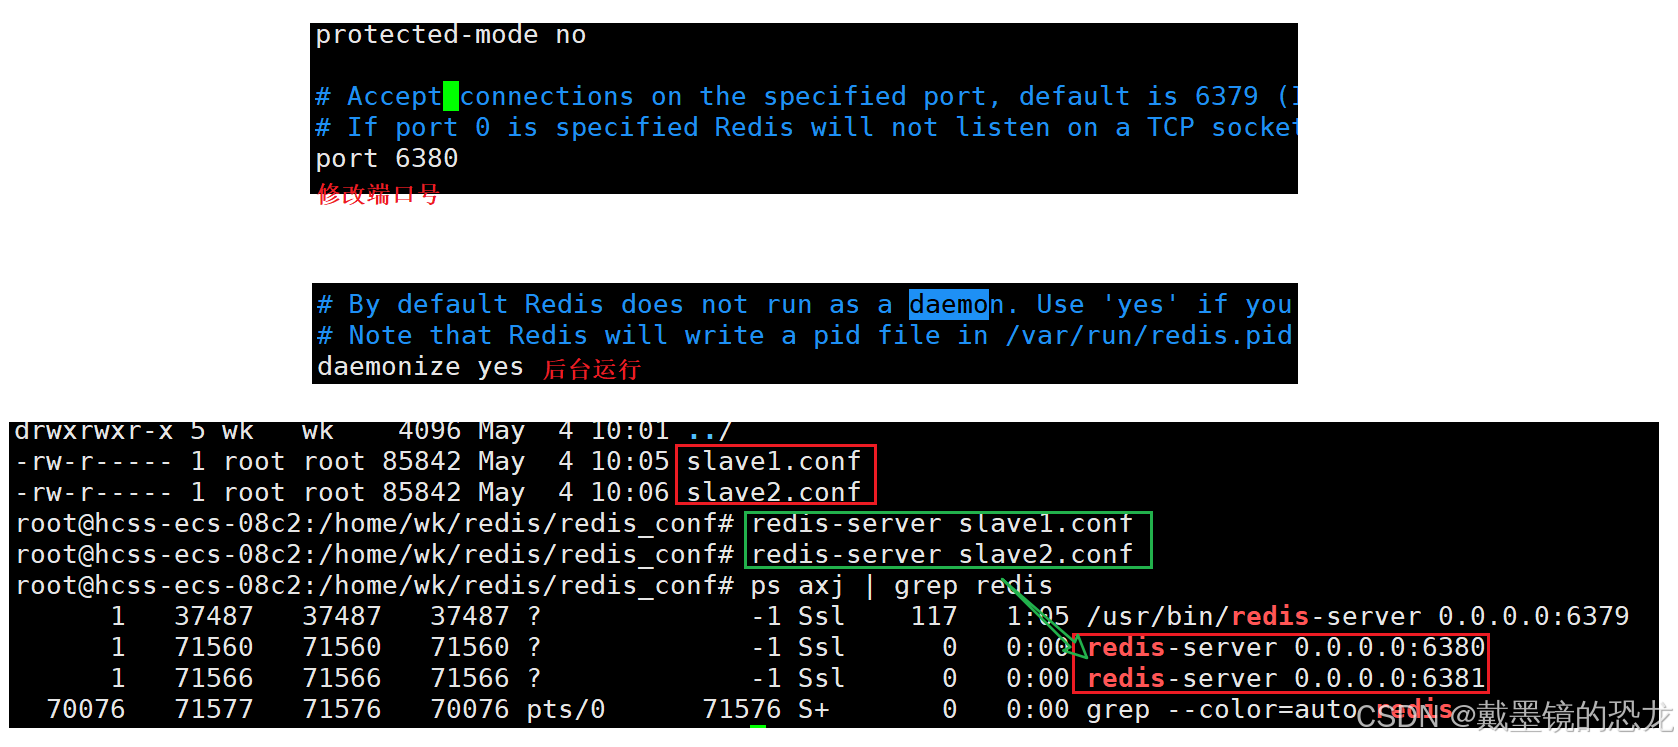
此时,这几个进程之间还没有任何的关联,还需要配置
配置复制的⽅式有以下三种:
- 在配置⽂件中加⼊
slaveof{masterHost} {masterPort}随Redis启动⽣效。- 在redis-server 启动命令时加⼊
--slaveof{masterHost} {masterPort} ⽣效。- 直接使⽤redis命令:
slaveof{masterHost} {masterPort}⽣效
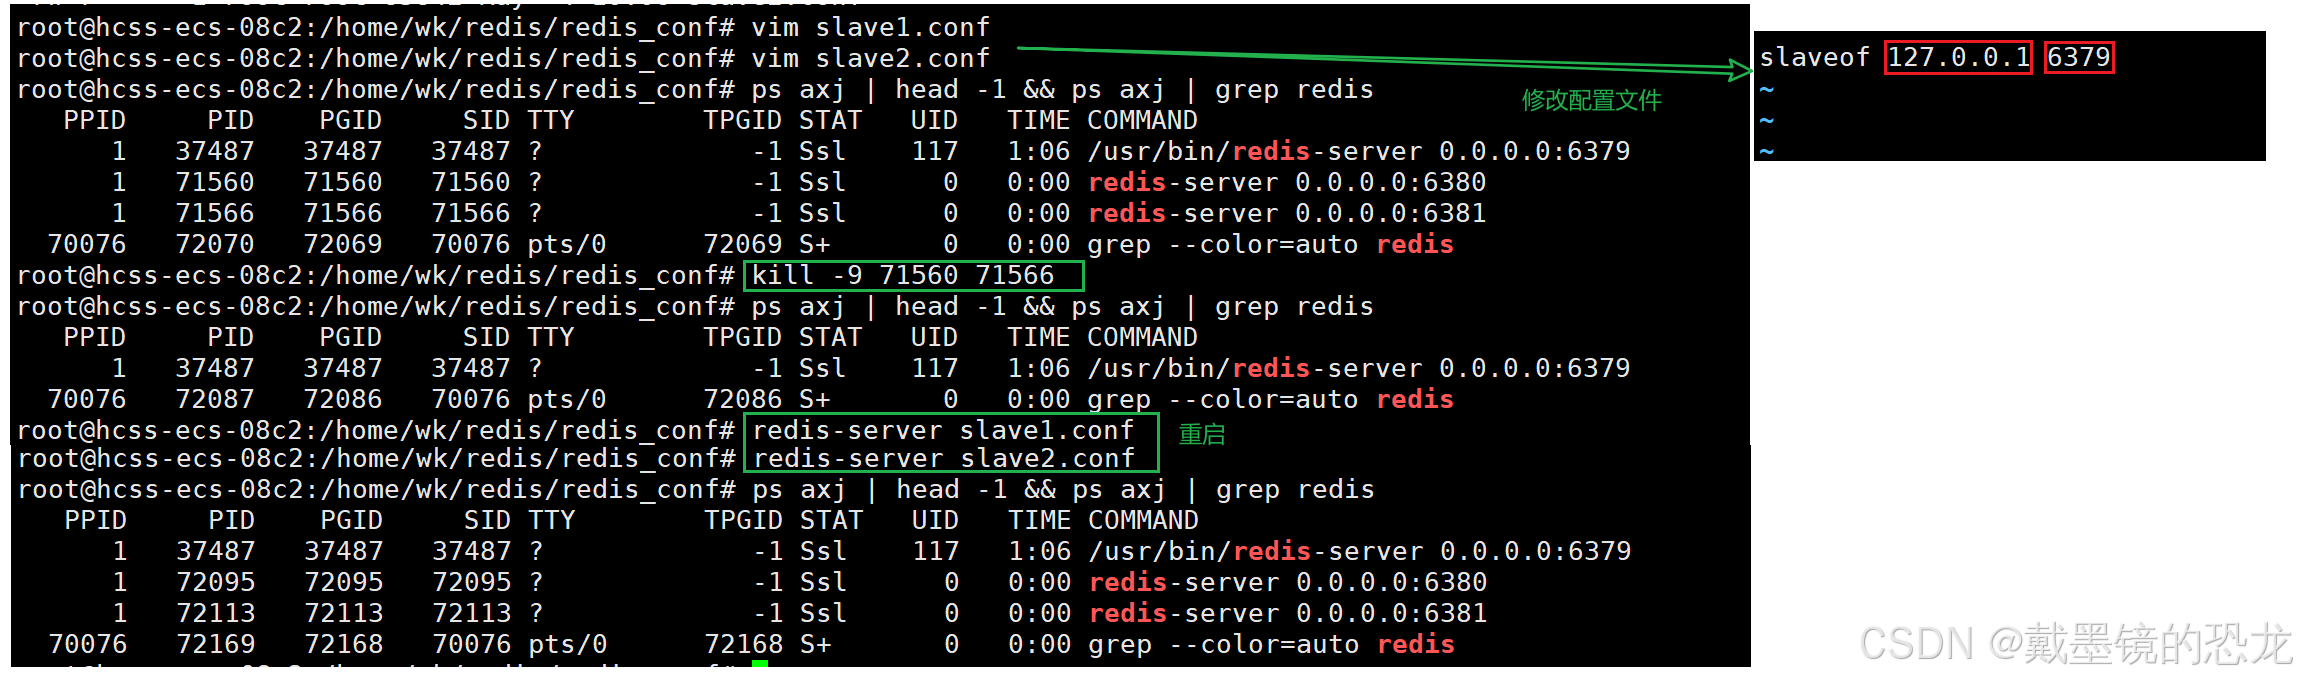
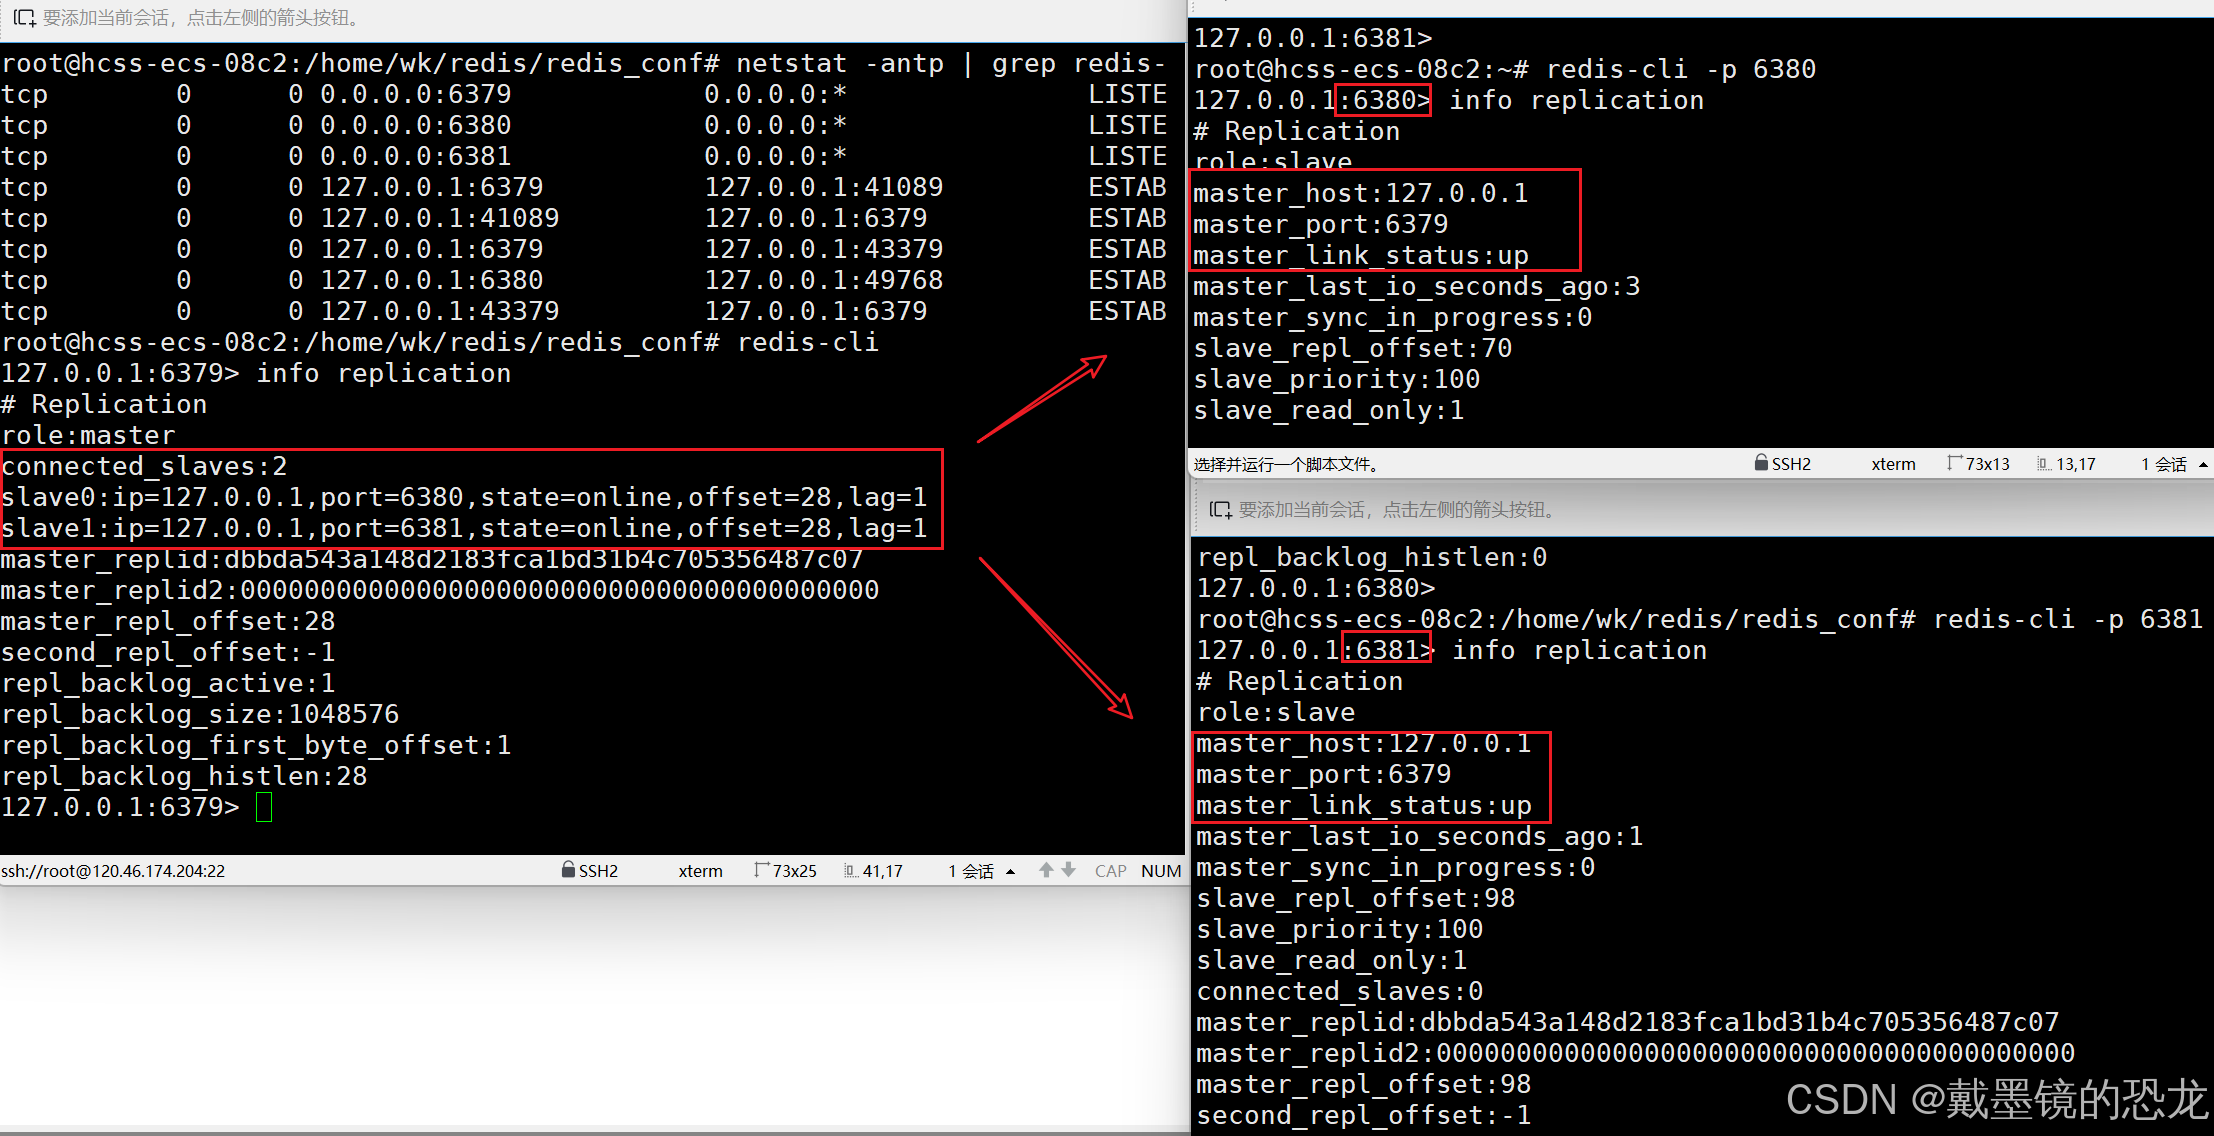
此时,这三个redis-server进程就关联好了
可以使用info replication命令查看
2.2 断开复制
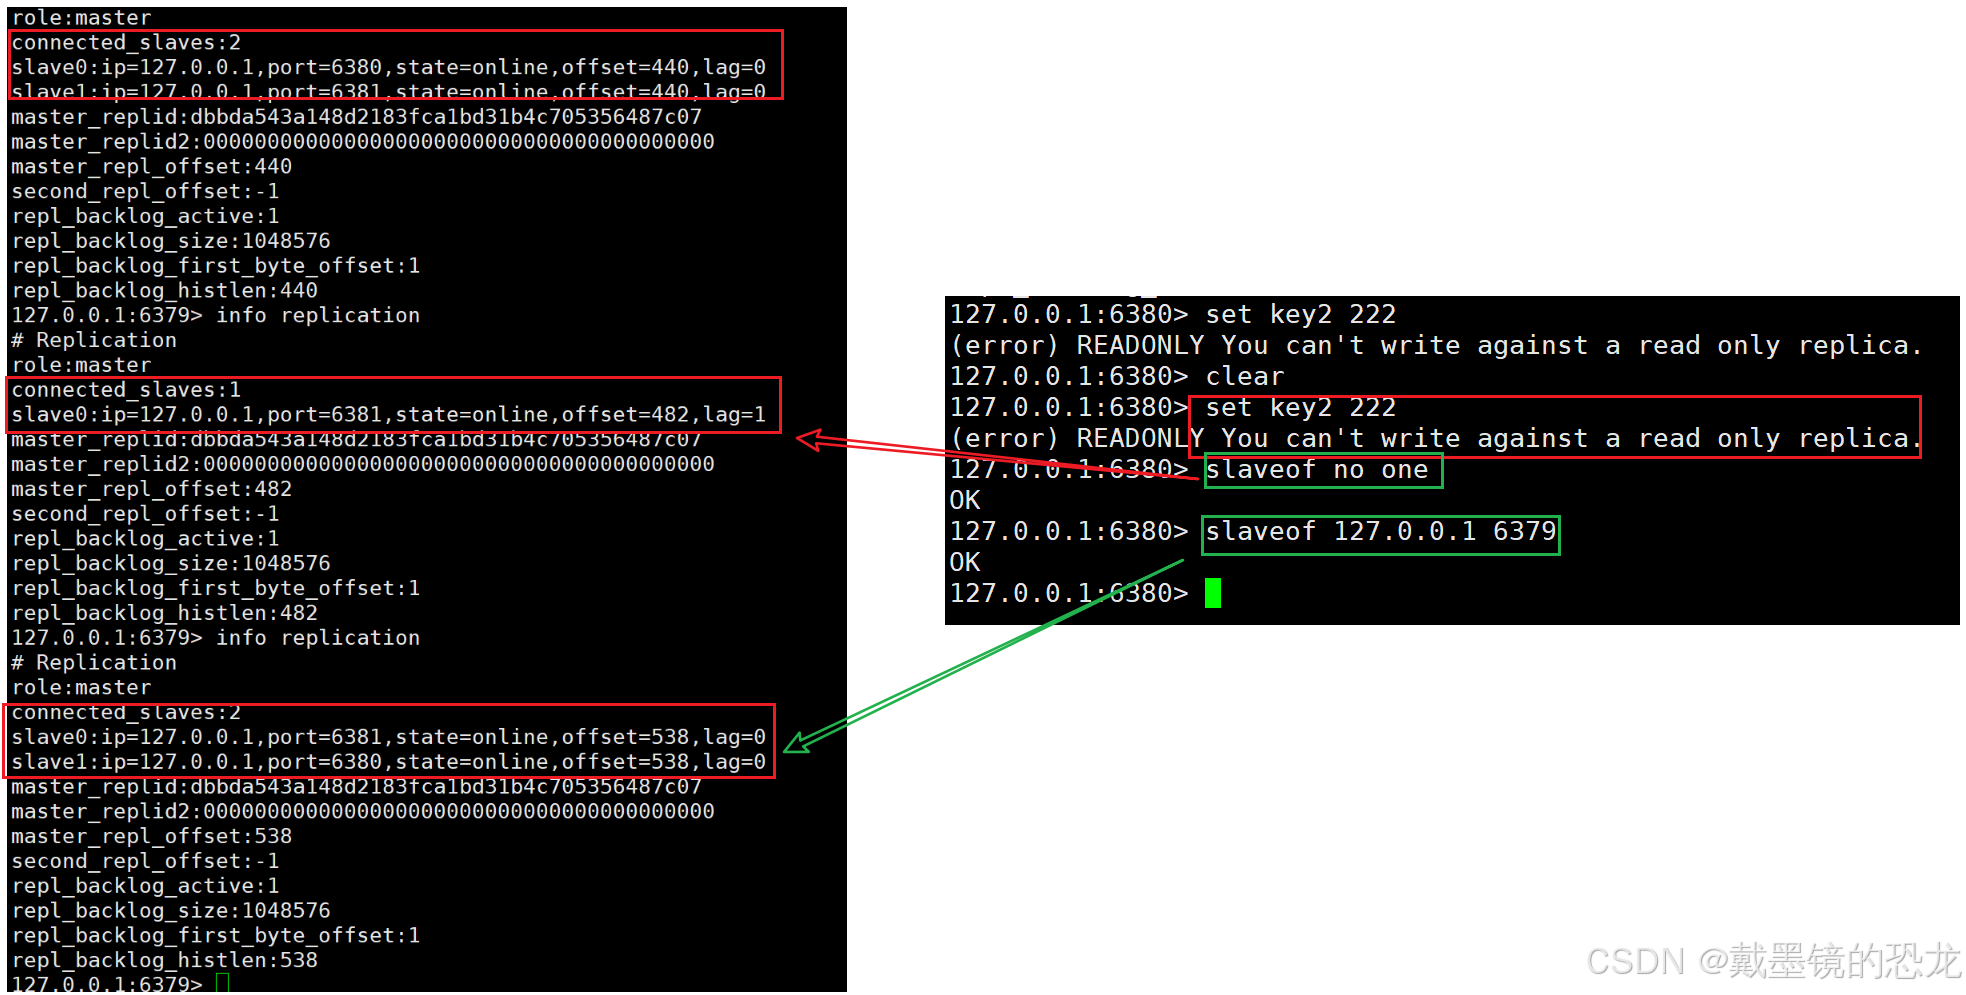
slaveof 命令不但可以建⽴复制,还可以在从节点执⾏slaveof no one来断开与主节点复制关系。
断开复制主要流程:
- 断开与主节点复制关系。
- 从节点晋升为主节点。
从节点断开复制后并不会抛弃原有数据,只是⽆法再获取主节点上的数据变化。
通过slaveof命令还可以实现切换主操作,将当前从节点的数据源切换到另⼀个主节点。执行 slaveof {newMasterIp} {newMasterPort} 命令即可。
切主操作主要流程:
- 断开与旧主节点复制关系。
- 与新主节点建⽴复制关系。
- 删除从节点当前所有数据。
- 从新主节点进⾏复制操作。
安全性
- 对于数据⽐较重要的节点,主节点会通过设置
requirepass参数进⾏密码验证,这时所有的客⼾端访问必须使⽤auth命令实⾏校验。 - 从节点与主节点的复制连接是通过⼀个特殊标识的客⼾端来完成,因此需要配置从节点的
masterauth参数与主节点密码保持⼀致,这样从节点才可以正确地连接到主节点并发起复制流程。
只读
- 默认情况下,从节点使⽤
slave-read-only=yes配置为只读模式。 - 由于复制只能从主节点到从节点,对于从节点的任何修改主节点都⽆法感知,修改从节点会造成主从数据不⼀致。所以建议线上不要修改从节点的只读模式。
传输延迟
- 主从节点⼀般部署在不同机器上,复制时的⽹络延迟就成为需要考虑的问题,Redis为我们提供了
repl-disable-tcp-nodelay参数⽤于控制是否关闭TCP_NODELAY,默认为no,即开启tcpnodelay 功能,说明如下:- 当关闭时,主节点产⽣的命令数据⽆论⼤⼩都会及时地发送给从节点,这样主从之间延迟会变⼩,但增加了⽹络带宽的消耗。适⽤于主从之间的⽹络环境良好的场景,如同机房部署。
- 当开启时,主节点会合并较⼩的TCP数据包从⽽节省带宽。默认发送时间间隔取决于Linux的内核,⼀般默认为40毫秒。这种配置节省了带宽但增⼤主从之间的延迟。适⽤于主从⽹络环境复杂的场景,如跨机房部署。
3. 拓扑结构
3.1 三种结构
Redis 的复制拓扑结构(即若干节点之间,按照什么样的方式组织连接 )可以⽀持单层或多层复制 关系,根据拓扑复杂性可以分为以下三种:⼀主⼀从、⼀主多从、树状主从结构。
- 一主一从结构
⼀主⼀从结构是最简单的复制拓扑结构,⽤于主节点出现宕机时从节点提供故障转移⽀持,如图所⽰
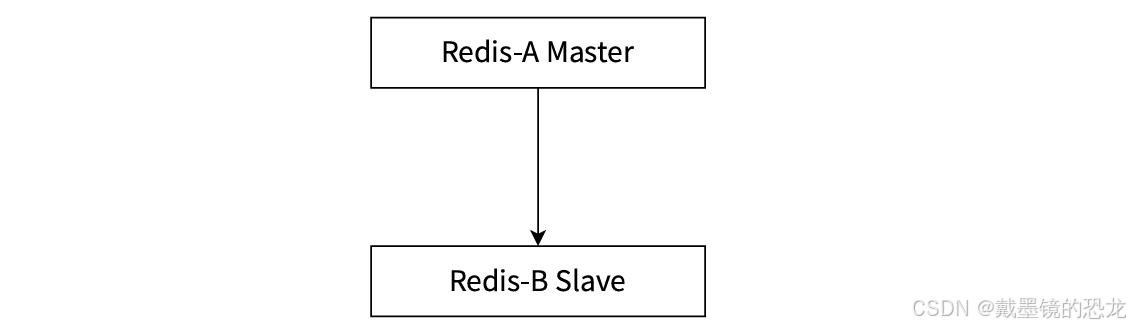
当写命令并发量较⾼且需要持久化时 ,可以只在从节点上开启AOF,这样既可以保证数据安全性同时也避免了持久化对主节点的性能⼲扰。
但需要注意的是,当主节点关闭持久化功能时,如果主节点宕机要避免⾃动重启操作(因为它没有AOF文件,需要从从节点拉取数据,然后在启动)
- 一主多从结构
⼀主多从结构(星形结构)使得应⽤端可以利⽤多个从节点实现读写分离,如图
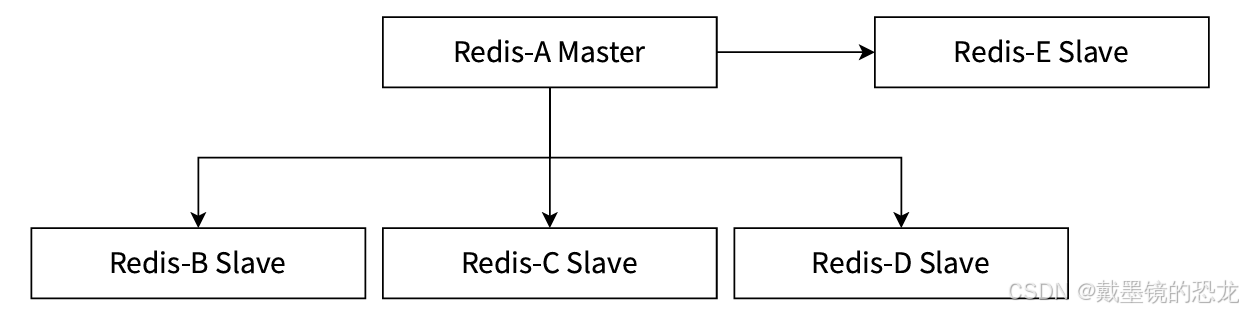
对于读⽐重较⼤的场景,可以把读命令负载均衡到不同的从节点上来分担压⼒。同时⼀些耗时的读命令可以指定⼀台专⻔的从节点执⾏,避免破坏整体的稳定性。
对于写并发量较⾼的场景,从节点过多会导致主节点写命令的多次发送从而加重主节点的负载。
- 树形主从结构
树形主从结构(分层结构)使得从节点不但可以复制主节点数据,同时可以作为其他从节点的主节点继续向下层复制 。通过引⼊复制中间层,可以有效降低住系欸按负载和需要传送给从节点的数据量
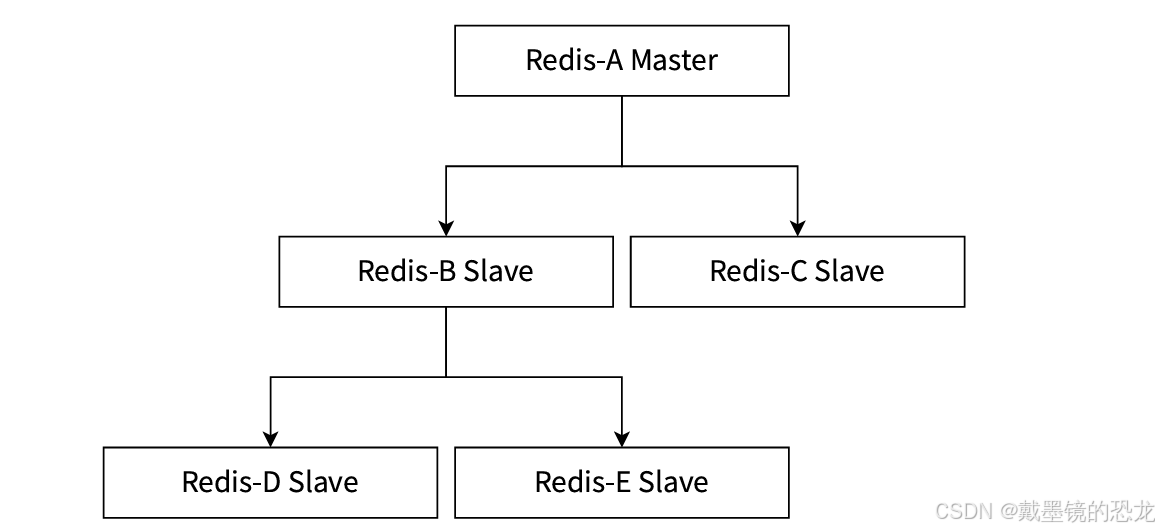
数据写⼊节点A之后会同步给B和C节点,B节点进⼀步把数据同步给D和E节点。当主节点需要挂载等多个从节点时为了避免对主节点的性能⼲扰,可以采⽤这种拓扑结构。
缺点:一旦数据修改了,数据同步的延迟是高于第二种方式的
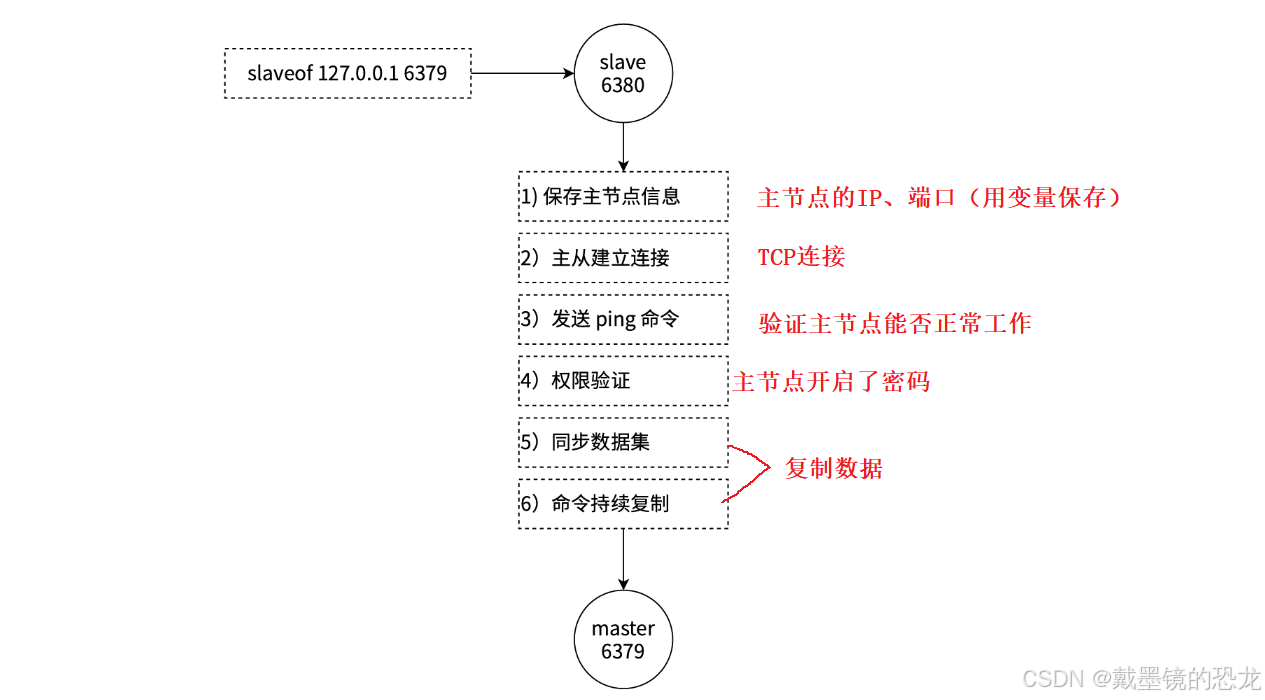
复制流程:
3.2 数据同步
Redis 使⽤psync命令完成主从数据同步,同步过程分为:全量复制和部分复制。
- 全量复制:⼀般⽤于初次复制场景,Redis早期⽀持的复制功能只有全量复制,它会把主节点全部数据⼀次性发送给从节点,当数据量较⼤时,会对主从节点和⽹络造成很⼤的开销。
- 部分复制 :⽤于处理在主从复制中因⽹络闪断等原因造成的数据丢失场景 ,当从节点再次连上主节点后,如果条件允许,主节点会补发数据给从节点。因为补发的数据远⼩于全量数据,可以有效避免全量复制的过⾼开销。
从节点负责psync
bash
PSYNC replicationid offset
- 如果replicationid 设为?并且offset设为-1,此时就是在尝试进⾏全量复制
- 如果replicationid offset 设为了具体的数值,则是尝试进⾏部分复制
replicationid就是主节点的复制id。
主节点重新启动,或者从节点晋级成主节点,都会⽣成⼀个replicationid.(同⼀个节点,每次重启,⽣成的replicationid也会变化)
从节点在和主节点建⽴连接之后,就会获取到主节点的replicationid
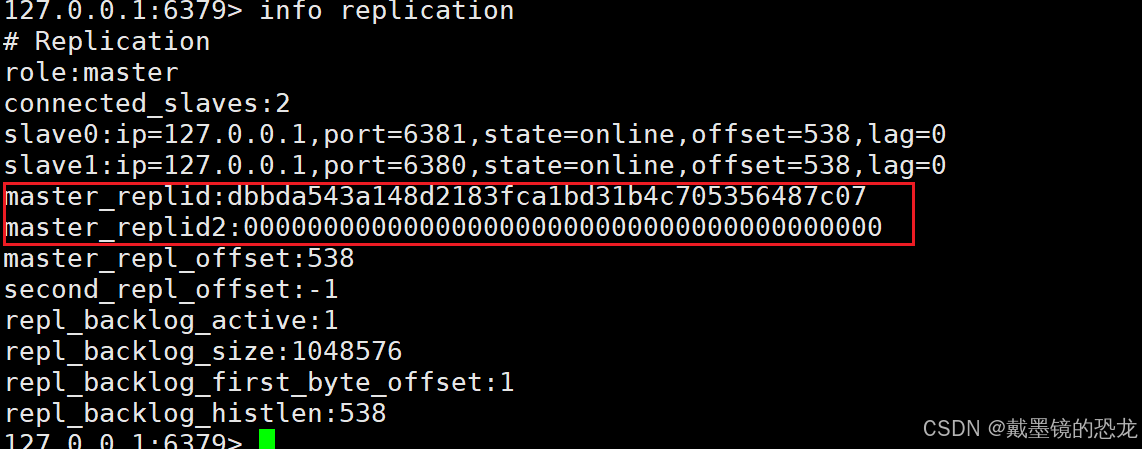
关于master_replid和master_replid2
每个节点需要记录两组master_replid,这个设定解决的问题场景是这样的:⽐如当前有两个节点A和B,A为master,B为slave,此时B就会记录A的master_replid
如果⽹络出现抖动,B以为A挂了,B自己就会成为主节点,于是B给自己分配了新的master_replid,此时就会使⽤master_replid2来保存之前A的master_replid.
- 后续如果⽹络恢复了,B就可以根据master_replid2找回之前的主节点
- 后续如果⽹络没有恢复,B就按照新的master_replid⾃成⼀派,继续处理后续的数据.
offset (偏移量)
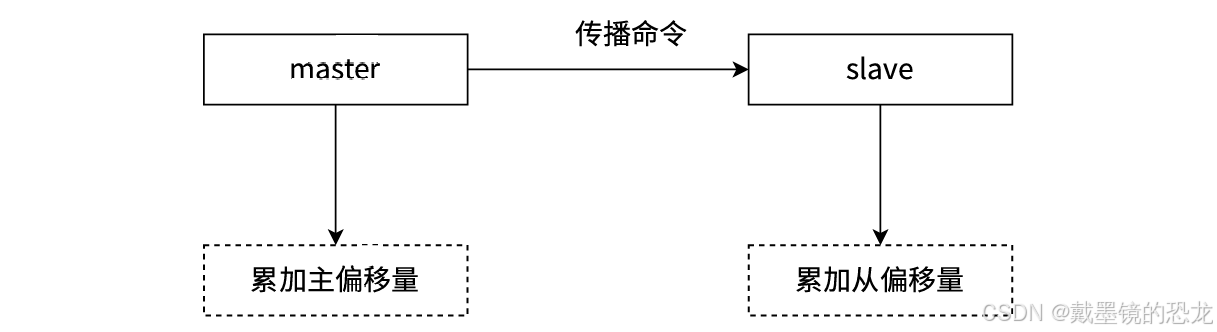
参与复制的主从节点都会维护自身复制偏移量
-
主节点(master)在处理完写⼊命令后,会把命令的字节⻓度做累加记录,统计信息在inforeplication中的
master_repl_offset指标中 -
从节点(slave)每秒钟上报自身的复制偏移量给主节点,因此主节点也会保存从节点的复制偏移量
-
从节点在接受到主节点发送的命令后,也会累加记录自身的偏移量。统计信息在inforeplication中的slave_repl_offset 指标中
通过对⽐主从节点的复制偏移量,可以判断主从节点数据是否⼀致
replid+offset共同标识了⼀个"数据集",如果两个节点,他们的replid和offset都相同,则这两个节点上持有的数据,就⼀定相同.
3.3 复制流程
3.3.1 psync运行流程
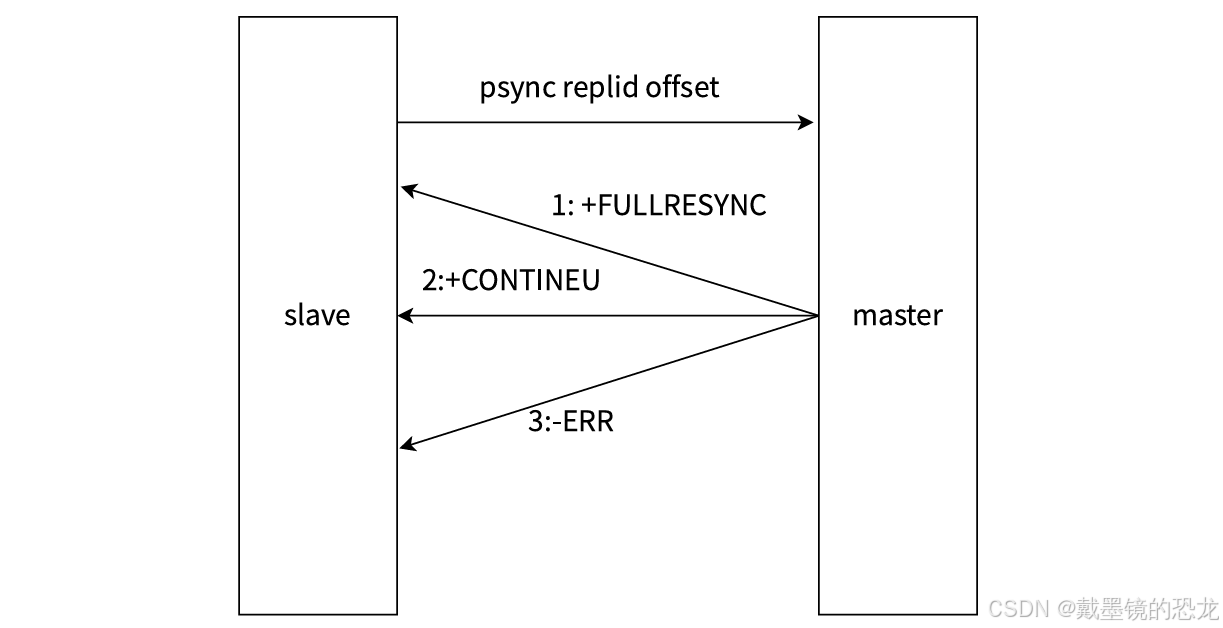
- 从节点发送psync命令给主节点,replid和offset的默认值分别是?和-1.
- 主节点根据psync参数和自身数据情况决定响应结果:
- 如果回复
+FULLRESYNCreplid offset,则从节点需要进⾏全量复制流程。 - 如果回复
+CONTINEU,从节点进⾏部分复制流程。 - 如果回复
-ERR,说明Redis主节点版本过低,不⽀持psync命令;从节点可以使⽤sync命令进⾏全量复制。 - psync⼀般不需要手动执行,Redis会在主从复制模式下自动调用执行.
- sync会阻塞redis-server处理其他请求,psync则不会
3.3.2 全量复制
全量复制是Redis最早⽀持的复制⽅式,也是主从第⼀次建⽴复制时必须经历的阶段,全量复制的运⾏流程如图所示
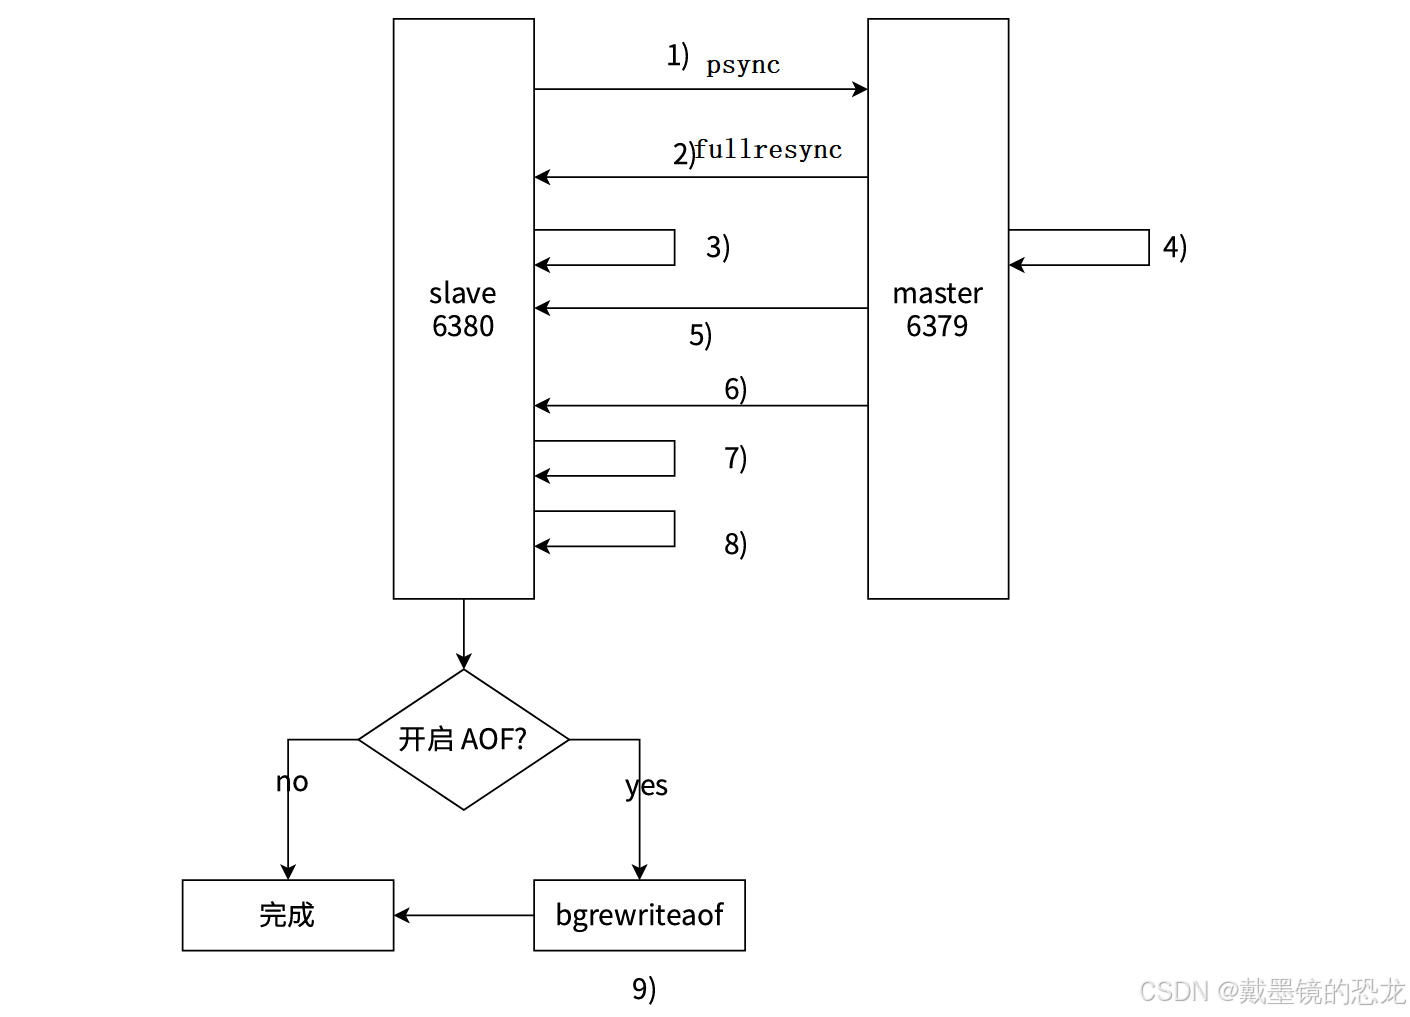
- 从节点发送psync命令给主节点进⾏数据同步,由于是第⼀次进⾏复制,从节点没有主节点的运⾏ID和复制偏移量,所以发送
psync ? -1。 - 主节点根据命令,解析出要进⾏全量复制,回复
+FULLRESYNC响应。 - 从节点接收主节点的运⾏信息进⾏保存(replicationid,offset)
- 主节点执⾏bgsave进⾏RDB⽂件的持久化(RDB文件是二进制的,体积更小)
- 主节点发送RDB文件给从节点,从节点保存RDB数据到本地硬盘。
- 主节点将从生成RDB到接收完成期间执行的写命令,写⼊缓冲区中,等从节点保存完RDB⽂件后,主节点再将缓冲区内的数据补发给从节点,补发的数据仍然按照rdb的⼆进制格式追加写⼊到收到的rdb⽂件中,保持主从⼀致性。
- 从节点清空⾃⾝原有旧数据。
- 从节点加载RDB⽂件得到与主节点⼀致的数据。
- 如果从节点加载RDB完成之后,并且开启了AOF持久化功能,它会进⾏bgrewrite操作,得到最近的AOF⽂件。
有磁盘复制vs⽆磁盘复制(diskless)
- 默认情况下,进⾏全量复制需要主节点⽣成RDB⽂件到主节点的磁盘中,再把磁盘上的RDB ⽂件发送给从节点.
- Redis从2.8.18版本开始⽀持⽆磁盘复制,主节点在执⾏RDB⽣成流程时,不会⽣成RDB⽂件到磁盘中了,⽽是直接把⽣成的RDB数据通过⽹络发送给从节点,这样就节省了一系列的写硬盘和读硬盘的操作开销.
3.3.3 部分复制
部分复制主要是Redis针对全量复制的过高开销做出的⼀种优化措施,使⽤psync replicationId offset 命令实现。
当从节点正在复制主节点时,如果出现⽹络闪断或者命令丢失等异常情况时,从节点会向主节点要求补发丢失的命令数据,如果主节点的复制积压缓冲区存在数据则直接发送给从节点,这样就可以保持主从节点复制的⼀致性。
补发的这部分数据⼀般远远⼩于全量数据,所以开销很小
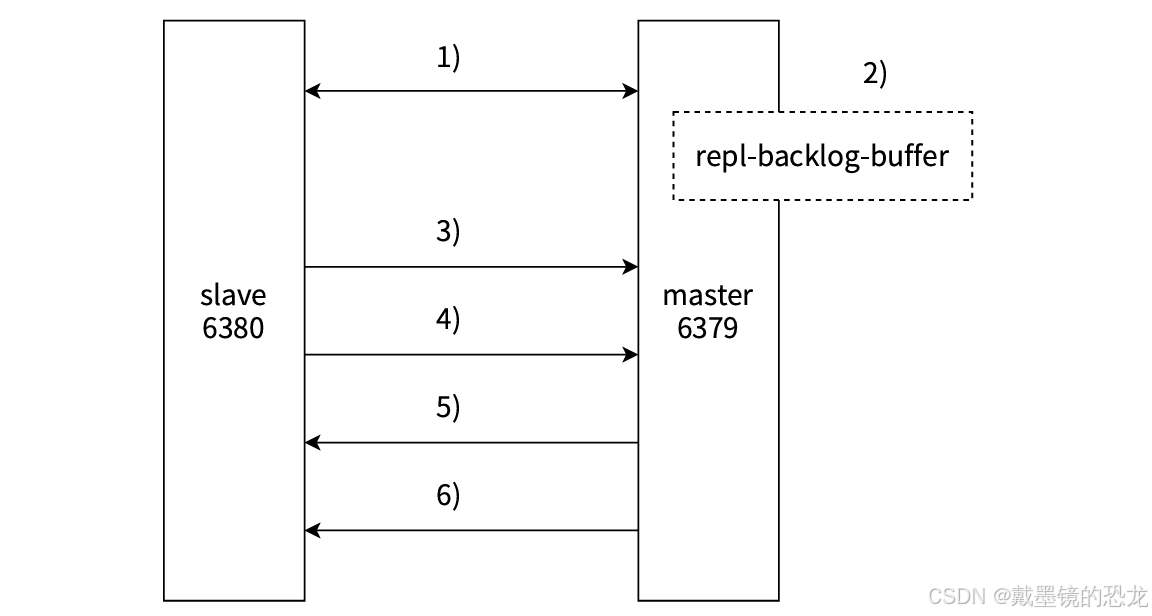
- 当主从节点之间出现⽹络中断时,如果超过
repl-timeout时间,主节点会认为从节点故障并终端复制连接。 - 主从连接中断期间主节点依然响应命令,但这些复制命令都因⽹络中断⽆法及时发送给从节点,所以暂时将这些命令滞留在复制积压缓冲区中。
- 当主从节点⽹络恢复后,从节点再次连上主节点。
- 从节点将之前保存的
replicationId和offset作为psync的参数发送给主节点,请求进⾏部分复制。 - 主节点接到psync请求后,进⾏必要的验证(进行全量/部分复制)。随后根据offset去复制积压缓冲区查找合适的数据,并响应+CONTINUE给从节点。
- 主节点将需要从节点同步的数据发送给从节点,最终完成⼀致性。
- 复制积压缓冲区是保存在主节点上的⼀个固定⻓度的队列,默认⼤⼩为1MB,当主节点有连接的从节点(slave)时被创建,这时主节点(master)响应写命令时,不但会把命令发送给从节点,还会写⼊复制积压缓冲区
- 由于缓冲区本质上是先进先出的定⻓队列,所以能实现保存最近已复制数据的功能,⽤于部分复制和复制命令丢失的数据补救。
- 如果当前从节点需要的数据,已经超出了主节点的积压缓冲区的范围,则⽆法进⾏部分复制,只能全量复制了.
3.3.4 实时复制
主从节点在建⽴复制连接后,主节点会把自己收到的修改操作,通过tcp⻓连接的⽅式,源源不断的传输给从节点。
从节点就会根据这些请求来同时修改自身的数据,从⽽保持和主节点数据的⼀致性。另外,这样的⻓连接,需要通过**⼼跳包**的⽅式来维护连接状态。(这⾥的⼼跳是指应⽤层⾃⼰实现的⼼跳,⽽不是TCP⾃带的⼼跳)
- 主从节点彼此都有⼼跳检测机制,各⾃模拟成对⽅的客⼾端进⾏通信。
- 主节点默认每隔10秒对从节点发送ping命令,判断从节点的存活性和连接状态。
- 从节点默认每隔1秒向主节点发送
replconfack {offset}命令,给主节点上报自身当前的复制偏移量。
如果主节点发现从节点通信延迟超过repl-timeout配置的值(默认60秒),则判定从节点下线,断开复制客⼾端连接;从节点恢复连接后,⼼跳机制继续进⾏。
主从复制的特点:
- Redis 通过复制功能实现主节点的多个副本。
- 主节点⽤来写,从节点⽤来读,这样做可以降低主节点的访问压⼒
- 复制⽀持多种拓扑结构,可以在适当的场景选择合适的拓扑结构。
- 复制分为全量复制,部分复制和实时复制。
- 主从节点之间通过⼼跳机制保证主从节点通信正常和数据⼀致性。
主从复制的缺点:
- 从机多了,复制数据的延时⾮常明显.
- 主机挂了,从机不会升级成主机,只能通过⼈⼯⼲预的⽅式恢复(后面引入哨兵机制自动对挂了的节点进行替换)