开篇
本文整理自《Python3 网络爬虫实战》,主要是httpx的使用。
笔记整理
使用urllib库requests库的使用,已经可以爬取绝大多数网站的数据,但对于某些网站依然无能为力。
这是因为这些网站强制使用HTTP/2.0协议访问,这时urllib和requests是无法爬取数据的,因为它们只支持HTTP/1.1,不支持HTTP/2.0。
安装
- 使用下面命令安装httpx
c
pip3 install -i https://pypi.tuna.tsinghua.edu.cn/simple some-package httpx[http2]基本使用
get
c
import httpx

# 定义重试次数
retry_count = 3
for i in range(retry_count):
    try:
        # 设置超时时间为 10 秒
        response = httpx.get('https://www.httpbin.org/get', timeout=10)
        print(response.status_code)
        print(response.headers)
        print(response.text)
        break
    except httpx.RequestError as e:
        print(f"请求失败,第 {i + 1} 次重试,错误信息: {e}")
else:
    print("多次重试后仍然失败,请检查网络或服务器状态。")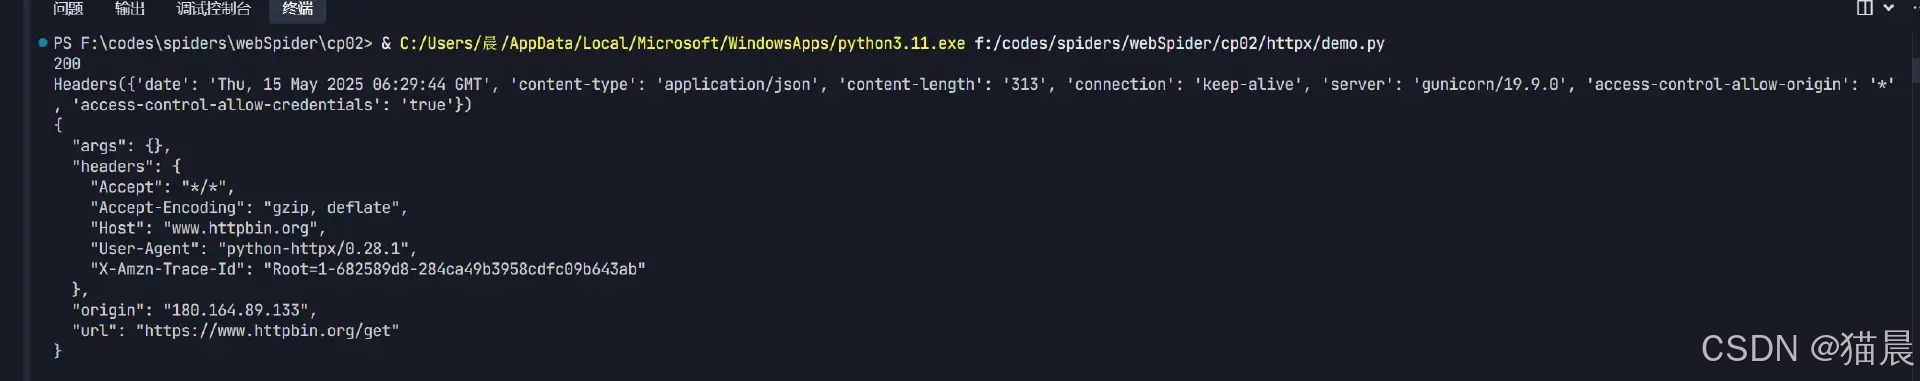
如果想要开启对HTTP/2.0的支持,需要手动声明一下:
c
import httpx

client = httpx.Client(http2=True)
response = client.get('https://spa16.scrape.center/')
print(response.text)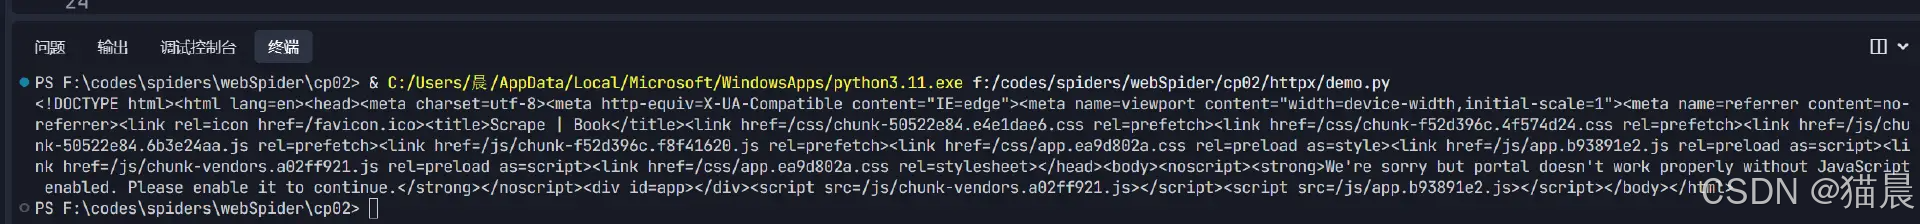
其他
上面实现的是GET请求,对于POST请求、PUT请求和DELETE请求来说,实现方式是类似的:
c
import httpx

r = httpx.get('https://www.httpbin.org/get',params={'name': 'germey'})
r = httpx.post('https://www.httpbin.org/post',data={'name': 'germey'})
r = httpx.put('https://www.httpbin.org/put')
r = httpx.delete('https://www.httpbin.org/delete')
r = httpx.patch('https://www.httpbin.org/patch')
Client对象
httpx中的Client对象,可以和requests中的Session对象类比学习。
官方比较推荐的是with as 语句,示例如下:
c
import httpx

with httpx.Client() as client:
  response = client.get('https://www.httpbin.org/get')
  print(response)
这个用法等同于下面这种:
c
import httpx

client = httpx.Client()
try:
  response = client.get('https://www.httpbin.org/get')
  print(response)
finally:
  client.close()
另外,在声明Client对象时可以指定一些参数,例如headers,这样使用该对象发起的所有请求都会默认带上这些参数配置:
c
import httpx

url = 'https://www.httpbin.org/headers'
headers = {'User-Agent': 'my-app/0.0.1'}
with httpx.Client(headers=headers) as client:
    response = client.get(url)
    print(response.json()['headers']['User-Agent'])
支持HTTP/2.0
要想开启对HTTP/2.0的支持,需要将http2设置为true
c
import httpx

client = httpx.Client(http2=True)
response = client.get('https://www.httpbin.org/get')
print(response.text)
print(response.http_version)
支持异步请求
c
import httpx
import asyncio

async def fetch(url):
  async with httpx.AsyncClient(http2=True) as client:
    response = await client.get(url)
    print(response.text)

if __name__ == '__main__':
  asyncio.get_event_loop().run_until_complete(fetch('https://www.httpbin.org/get'))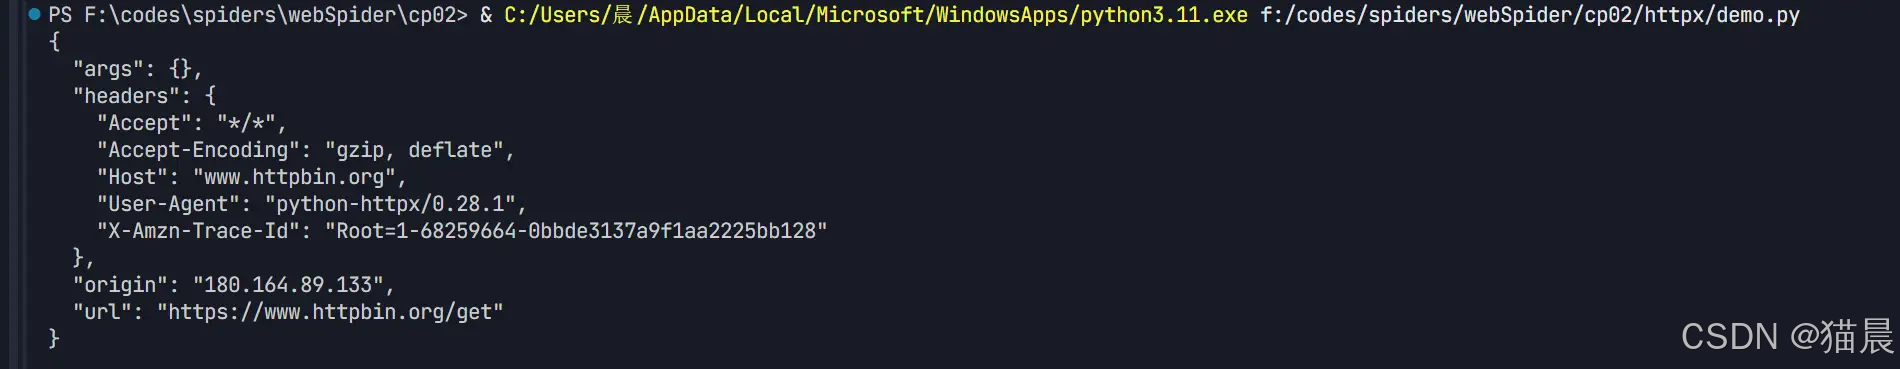
注
以上便是本篇笔记的所有整理,希望对您能有所帮助~
感谢阅读!