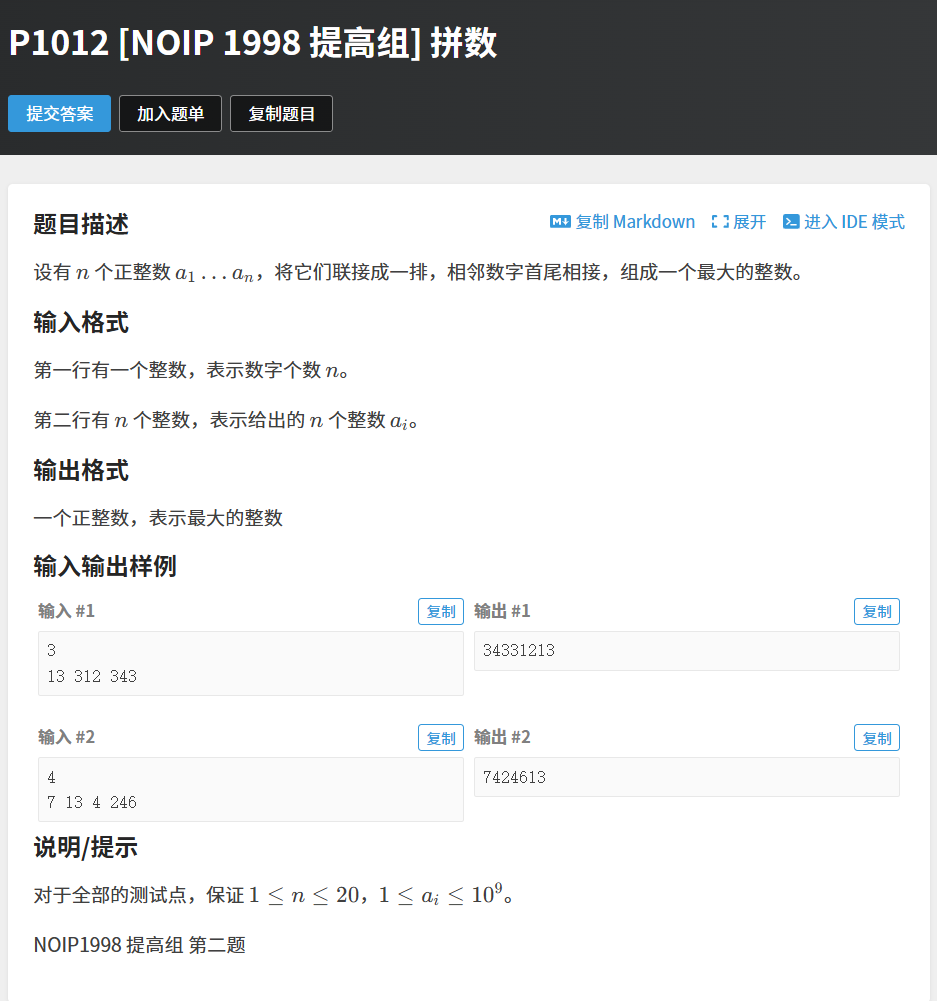
审题:
本题需要我们将数组中的数据经过排序,使得他们拼接后得到的数是所有拼接方案中最大的
思路:
方法一:排序贪心贪心策略1:直接排序
如果我们直接按照数组数据的字典序进行排序,会导致部分情况出错
eg:s1 = 35 ,s2 = 357
如果按照字典序直接排,那么此时会拼接位25257,而实际上我们可以拼接出更大的数据35735,所以直接将数据的字典序进行比较是错误的
贪心策略2:规则排序
排序规则:我们可以按照拼接后的数据的字典序进行判断
eg:a,b分别为数组中的数据(以string形式存储)
a+b > b+a:说明a数据放在前面可以得到更大的数
a+b < b+a:说明b数据放在前面可以得到更大的数
判断解析:我们先用+进行字符串连接,然后根据字典序进行判断大小(其实就是整形数据的判断方法,都是从最高位开始判断大小)
补充:排序贪心的使用前提
最终结果要对所有元素进行排序,且交换相邻元素顺序的时候不会影响其他元素
解题:
cpp#include<iostream> #include<algorithm> using namespace std; const int N = 30; int n; string a[N]; bool cmp(string& x, string& y) { return x+y > y+x; } int main() { cin >> n; for (int i = 0; i < n; i++) { cin >> a[i]; } sort(a, a + n, cmp); for (int i = 0; i < n; i++) { cout << a[i]; } return 0; }总体逻辑:
1.录入数据
2.按照规则进行排序
3.按照排好的顺序进行输出
其中cmp是一个仿函数,用于控制比较逻辑:
这里我们的比较逻辑是a+b > b+a就让a放前面,和前面分析的一样