知识点回顾:
PyTorch和cuda的安装
查看显卡信息的命令行命令(cmd中使用)
cuda的检查
简单神经网络的流程
数据预处理(归一化、转换成张量)
模型的定义
继承nn.Module类
定义每一个层
定义前向传播流程
定义损失函数和优化器
定义训练流程
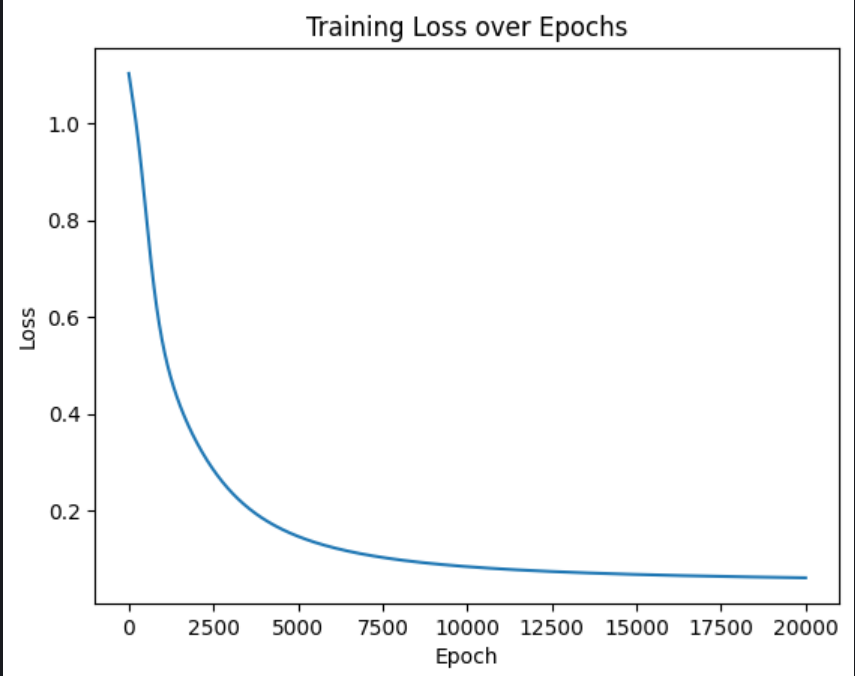
可视化loss过程
预处理补充:
注意事项:
-
分类任务中,若标签是整数(如 0/1/2 类别),需转为long类型(对应 PyTorch 的torch.long),否则交叉熵损失函数会报错。
-
回归任务中,标签需转为float类型(如torch.float32)。
作业:今日的代码,要做到能够手敲。这已经是最简单最基础的版本了。
python
import torch
import torch.nn as nn
import torch.optim as optim
from sklearn.preprocessing import MinMaxScaler
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
import numpy as np

if torch.cuda.is_available():
    print("CUDA可用!")
    # 获取可用的CUDA设备数量
    device_count = torch.cuda.device_count()
    print(f"可用的CUDA设备数量: {device_count}")
    # 获取当前使用的CUDA设备索引
    current_device = torch.cuda.current_device()
    print(f"当前使用的CUDA设备索引: {current_device}")
    # 获取当前CUDA设备的名称
    device_name = torch.cuda.get_device_name(current_device)
    print(f"当前CUDA设备的名称: {device_name}")
    # 获取CUDA版本
    cuda_version = torch.version.cuda
    print(f"CUDA版本: {cuda_version}")
else:
    print("CUDA不可用。")

# 加载4特征,3分类的鸢尾花数据集
iris = load_iris()
X = iris.data  # 特征数据
y = iris.target  # 标签数据

# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# # 打印下尺寸
# print(X_train.shape)
# print(y_train.shape)
# print(X_test.shape)
# print(y_test.shape)

# 归一化数据,神经网络对于输入数据的尺寸敏感,归一化是最常见的处理方式
scaler = MinMaxScaler()
X_train = scaler.fit_transform(X_train)
X_test = scaler.transform(X_test) #确保训练集和测试集是相同的缩放

# 转换为PyTorch张量
X_train=torch.FloatTensor(X_train)
X_test=torch.FloatTensor(X_test)
y_train=torch.LongTensor(y_train)
y_test=torch.LongTensor(y_test)

# print(X_train.shape)
# print(y_train.shape)
# print(X_test.shape)
# print(y_test.shape)

class MLP(nn.Module): # 定义一个多层感知机MLP模型,继承nn.Module类
    def __init__(self):
        super(MLP,self).__init__() #调用父类的构造函数
        self.fc1=nn.Linear(4,10) #输入层到隐藏层,4个特征,10个神经元
        self.relu=nn.ReLU() #激活函数
        self.fc2=nn.Linear(10,3) #隐藏层到输出层,10个神经元,3个类别

    def forward(self,x): #前向传播
        out=self.fc1(x) #输入层到隐藏层
        out=self.relu(out) #激活函数
        out=self.fc2(out) #隐藏层到输出层
        return out #返回输出层的结果

model=MLP() #实例化模型

criterion=nn.CrossEntropyLoss() #定义损失函数,交叉熵损失函数,适用于多分类问题

optimizer=optim.SGD(model.parameters(),lr=0.01) #定义优化器,随机梯度下降,学习率为0.01

num_epochs=20000 #定义训练轮数
losses=[] #定义一个列表,用于存储损失值
for epoch in range(num_epochs):
    outputs=model.forward(X_train) #前向传播,得到输出层的结果
    loss=criterion(outputs,y_train) #计算损失值,y_train是真实标签,outputs是模型的预测值
    losses.append(loss.item()) #记录损失值

    optimizer.zero_grad() #清空梯度
    loss.backward() #反向传播,计算梯度
    optimizer.step() #更新参数

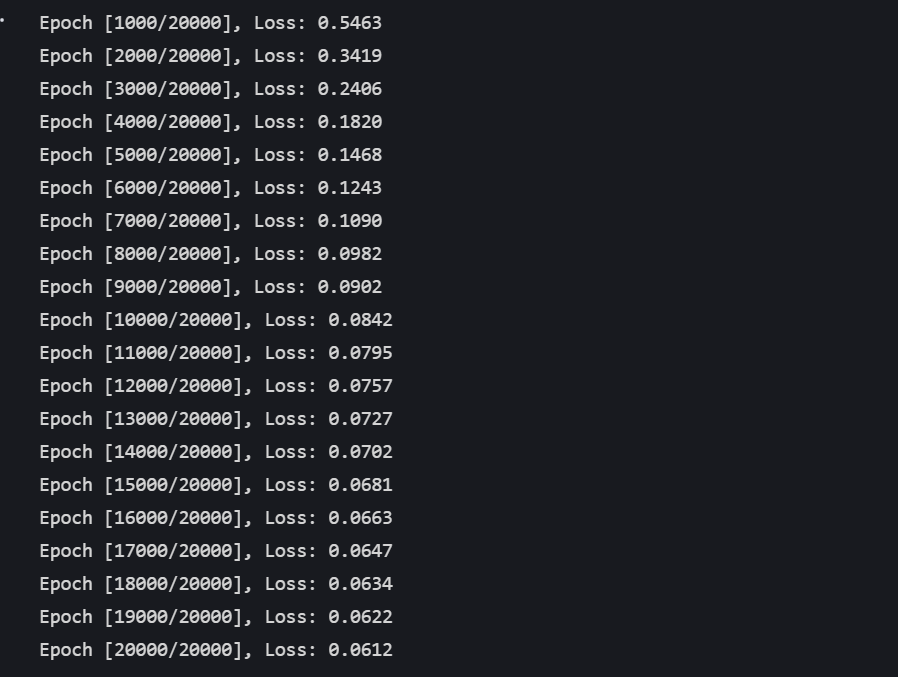
    if (epoch+1)%1000==0: #每10000轮输出一次损失值
        print(f'Epoch [{epoch+1}/{num_epochs}], Loss: {loss.item():.4f}')

import matplotlib.pyplot as plt
# 可视化损失曲线
plt.plot(range(num_epochs), losses)
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.title('Training Loss over Epochs')
plt.show()