文章目录
- [1 工作原理](#1 工作原理)
- [2 常见优化器](#2 常见优化器)
-
- [2.1 SGD](#2.1 SGD)
- [2.2 Adam](#2.2 Adam)
- [3 优化器参数](#3 优化器参数)
- [4 学习率](#4 学习率)
- [5 使用最佳实践](#5 使用最佳实践)
本文环境:
- Pycharm 2025.1
- Python 3.12.9
- Pytorch 2.6.0+cu124
优化器 (Optimizer) 是深度学习中的核心组件,负责根据损失函数的梯度来更新模型的参数,使模型能够逐步逼近最优解。在 PyTorch 中,优化器通过torch.optim模块提供。
Pytorch 链接:https://docs.pytorch.org/docs/stable/optim.html。
1 工作原理
优化器的工作流程如下:
- 计算损失函数的梯度 (通过
backward()方法)。 - 根据梯度更新模型参数 (通过
step()方法)。 - 清除之前的梯度 (通过
zero_grad()方法)。
python
result_loss.backward()  # 计算梯度
optim.step()           # 更新参数
optim.zero_grad()      # 清除梯度
2 常见优化器
PyTorch 提供多种优化器,以 SGD 和 Adam 为例。
2.1 SGD
基础优化器,可以添加动量 (momentum) 来加速收敛。
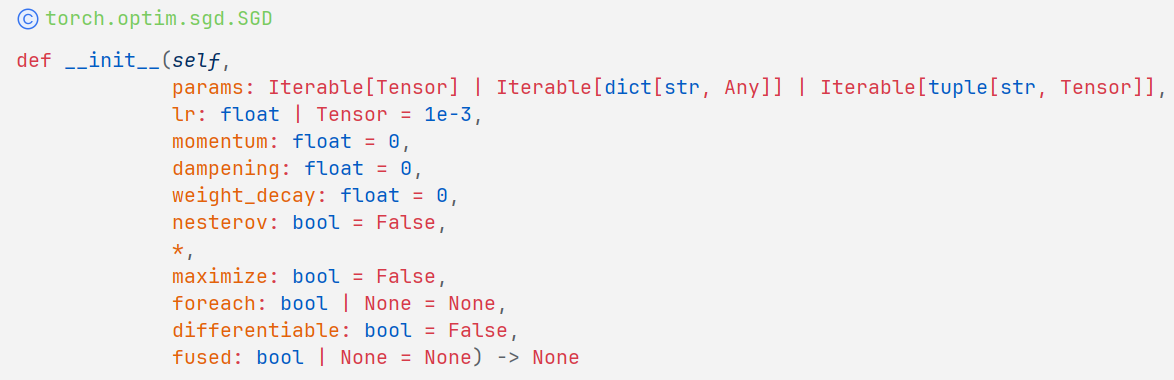
| 参数 | 类型 | 默认值 | 作用 | 使用建议 |
|---|---|---|---|---|
| params | iterable | - | 待优化参数 | 必须传入model.parameters()或参数组字典,支持分层配置 |
| lr | float | 1e-3 | 学习率 | 控制参数更新步长,SGD常用0.01-0.1,Adam常用0.001 |
| momentum | float | 0 | 动量因子 | 加速梯度下降(Adam内置动量,无需单独设置) |
| dampening | float | 0 | 动量阻尼 | 抑制动量震荡(仅当momentum>0时生效) |
| weight_decay | float | 0 | L2正则化 | 防止过拟合,AdamW建议0.01-0.1 |
| nesterov | bool | False | Nesterov动量 | 改进版动量法(需momentum>0) |
| maximize | bool | False | 最大化目标 | 默认最小化损失,True时改为最大化 |
| foreach | bool | None | 向量化实现 | CUDA下默认开启,内存不足时禁用 |
| differentiable | bool | False | 可微优化 | 允许优化器步骤参与自动微分(影响性能) |
| fused | bool | None | 融合内核 | CUDA加速,支持float16/32/64/bfloat16 |
2.2 Adam
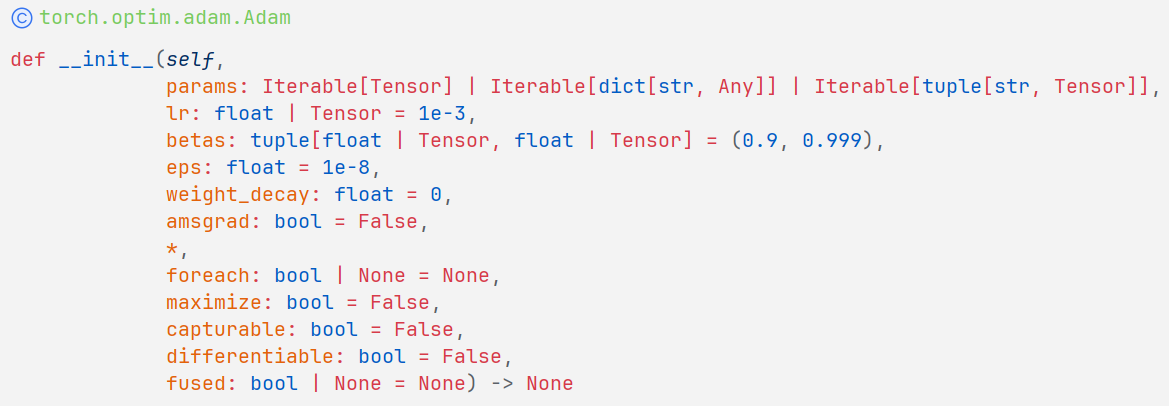
- 特点:自适应矩估计,结合了动量法和 RMSProp 的优点。
- 优点:通常收敛速度快,对学习率不太敏感。
| 参数名称 | 类型 | 默认值 | 作用 | 使用建议 |
|---|---|---|---|---|
| params | iterable | - | 需要优化的参数(如model.parameters()) |
必须传入,支持参数分组配置 |
| lr | float | 1e-3 | 学习率(控制参数更新步长) | 推荐0.001起调,CV任务可尝试0.0001-0.01 |
| betas | (float, float) | (0.9, 0.999) | 梯度一阶矩(β₁)和二阶矩(β₂)的衰减系数 | 保持默认,除非有特殊需求 |
| eps | float | 1e-8 | 分母稳定项(防止除以零) | 混合精度训练时可增大至1e-6 |
| weight_decay | float | 0 | L2正则化系数 | 推荐0.01-0.1(使用AdamW时更有效) |
| decoupled_weight_decay | bool | False | 启用AdamW模式(解耦权重衰减) | 需要权重衰减时建议设为True |
| amsgrad | bool | False | 使用AMSGrad变体(解决收敛问题) | 训练不稳定时可尝试启用 |
| foreach | bool | None | 使用向量化实现加速(内存消耗更大) | CUDA环境下默认开启,内存不足时禁用 |
| maximize | bool | False | 最大化目标函数(默认最小化) | 特殊需求场景使用 |
| capturable | bool | False | 支持CUDA图捕获 | 仅在图捕获场景启用 |
| differentiable | bool | False | 允许通过优化器步骤进行自动微分 | 高阶优化需求启用(性能下降) |
| fused | bool | None | 使用融合内核实现(需CUDA) | 支持float16/32/64时启用可加速 |
3 优化器参数
所有优化器都接收两个主要参数:
params:要优化的参数,通常是model.parameters()。lr:学习率(learning rate),控制参数更新的步长。
其他常见参数:
weight_decay:L2 正则化系数,防止过拟合。momentum:动量因子,加速 SGD 在相关方向的收敛。betas(Adam 专用):用于计算梯度及其平方的移动平均的系数。
4 学习率
学习率是优化器中最重要的超参数之一。
- 太大:可能导致震荡或发散。
- 太小:收敛速度慢。
- 常见策略:
- 固定学习率 (如代码中的 0.01)。
- 学习率调度器 (Learning Rate Scheduler) 动态调整。
5 使用最佳实践
- 梯度清零 :每次迭代前调用
optimizer.zero_grad(),避免梯度累积。 - 参数更新顺序 :先
backward()再step()。 - 学习率选择:可以从默认值开始 (如 Adam 的 0.001),然后根据效果调整。
python
import torch
import torchvision
from torch import nn
from torch.utils.data import DataLoader

dataset = torchvision.datasets.CIFAR10(
    root='./dataset',  # 保存路径
    train=False,  # 是否为训练集
    transform=torchvision.transforms.ToTensor(),  # 转换为张量
    download=True  # 是否下载
)

dataloader = DataLoader(dataset, batch_size=1)


class MyModel(nn.Module):
    def __init__(self):
        super(MyModel, self).__init__()
        self.model = nn.Sequential(
            nn.Conv2d(3, 32, 5, 1, 2),
            nn.MaxPool2d(2),
            nn.Conv2d(32, 32, 5, 1, 2),
            nn.MaxPool2d(2),
            nn.Conv2d(32, 64, 5, 1, 2),
            nn.MaxPool2d(2),
            nn.Flatten(),
            nn.Linear(64 * 4 * 4, 64),
            nn.Linear(64, 10)
        )

    def forward(self, x):
        return self.model(x)


loss = nn.CrossEntropyLoss()
model = MyModel()
torch.optim.Adam(model.parameters(), lr=0.01)
optim = torch.optim.SGD(model.parameters(), lr=0.01)

for epoch in range(20):
    running_loss = 0.0
    # 遍历dataloader中的数据
    for data in dataloader:
        # 获取数据和标签
        imgs, targets = data
        # 使用模型对数据进行预测
        output = model(imgs)
        # 计算预测结果和真实标签之间的损失
        result_loss = loss(output, targets)
        # 将梯度置零
        optim.zero_grad()
        # 反向传播计算梯度
        result_loss.backward()
        # 更新模型参数
        optim.step()
        running_loss += result_loss

    print(f'第 {epoch + 1} 轮的损失为 {running_loss}')