一、ONNX概述
ONNX(开放式神经网络交换格式) 是一种用于表示深度学习模型的跨框架标准,旨在解决不同框架间模型部署的兼容性问题。由微软、Facebook、AWS、NVIDIA等公司于2017年联合发起,目前由 ONNX开源社区 维护。其核心目标是实现模型在训练框架(如PyTorch、TensorFlow)和推理引擎(如ONNX Runtime、TensorRT)之间的无缝迁移。
二、ONNX核心概念
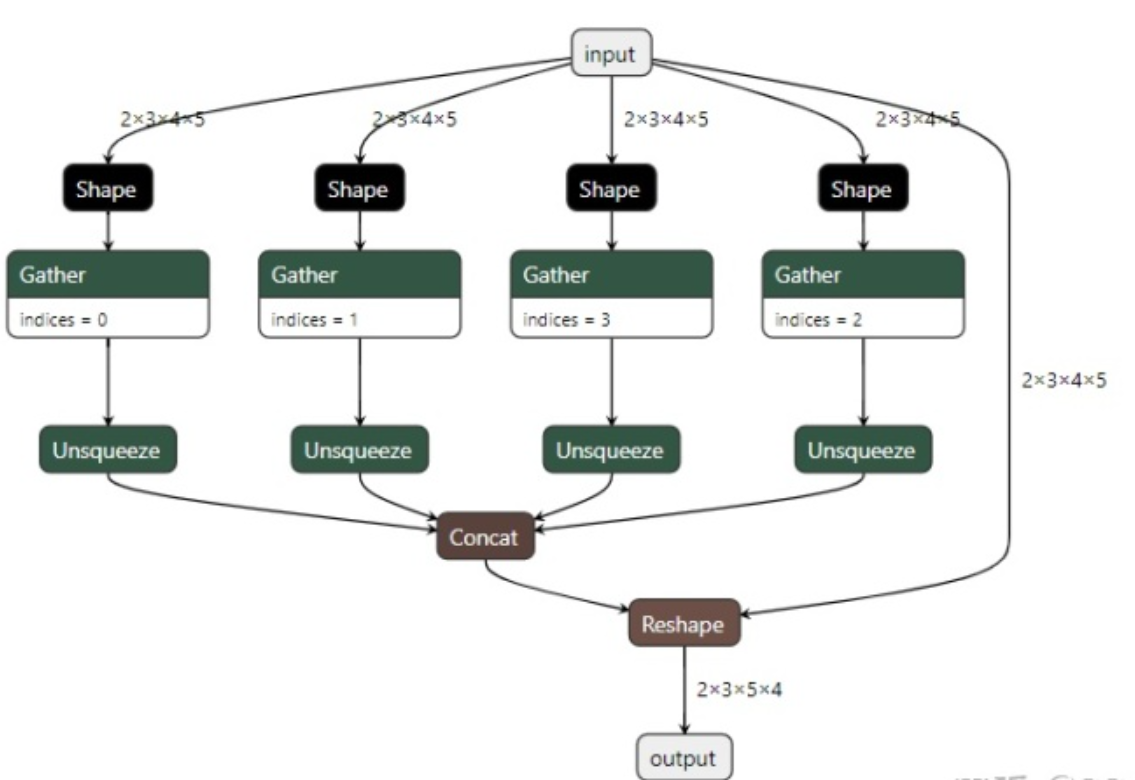
1. 模型结构:图(Graph)与节点(Node)
- 图(Graph) :
ONNX模型本质上是一个有向无环图(DAG),由节点(Node)和边(Edge)组成。- 节点:表示算子(Operator,如卷积、全连接)或数据操作(如常量、输入/输出)。
- 边 :表示数据流动,携带张量(Tensor)或值(Value)。
- 输入/输出(Input/Output) :
图的入口和出口,定义模型的输入输出规格(名称、数据类型、形状)。 - 初始值(Initializer) :
存储模型的可学习参数(如权重、偏置),通常为常量张量。
2. 张量(Tensor)与数据类型
- 张量 :
多维数组,是ONNX中数据的基本单位,由以下属性定义:- 数据类型 :支持基础类型(如
float32、int64、bool)、复合类型(如字符串)及复杂类型(如张量列表)。 - 形状(Shape) :可以是静态形状(固定尺寸)或动态形状(用符号表示,如
None或自定义变量N)。
- 数据类型 :支持基础类型(如
- 数据类型规范 :
每个张量必须明确类型,通过onnx.TensorProto.DataType枚举定义(如FLOAT对应float32,INT64对应int64)。
3. 算子(Operator,简称Op)
- 算子定义 :
算子是图的基本计算单元,由类型名 (如Conv、Gemm)、属性 (如卷积核大小、步长)和输入输出列表组成。 - 算子集(Operator Set) :
ONNX通过算子集管理算子版本,确保向后兼容。每个算子有明确的版本号,不同框架可能支持不同版本的算子。 - 自定义算子(Custom Operator) :
允许用户扩展算子,但需在推理引擎中注册实现,否则可能导致解析失败。
三、ONNX文件格式与序列化
1. 物理存储结构
- 基于Protobuf(Protocol Buffers) :
ONNX模型使用Google的Protobuf进行序列化,存储为二进制文件(.onnx扩展名),结构包含:- 版本信息:ONNX格式版本、算子集版本、生产者信息(如框架名称)。
- 模型元数据:模型名称、描述、输入输出说明等。
- 图结构:节点、边、初始值等核心内容。
- 文本格式(可选) :
可通过工具将二进制模型转换为可读的文本格式(.prototxt),用于调试。
2. 关键字段解析
protobuf
syntax = "proto3";
package onnx;

message Model {
  ModelProto model = 1;  // 模型主体
  int32 ir_version = 2;   // IR版本(ONNX格式版本)
  repeated OperatorSetId opset_import = 3;  // 算子集依赖
  ...
}

message ModelProto {
  Graph graph = 1;        // 图结构
  string producer_name = 2;  // 生产者(如PyTorch)
  ...
}

message Graph {
  string name = 1;        // 图名称
  repeated ValueInfoProto input = 2;  // 输入定义
  repeated ValueInfoProto output = 3; // 输出定义
  repeated TensorProto initializer = 4; // 初始值(权重)
  repeated NodeProto node = 5;         // 节点列表
  ...
}
四、动态形状与符号推理
- 静态形状 vs. 动态形状 :
- 静态形状 :输入输出形状在模型中固定(如
[3, 224, 224]),适合固定尺寸输入的推理。 - 动态形状 :使用符号(如
None或自定义变量N)表示可变维度,例如[N, 3, H, W],支持批量大小或图像尺寸可变的场景。
- 静态形状 :输入输出形状在模型中固定(如
- 实现方式 :
- 通过
onnx.shape_inference模块推断动态形状下的张量尺寸。 - 推理引擎(如ONNX Runtime)需支持动态形状绑定,运行时指定具体数值。
- 通过
五、模型转换与兼容性
1. 主流框架转换流程
| 源框架 | 转换工具/接口 | 注意事项 |
|---|---|---|
| PyTorch | torch.onnx.export() |
需使用torch.jit.trace或torch.jit.script固化动态图 |
| TensorFlow | tf2onnx 库 |
需处理TF算子与ONNX算子的映射(如tf.nn.conv2d→Conv) |
| Keras | 通过TensorFlow转换或keras2onnx库 |
注意层融合(如BatchNormalization可能被折叠) |
| Caffe2 | 原生支持保存为ONNX | 需确保算子在ONNX算子集中存在 |
2. 常见兼容性问题
- 算子不支持 :
某些框架特有的算子(如PyTorch的torch.nn.functional.gelu早期版本需手动替换为ONNX的Gelu)。 - 动态图处理 :
PyTorch的动态控制流(如if-else)需通过torch.onnx.export的dynamic_axes参数显式声明动态维度。 - 精度差异 :
框架在转换时可能自动插入类型转换算子(如Cast),需验证数值一致性。
六、模型优化与推理
1. 优化工具链
- ONNX Runtime(ORT) :
微软开发的高性能推理引擎,内置优化 passes,如:- 常量折叠(Constant Folding):提前计算固定输入的节点输出。
- 算子融合(Operator Fusion) :合并连续算子(如
Conv + BatchNorm + ReLU→FusedConv)。 - 硬件加速:利用CPU(AVX/AVX2)、GPU(CUDA)或NNAPI等后端优化计算。
- TensorRT :
NVIDIA的推理优化器,支持将ONNX模型编译为特定GPU的高效引擎,尤其适合CUDA设备。
2. 推理流程
python
# 使用ONNX Runtime推理示例
import onnxruntime as ort
import numpy as np

# 加载模型
session = ort.InferenceSession("model.onnx")

# 准备输入(需匹配模型定义的形状和数据类型)
input_name = session.get_inputs()[0].name
input_data = np.random.randn(1, 3, 224, 224).astype(np.float32)

# 推理
outputs = session.run(None, {input_name: input_data})
七、调试与验证工具
-
Netron :
在线模型可视化工具(https://netron.app),支持查看图结构、张量形状和算子属性。 -
onnx.checker :
内置工具,用于验证模型的语法和语义正确性:pythonimport onnx model = onnx.load("model.onnx") onnx.checker.check_model(model) # 抛出异常表示模型有误 -
onnxruntime.utils.convert_model_to_ort_format :
检查模型是否符合ONNX Runtime的优化要求。
八、生态系统与扩展
1. 支持的推理引擎
| 引擎名称 | 特点 | 典型场景 |
|---|---|---|
| ONNX Runtime | 跨平台(CPU/GPU/边缘设备),官方支持 | 通用推理 |
| TensorRT | NVIDIA GPU深度优化,高吞吐低延迟 | 数据中心推理 |
| MNN | 阿里轻量级引擎,支持移动端 | 手机/嵌入式设备 |
| TNN | 腾讯开源引擎,跨平台优化 | 多端部署 |
| Core ML | Apple生态专用,支持iOS/macOS | 苹果设备端推理 |
2. 模型动物园与工具链
- ONNX Model Zoo :
官方维护的预训练模型仓库,涵盖CV、NLP等领域(如ResNet、BERT)。 - 转换脚本库 :
社区提供的框架转换示例(如PyTorch到ONNX的脚本),可通过GitHub或PyPI获取。 - 量化工具 :
onnxruntime.quantization支持模型量化(FP32→INT8),降低计算成本。
九、版本管理与发展趋势
1. 版本兼容性
- 格式版本(IR Version) :
每次重大更新会提升IR版本(如v1.13.0引入新算子),旧版本工具可能无法解析新版本模型。 - 算子版本(Operator Version) :
算子可能随版本迭代改变行为(如参数顺序调整),需通过opset_import指定依赖的算子集版本。
2. 未来发展方向
- 动态图支持:增强对控制流(循环、条件判断)的原生支持,减少框架转换时的限制。
- 新型硬件支持:扩展对TPU、NPU等专用加速器的优化,完善异构计算支持。
- 模型加密与压缩:探索ONNX层面的模型加密技术,集成更多压缩算法(如剪枝、蒸馏)。
- 生态整合:与MLflow、TensorFlow Lite等工具深度集成,简化端到端部署流程。
十、典型应用场景
- 多框架部署 :
训练用PyTorch,推理用ONNX Runtime/TensorRT,避免被单一框架锁定。 - 边缘计算 :
将模型转换为ONNX后,通过轻量级引擎(如MNN)部署到手机、IoT设备。 - 模型优化与加速 :
利用ONNX的中间表示(IR)进行跨框架优化,提升推理效率。 - 研究协作 :
通过ONNX共享模型结构,方便不同团队复现实验结果。
总结
ONNX通过标准化模型表示,解决了深度学习领域"框架碎片化"的核心痛点,成为连接训练与推理的桥梁。掌握ONNX的关键在于理解其图结构、算子规范和转换流程,同时熟悉生态工具链以应对实际部署中的挑战。随着社区的持续发展,ONNX正逐步成为AI模型跨平台部署的事实标准。