【Hadoop】HDFS 分布式存储系统

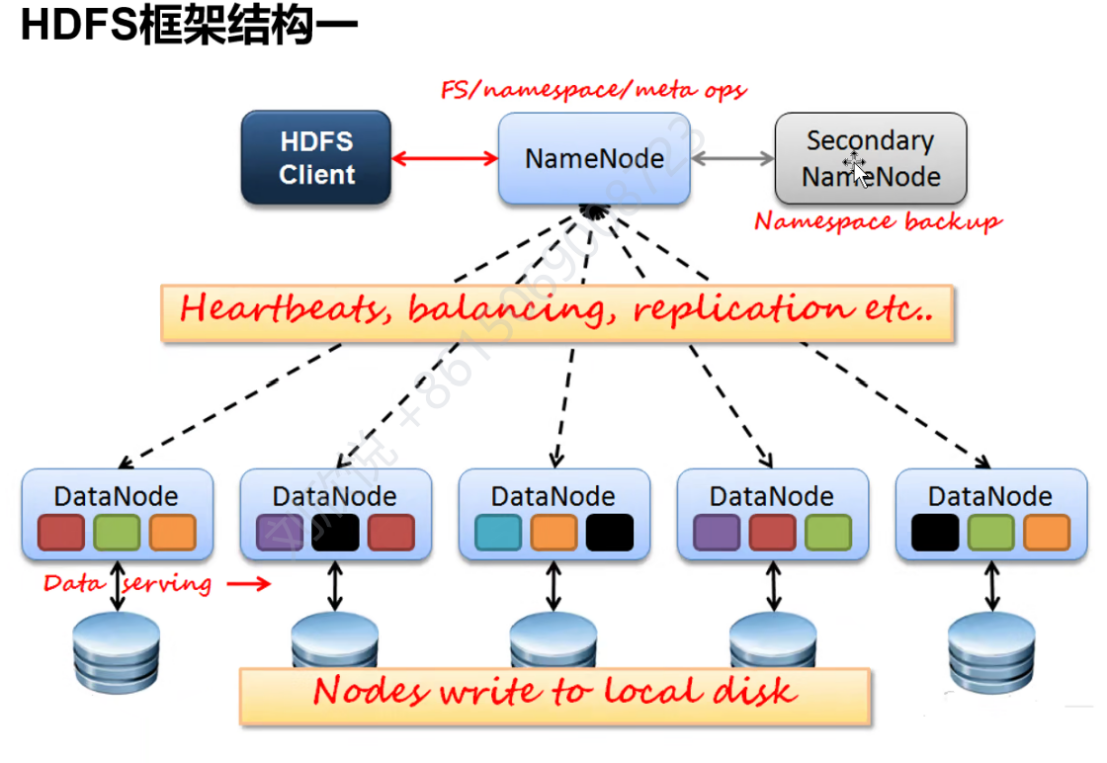
Namenode是整个HDFS文件系统的前端,只有一个,管理数据块映射信息,配置副本策略,处理客户端的读写请求。

Secondary namenode是namenode的热备,当active namenode出现故障时,快速切换为新的active namenode。定期更新系统镜像和操作日志。

Datanode有多个,存储数据块,执行数据块读写。

HDFS client与文件系统进行交互。

文件被切分成数据块,分布存储,默认情况下每个块有三个副本。

HDFS不适合保存小文件。一个k和一个t数据块的元数据大小是相同的,元数据会存储在namenode,但namenode内存是有限的。大小文件的访问速度相同,存取大量小文件浪费很多寻道时间。

相关推荐
方方洛4 小时前
ray教程-28-附录G-CICD与Slurm与云上调度
人工智能·分布式·机器学习
空奈qwq7 小时前
【Kafka 从入门到实战】从手写一个队列到生产级消息中间件:架构、分区、消费组、零拷贝全解析
分布式·架构·kafka
山甫aa1 天前
锁一篇搞定:乐观锁、悲观锁、CAS、数据库锁与分布式锁【从零开始的 Web 后端学习】
java·数据库·分布式·后端·学习·web
严肃小白兔2 天前
Cloudflare Durable Objects 支持自动重试:分布式调用如何避免重复执行?
分布式
方方洛2 天前
ray教程-27-附录F-RayClient与runtime_env与多语言
人工智能·分布式·机器学习
方方洛3 天前
ray教程-25-附录E-端到端实战案例
人工智能·分布式·机器学习
Francek Chen3 天前
【大数据处理与分析】数据仓库Hive:09 Hive 编程实践
大数据·数据仓库·hive·hadoop·sql
迅翼SwiftWing4 天前
编队系列(二)|固定翼如何依靠邻居信息保持队形?一致性控制、通信拓扑与分布式仿真实现,附仿真代码
分布式
ly76894 天前
幂等消费者与重试副作用:Kafka 端点接入时的去重边界
分布式·kafka·linq·apache camel·幂等消费者·重试副作用·去重边界
qq_452396234 天前
第三篇:《从 ZooKeeper 到 KRaft 的迁移实战:前置条件、三阶段流程与回滚策略》
分布式·zookeeper·云原生