1. 为什么 Kafka 需要复制机制
这里以一个旅游预订网站来说明(比如飞猪),后台用 Kafka 来处理用户的预订请求。每一条用户的预订信息会作为一条消息存储到某个 topic 中。这个 topic 被分成了多个 分区(partition) ,而每个分区存储在一个 broker 上。
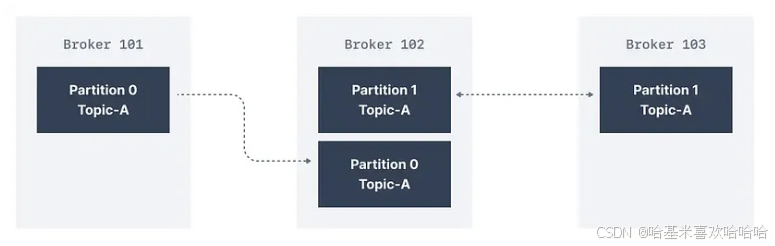
如果其中一个存放分区的 broker 挂掉了会怎样?
你会失去访问该分区数据的能力------除非你提前进行了复制。Kafka 的复制机制保证了每个分区在不同的 broker 上都有冗余副本。当某个 broker 出现故障时,Kafka 会在其他副本中选举出一个新的 leader,继续对外提供服务,从而实现零停机且不丢失数据。
2. 数据分布与复制机制
Kafka 会将 topic 拆分为多个 分区 ,每个分区本质上是一个日志文件 ,里面的消息按 offset 顺序排列。
为了实现高可用 ,Kafka 会把每个分区的副本分布到不同的 broker 上。副本的数量称为 replication factor(副本因子) 。如果一个 topic 的副本因子是 3,那它的每个分区都会在 3 个不同的 broker 上各保存一份。
每个分区包含:
- 1个Leader 副本:处理所有的读写请求。
- 1个或多个Follower 副本:从 leader 异步拉取数据,保持同步,一旦 leader 崩溃可以顶上。
- ISR(In-Sync Replicas)列表:当前与 leader 保持同步的所有 follower 副本。
java
// 假设分区 P0 的副本因子是 3,情况大概是这样的:
Partition P0  (replication factor = 3)
+----------+    +----------+    +----------+
| Broker 1 | <- | Broker 2 | <- | Broker 3 |
| Leader   |    | Follower |    | Follower |
+----------+    +----------+    +----------+
3. 故障处理
当一个 broker 出现故障时,Kafka会自动从 ISR 列表中挑选一个最新的 follower 副本升级为新的 leader。挂掉的 broker 重新上线后会自动加入 ISR,重新开始同步数据,成为 follower。
并不是所有 follower 都能被选为 leader,Kafka 只会从 ISR 中挑选,因为只有 ISR 中的副本数据和 leader 完全一致。
3.1 副本同步延迟的判断标准
Kafka 通过两个阈值来判断某个 follower 是否落后:
(1) 消息积压(Message Lag)
如果某个 follower 落后于 leader 超过 499 条消息,Kafka 会把它移出 ISR。
yml
replica.lag.max.messages=500(2) 时间延迟(Time Lag)
如果 follower 超过 10 秒没有从 leader 拉取数据,同样会被认为同步程度不够,并被移出 ISR。
yml
replica.lag.time.max.ms=10000通过调整这两个参数,可以精细控制系统对"慢副本"的容忍度。
3.2 副本滞后的原因
- 慢副本(Slow Replica):Follower 健康但速度赶不上 leader,可能是磁盘 IO、网络带宽或 CPU 瓶颈。
- 卡死副本(Stuck Replica):Follower 完全不拉数据,可能是 GC 暂停、死锁或者进程挂了。
常用的监控指标:
- UnderReplicatedPartitions:当前副本数不足的分区数量
- IsrShrinksPerSec:ISR 缩减的频率
- ReplicaFetcherLag:副本同步延迟
4. 生产者确认机制(acks)
Kafka 生产者通过 acks 参数决定写入成功的确认标准:
java
Properties props = new Properties();
props.put("acks", "all"); // 可选值: 0, 1, allacks=0:发后即忘,不关心 broker 是否写成功,速度最快,可靠性最低。acks=1:只等 leader 写入成功再确认,性能与可靠性折中。acks=all:等到所有 ISR 副本都写入成功后才返回,最安全,适用于关键业务,比如金融交易。
5. Kafka 如何跟踪 ISR
Kafka 的 leader 会持续监控所有 follower 的同步状态。如果某个副本长时间拉取不到数据,或者落后过多,就会被踢出 ISR。Kafka 有一个关键保证:
即便leader 在确认后立刻宕机, 只要生产者收到的确认是"所有 ISR 副本都写入成功",那这条消息不会丢失 。
6. 如果所有副本都挂了怎么办?
这种情况比较罕见,但如果真的发生,Kafka 提供两种策略:
- 等待 ISR 中的副本恢复(默认):优先保证数据一致性。
- 提升任意一个最先恢复的副本:保证可用性,但可能导致数据回滚。