1 内核冻结的实现
由触发的流程可知,我们最后是通过调用cgroup 中间抽象层的 API,进而通过 cgroup 实现进程的冻结功能,那么cgroup 中间抽象层是什么,cgroup又是什么呢?
cgroup 是什么?:
cgroup 最初由 Google 工程师 Paul Menage 和 Rohit Seth 在 2006 年提出,是一种细粒度资源控制的Linux内核机制。于 2007 年合并到 Linux 内核主线中。然而 Google 原生系统直到 Android 11 或更高版本上才支持 CACHE 应用的 CPU 冻结功能。当应用切换到后台并且没有其他活动时,系统会在一定时间内通过状态判断,将进程 ID 迁移到冻结的 cgroup 节点上,实现冻结 CACHE 应用。这项功能可以减少活跃缓存应用在后台存在时所消耗的 CPU 资源,从而达到节电的目的。当应用再次切换到前台时,系统会将该应用的进程解冻,以实现快速启动。
"cgroup"指的是 Control Group(控制组),这是 Linux 内核中的一种资源管理机制。cgroup 提供一种机制,可将任务集(包括进程、线程及其所有未来的子级)聚合并分区到具有专门行为的层级组中,它就像给进程分组并制定资源使用规则的"管理员",通过它的各种子系统,比如这里提到的 freezer 子系统,能实现对进程资源使用的控制和特殊操作,像在进程无感知的情况下将其冻结。
cgroup 中间抽象层:
Android 10 及更高版本将对照组 (cgroup) 抽象层和任务配置文件搭配使用,让开发者能够使用它们来描述应用于某个线程或进程的一组(或多组)限制。
然后,系统按照任务配置文件的规定操作来选择一个或多个适当的 cgroup;通过这种方式,系统可以应用各种限制,并对底层 cgroup 功能集进行更改,而不会影响较高的软件层
简而言之,cgroup 中间抽象层就像是对cgroup 机制进行的一种更高层次的封装或概括,以方便上层管理和使用cgroup的功能,cgroup 本身就像是一堆复杂的零部件,而 cgroup抽象层则是把这些零部件组装成一个易用的工具,让开发者不需要深入了解cgroup的底层细节,就能直接使用它提供的一些常见功能。
那么针对我们的系统来讲,从Android10及更高版本上,cgroup配置就是./system/core/libprocessgroup/profiles/cgroups.json,任务配置文件就是./system/core/libprocessgroup/profiles/task_profiles.json,都在libprocessgroup下,在libprocessgroup中,在启动阶段,会根据cgroups.json 来装载具体的cgroup,然后根据task_profiles.json定义具体对cgroup的操作和参数。
两者搭配起来使用libprocessgroup也就是说的cgroup 中间抽象层。
1.1 cgroups.json
在cgroups.json文件中描述cgroups配置,以此定义cgroups组以及他们的挂载点和attibutes。所有的cgroups将在early-init阶段被挂载上,cgroups和cgroups2的两个版本 ,V1和V2,这两个版本是共存的,可以同时使用
Controller:指定 cgroups 子系统名称,之后 task profiles 中设定需要依赖该名称
Path:指定挂载的路径,有了该路径 task profiles 下才可以指定文件名;
Mode: 用于指定Path 目录下文件的执行 mode
如freezer,定义了Controller为freezer,会在path为/sys/fs/cgroup的路径下
{ "Cgroups": [ { "Controller": "blkio", "Path": "/dev/blkio", "Mode": "0775", "UID": "system", "GID": "system" }, { "Controller": "cpu", "Path": "/dev/cpuctl", "Mode": "0755", "UID": "system", "GID": "system" }, { "Controller": "cpuset", "Path": "/dev/cpuset", "Mode": "0755", "UID": "system", "GID": "system" } ], "Cgroups2": { "Path": "/sys/fs/cgroup", "Mode": "0775", "UID": "system", "GID": "system", "Controllers": [ { "Controller": "freezer", "Path": "." }, { "Controller": "memory", "Path": ".", "NeedsActivation": true, "MaxActivationDepth": 3, "Optional": true } ] }}cgroups文件可能不止有一个
一般有三类:
/system/core/libprocessgroup/profiles/cgroups.json //默认文件
/system/core/libprocessgroup/profiles/cgroups_.json //API级别的文件
/vendor/xxx/cgroups.json //自定义文件
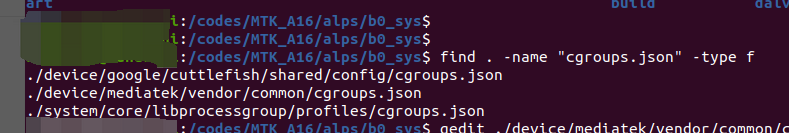
三种文件加载顺序是:默认 -> API 级别 -> vendor,所以这三个是存在一个覆盖关系的,只要后面的文件中定义的 Controller 值与前面的相同,就会覆盖前者的定义
1.2 task_profiles.json
task_profiles.json定义具体对cgroup的操作和参数,描述要应用于进程或线程的一组特定操作,主要是三个字段"Attributes","Profiles","AggregateProfiles"
Attributes:
Name定义Profiles操作时的名称
Controller是引用cgroups.json对应的控制器
File是对应的节点文件
如这里定义的冻结相关的 name是"FreezerState",对应操作属性就是FreezerState,Controller是"freezer",就是前面cgroups.json里面定义的控制器,File 是"cgroup.freeze",最终写的节点为"cgroup.freeze"。
Profiles:
Name定义对应的操作名字
Actions定义这个Profiles被调用时,应该执行的操作集合,再里面的Name和Params就是对应的操作类别和参数
以冻结为例,就是当调用Frozen这个Profile的时候,执行的action是SetAttribute,设置属性,对应的参数是FreezerState,value是1
同cgroups.json,它也是可能不止一个文件,加载顺序和覆盖关系也是和cgroups.json一样
AggregateProfiles:
Name定义对应的操作名字
Profiles定义是上面Profile一个集合,相当于是组合使用不同的Profile
从这个文件我们就能联想到,在上面setProcessFrozen方法,最后去写入的值,就是去调用了对应的Profiles --->Frozen,我们继续往下看调用的流程
{ "Attributes": [ { "Name": "LowCapacityCPUs", "Controller": "cpuset", "File": "background/cpus" }, { "Name": "HighCapacityCPUs", "Controller": "cpuset", "File": "foreground/cpus" }, .... { "Name": "FreezerState", "Controller": "freezer", "File": "cgroup.freeze" } ], "Profiles": [ ... { "Name": "Frozen", "Actions": [ { "Name": "SetAttribute", "Params": { "Name": "FreezerState", "Value": "1" } } ] }, { "Name": "Unfrozen", "Actions": [ { "Name": "SetAttribute", "Params": { "Name": "FreezerState", "Value": "0" } } ] }, ... "AggregateProfiles": [ ... { "Name": "SCHED_SP_BACKGROUND", "Profiles": [ "HighEnergySaving", "LowIoPriority", "TimerSlackHigh" ] }, ...1.3 processgroup.SetProcessProfiles/codes/MTK_A16/alps/b0_sys/system/core/libprocessgroup/processgroup.cpp调用TaskProfiles::GetInstance()来获取单例对象,然后调用SetProcessProfiles方法/** * 设置进程的 cgroup/profile 配置 * * 核心功能: * 将指定进程加入指定的 cgroup 配置文件组,用于资源管控(CPU/IO/内存等) * * 典型应用场景: * - 进程冻结(freezer cgroup) * - 后台进程限制(background cpuset) * - 实时进程优先(rt scheduler) * * @param uid 进程所属用户ID,用于权限校验(必须 >= 10000 的非系统用户) * @param pid 目标进程ID,0表示当前进程 * @param profiles 要加入的cgroup配置组名称列表,如: * {"FreezerState", "HighIoPriority", "LowMemory"} * * @return true 1.3 processgroup.SetProcessProfiles
/codes/MTK_A16/alps/b0_sys/system/core/libprocessgroup/processgroup.cpp
调用TaskProfiles::GetInstance()来获取单例对象,然后调用SetProcessProfiles方法
/codes/MTK_A16/alps/b0_sys/system/core/libprocessgroup/task_profiles.cpp/** * 为指定进程应用一组 cgroup/profile 配置 * * 核心流程: * 1. 遍历所有请求的 profile 名称 * 2. 查找对应的 TaskProfile 配置 * 3. 执行实际 cgroup 操作 * * @tparam T 字符串类型(std::string/std::string_view 等) * @param uid 目标进程的用户ID(用于权限校验) * @param pid 目标进程ID(0表示当前进程) * @param profiles 要应用的 profile 名称列表(通过 span 传递避免拷贝) * @param use_fd_cache 是否启用文件描述符缓存(提升频繁操作性能) * @return bool 全部应用成功返回 true,任意失败返回 false * * 设计要点: * - 继续执行后续 profile 即使某个失败(非原子性) * - 错误日志通过 WARNING 级别输出(避免刷屏) * - 支持泛型 T 减少字符串拷贝开销 * * 典型调用栈: * SetProcessProfiles() -> ExecuteForProcess() -> WriteActionToFile() */template <typename T>bool TaskProfiles::SetProcessProfiles(uid_t uid, pid_t pid, std::span<const T> profiles, bool use_fd_cache) { bool success = true; // 默认成功,遇到任何错误则置为 false // 遍历所有请求的 profile 名称 for (const auto& name : profiles) { // 1. 查找 profile 配置 TaskProfile* profile = GetProfile(name); if (profile != nullptr) { // 2. 启用文件描述符缓存(如配置) if (use_fd_cache) { profile->EnableResourceCaching(ProfileAction::RCT_PROCESS); } // 3. 执行实际 cgroup 操作 if (!profile->ExecuteForProcess(uid, pid)) { LOG(WARNING) << "Failed to apply " << name << " process profile"; success = false; // 标记失败但继续执行 } } else { LOG(WARNING) << "Failed to find " << name << " process profile"; success = false; } } return success;}1.4 TaskProfiles.SetProcessProfiles
首先获取我们要执行的这个profile,就是刚才上面写入的"Frozen",然后ExecuteForProcess方法去执行
/codes/MTK_A16/alps/b0_sys/system/core/libprocessgroup/task_profiles.cpp/** * 为指定进程应用一组 cgroup/profile 配置 * * 核心流程: * 1. 遍历所有请求的 profile 名称 * 2. 查找对应的 TaskProfile 配置 * 3. 执行实际 cgroup 操作 * * @tparam T 字符串类型(std::string/std::string_view 等) * @param uid 目标进程的用户ID(用于权限校验) * @param pid 目标进程ID(0表示当前进程) * @param profiles 要应用的 profile 名称列表(通过 span 传递避免拷贝) * @param use_fd_cache 是否启用文件描述符缓存(提升频繁操作性能) * @return bool 全部应用成功返回 true,任意失败返回 false * * 设计要点: * - 继续执行后续 profile 即使某个失败(非原子性) * - 错误日志通过 WARNING 级别输出(避免刷屏) * - 支持泛型 T 减少字符串拷贝开销 * * 典型调用栈: * SetProcessProfiles() -> ExecuteForProcess() -> WriteActionToFile() */template <typename T>bool TaskProfiles::SetProcessProfiles(uid_t uid, pid_t pid, std::span<const T> profiles, bool use_fd_cache) { bool success = true; // 默认成功,遇到任何错误则置为 false // 遍历所有请求的 profile 名称 for (const auto& name : profiles) { // 1. 查找 profile 配置 TaskProfile* profile = GetProfile(name); if (profile != nullptr) { // 2. 启用文件描述符缓存(如配置) if (use_fd_cache) { profile->EnableResourceCaching(ProfileAction::RCT_PROCESS); } // 3. 执行实际 cgroup 操作 if (!profile->ExecuteForProcess(uid, pid)) { LOG(WARNING) << "Failed to apply " << name << " process profile"; success = false; // 标记失败但继续执行 } } else { LOG(WARNING) << "Failed to find " << name << " process profile"; success = false; } } return success;}1.5 TaskProfiles.ExecuteForProcess
先调用GetPathForProcess获取对应profile对应的path,然后调用WriteValueToFile方法写入指定的文件,这个文件就是上面"Attributes"我们定义的File,Frozen对应的就是cgroup.freeze节点,
/** * 为指定进程设置cgroup属性值 * @param uid 用户ID(用于路径生成) * @param pid 进程ID(0表示当前进程) * @return 成功返回true,失败返回false并记录错误日志 */bool SetAttributeAction::ExecuteForProcess(uid_t uid, pid_t pid) const { std::string path; // 1. 获取目标cgroup路径(根据uid/pid动态生成) if (!attribute_->GetPathForProcess(uid, pid, &path)) { LOG(ERROR) << "Failed to find cgroup for uid " << uid << " pid " << pid; return false; } // 2. 将配置值写入cgroup文件 return WriteValueToFile(path);}/** * 将属性值写入cgroup控制文件 * @param path cgroup文件完整路径 * @return 写入成功返回true,失败根据配置决定是否忽略错误 */bool SetAttributeAction::WriteValueToFile(const std::string& path) const { // 尝试写入值 if (!WriteStringToFile(value_, path)) { // 写入失败时检查文件是否存在 if (access(path.c_str(), F_OK) < 0) { // 文件不存在时:如果是可选属性则忽略错误 if (optional_) { return true; } else { LOG(ERROR) << "No such cgroup attribute: " << path; return false; } } // 文件存在但写入失败(记录详细错误信息) PLOG(ERROR) << "Failed to write '" << value_ << "' to " << path; return false; } return true;}总结来说就是冻结的流程走到最后就是调用了"Frozen"这个profile,将/sys/fs/cgroup路径下面对应的cgroup.freeze节点,写值为1,反之解冻就是将值写为0.
这就是cgroup 中间抽象层的作用,但是将这个节点写为1以后,怎样使用这个节点值,又是怎样实现进程的冻结,继续看kernel里面怎样使用这个节点。
1.6 cgroup.cgroup_base_files
当修改cgroup.freeze这个节点的值的时候,就会触发cgroup_freeze_write方法来进行处理
/codes/MTK_A16/alps/b0_sys/kernel-6.12/kernel/cgroup/cgroup.c/* cgroup core interface files for the default hierarchy */static struct cftype cgroup_base_files[] = {....{ .name = "cgroup.freeze", // 控制进程冻结状态的核心接口文件 .flags = CFTYPE_NOT_ON_ROOT, // 不能在root cgroup使用 .seq_show = cgroup_freeze_show, //读的时候会调用,例如cat cgroup.freeze,会调用这个方法来显示当前状态 .write = cgroup_freeze_write, //写的时候调用,当写入新的值的时候,会触发此方法。例如 echo 1 >cgroup.freeze }, ... };例如 adb shell cat /sys/fs/cgroup/uid_{应用UID}/pid_{应用PID}/cgroup.freeze 写入控制命令会触发 cgroup_freeze_write 方法
1.7 cgroup.cgroup_freeze_write
cgroup_freeze_write 主要 调用cgroup_freeze方法
/codes/MTK_A16/alps/b0_sys/kernel-6.12/kernel/cgroup/cgroup.c/** * 处理cgroup冻结/解冻的写操作 * * @param of 内核文件描述符 * @param buf 用户空间写入的数据("0"或"1") * @param nbytes 数据长度 * @param off 文件偏移量 * @return 成功返回写入字节数,失败返回错误码 */static ssize_t cgroup_freeze_write(struct kernfs_open_file *of, char *buf, size_t nbytes, loff_t off){ struct cgroup *cgrp; ssize_t ret; int freeze; // 1. 解析用户输入(转换为整型) ret = kstrtoint(strstrip(buf), 0, &freeze); if (ret) return ret; // 2. 校验参数范围(只允许0或1) if (freeze < 0 || freeze > 1) return -ERANGE; // 3. 获取并锁定对应的cgroup结构体 cgrp = cgroup_kn_lock_live(of->kn, false); if (!cgrp) return -ENOENT; // 4. 执行实际冻结/解冻操作 cgroup_freeze(cgrp, freeze); // 5. 释放锁 cgroup_kn_unlock(of->kn); return nbytes;}1.8 freezer.cgroup_freeze
会遍历当前cgroup的子cgroup,将父cgroup的状态传递到子cgroup中,如果父cgroup被冻结或者解冻,他的所有子cgroup也会被冻结或者解冻,然后调用cgroup_do_freeze去执行冻结动作
/codes/MTK_A16/alps/b0_sys/kernel-6.12/kernel/cgroup/freezer.c/** * 冻结或解冻指定cgroup及其所有子cgroup * * @param cgrp 目标cgroup控制组 * @param freeze true表示冻结,false表示解冻 * * 功能说明: * 1. 递归遍历cgroup树处理所有子节点 * 2. 维护e_freeze引用计数实现嵌套冻结 * 3. 跳过已死亡的cgroup节点 */void cgroup_freeze(struct cgroup *cgrp, bool freeze){ struct cgroup_subsys_state *css; struct cgroup *dsct; bool applied = false; // 必须持有cgroup_mutex锁 lockdep_assert_held(&cgroup_mutex); // 检查状态是否已变更 if (cgrp->freezer.freeze == freeze) return; // 更新当前cgroup冻结状态 cgrp->freezer.freeze = freeze; /* * 遍历所有子cgroup(深度优先) * 将更改沿着 cgroup 树向下传播 这里用来遍历当前控制组(cgrp)的所有后代控制组。它按先序遍历的顺序递归遍历树状结构中的控制组 */ css_for_each_descendant_pre(css, &cgrp->self) { dsct = css->cgroup; // 跳过已删除的cgroup if (cgroup_is_dead(dsct)) continue; if (freeze) { // 如果freeze为真即请求冻结操作,代码会将后代控制组的 e_freeze 计数器递增。e_freeze 是一个计数器,用于跟踪控制组的冻结状态。 // 冻结操作:增加引用计数 dsct->freezer.e_freeze++; // 如果已被祖先冻结则跳过 if (dsct->freezer.e_freeze > 1) // 如果计数器在递增后大于1,表示该控制组已经因为其祖先的设置而被冻结,那么就继续处理下一个控制组。 continue; } else { // 解冻操作:减少引用计数 dsct->freezer.e_freeze--; // 如果仍被祖先冻结则跳过 if (dsct->freezer.e_freeze > 0) continue; // 引用计数异常检测 WARN_ON_ONCE(dsct->freezer.e_freeze < 0); } // 执行实际冻结/解冻操作 cgroup_do_freeze(dsct, freeze); applied = true; }1.9 freezer.cgroup_do_freeze
判断是否是内核线程,如果是内核线程就跳出循环,如果不是就继续执行cgroup_freeze_task,目前cgroup冻结机制,没有对内核线程的处理
/* * 冻结或解冻指定cgroup中的所有任务 * * @param cgrp 目标控制组 * @param freeze true表示冻结,false表示解冻 * * 核心功能: * 1. 设置/清除CGRP_FREEZE标志位 * 2. 遍历组内所有任务执行冻结/解冻 * 3. 更新cgroup的冻结状态统计 */static void cgroup_do_freeze(struct cgroup *cgrp, bool freeze){ struct css_task_iter it; // 任务迭代器 struct task_struct *task; // 当前处理的任务 // 必须持有cgroup_mutex锁 lockdep_assert_held(&cgroup_mutex); /* 原子操作更新cgroup标志位 */ spin_lock_irq(&css_set_lock); if (freeze) set_bit(CGRP_FREEZE, &cgrp->flags); // 设置冻结标志 else clear_bit(CGRP_FREEZE, &cgrp->flags); // 清除冻结标志 spin_unlock_irq(&css_set_lock); /* 记录跟踪事件(调试用) */ if (freeze) TRACE_CGROUP_PATH(freeze, cgrp); else TRACE_CGROUP_PATH(unfreeze, cgrp); /* 遍历cgroup中的所有任务 */ css_task_iter_start(&cgrp->self, 0, &it); while ((task = css_task_iter_next(&it))) { /* 跳过内核线程(不支持冻结) */ if (task->flags & PF_KTHREAD) continue; /* 对每个用户态任务执行冻结/解冻 */ cgroup_freeze_task(task, freeze); } css_task_iter_end(&it); /* * 检查并更新cgroup冻结状态: * 当所有子cgroup都已冻结时,更新当前cgroup状态 */ spin_lock_irq(&css_set_lock); if (cgrp->nr_descendants == cgrp->freezer.nr_frozen_descendants) cgroup_update_frozen(cgrp); spin_unlock_irq(&css_set_lock);}1.10 freezer.cgroup_freeze_task
如果freeze为真,将jobctl中的标志位设置为 JOBCTL_TRAP_FREEZE。如果不是就清除 JOBCTL_TRAP_FREEZE,jobctl 是一个与任务(线程)相关的控制字段,用于管理任务的控制状态。它包含多个标志位,用于不同的任务控制操作。JOBCTL_TRAP_FREEZE是jobctl位掩码中的一个标志位,它用于控制任务的冻结状态。当该标志位被设置时,表示任务应当进入冻结状态。当该标志位被清除时,任务将退出冻结状态。
/* * 冻结或解冻单个任务 * * @param task 目标进程的task_struct指针 * @param freeze true表示冻结,false表示解冻 * * 核心机制: * 1. 通过设置/清除JOBCTL_TRAP_FREEZE标志控制状态 * 2. 使用信号唤醒机制触发状态变更 * 3. 严格处理信号处理锁避免竞争 */static void cgroup_freeze_task(struct task_struct *task, bool freeze){ unsigned long flags; /* * 锁定任务信号处理结构体: * - 失败条件:任务正在退出(task->sighand == NULL) * - 保护范围:防止信号处理并发冲突 */ if (!lock_task_sighand(task, &flags)) return; if (freeze) { /* 冻结操作 */ task->jobctl |= JOBCTL_TRAP_FREEZE; // 设置冻结标志位 signal_wake_up(task, false); // 唤醒任务处理冻结信号 // false表示不强制打断系统调用 } else { /* 解冻操作 */ task->jobctl &= ~JOBCTL_TRAP_FREEZE; // 清除冻结标志 wake_up_process(task); // 直接唤醒任务 } /* 释放信号处理锁 */ unlock_task_sighand(task, &flags);}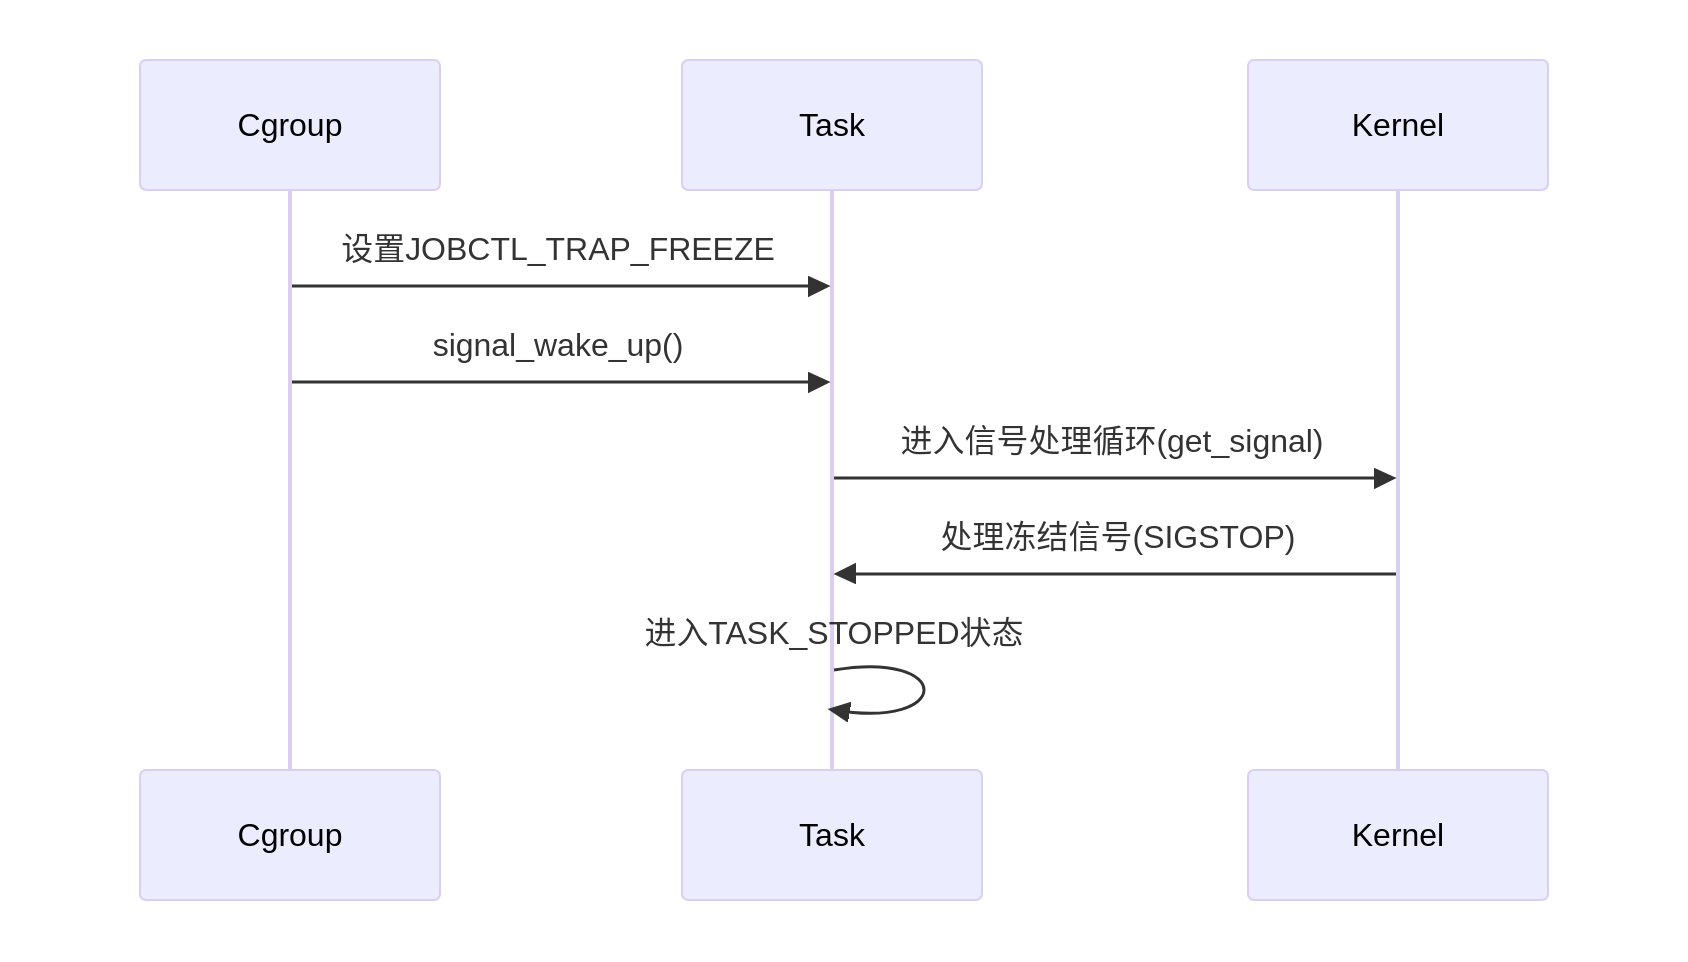
1.11 freezer.signal_wake_up_state
signal_wake_up方法会调用signal_wake_up_state方法将线程状态置为TIF_SIGPENDING,表明有一个挂起的信号需要处理。TIF_SIGPENDING是Linux内核中的一个线程标志(Thread Information Flag),用于表示当前线程有未处理的挂起信号。它是内核用于管理信号处理机制的一部分,当一个线程收到信号后,但还未开始处理这些信号时,内核会设置TIF_SIGPENDING标志。这表示当前线程有挂起的信号需要处理,内核在调度时会检查这个标志
// ========== include/linux/sched/signal.h ==========/** * 唤醒任务处理信号(带致命信号处理) * * @param t 目标任务的task_struct指针 * @param fatal 是否处理致命信号(如SIGKILL) * * 核心逻辑: * 1. 对致命信号清除STOPPED/TRACED状态 * 2. 设置WAKEKILL和TRACED唤醒标志 * 3. 传递状态给底层唤醒函数 */static inline void signal_wake_up(struct task_struct *t, bool fatal){ unsigned int state = 0; // 处理致命信号且未被调试器冻结的情况 if (fatal && !(t->jobctl & JOBCTL_PTRACE_FROZEN)) { t->jobctl &= ~(JOBCTL_STOPPED | JOBCTL_TRACED); // 清除停止状态 state = TASK_WAKEKILL | __TASK_TRACED; // 设置强制唤醒标志 } signal_wake_up_state(t, state); // 调用核心唤醒函数}// ========== kernel/signal.c ==========/** * 核心信号唤醒函数(需持有siglock锁) * * @param t 目标任务 * @param state 附加唤醒状态标志 * * 关键操作: * 1. 设置TIF_SIGPENDING标志触发信号处理 * 2. 通过wake_up_state唤醒任务 * 3. 失败时使用kick_process强制调度 * * 注意:必须在持有t->sighand->siglock时调用! */void signal_wake_up_state(struct task_struct *t, unsigned int state){ // 确保已持有信号锁(调试用) lockdep_assert_held(&t->sighand->siglock); // 设置信号待处理标志(触发信号处理循环) set_tsk_thread_flag(t, TIF_SIGPENDING); /* * 唤醒策略说明: * - TASK_WAKEKILL: 即使任务处于stopped/traced状态也强制唤醒 * - TASK_INTERRUPTIBLE: 与任务当前状态组合唤醒,示该任务是可被中断的,因此可以被信号唤醒。 * - 如果标准唤醒失败,使用kick_process强制跨CPU唤醒 */ if (!wake_up_state(t, state | TASK_INTERRUPTIBLE)) kick_process(t); // 通过IPI强制调度}综上,所有要被冻结的任务,都将jobctl中的标志位设置为 JOBCTL_TRAP_FREEZE,然后处于TIF_SIGPENDING的状态,而从处于TIF_SIGPENDING状态我们可以得知,最后的处理是在signal信号处理机制里面去处理的。这个时候我们也能知晓在前面,为什么判断是内核线程的时候会退出,因为在Linux的设计上,信号机制主要是针对用户态(用户空间进程)进行处理的,
1.12 signal.do_notify_resume
从上面得知,最后会走到信号处理里面去处理,处于TIF_SIGPENDING状态,表明有信号等待处理,这时候会走到信号处理流程,其中关于信号处理机制就不详细解释了
直接从逻辑上讲,如果有挂起的信号(由 TIF_SIGPENDING 标志指示),do_notify_resume将调用信号处理函数来处理这些信号,也就是说回去执行do_notify_resume方法,然后如果有_TIF_SIGPENDING状态,会去执行do_signal。
void do_notify_resume(struct pt_regs *regs, unsigned long thread_info_flags){ ..... /* 2. 处理信号传递(最高优先级) 如果有_TIF_SIGPENDING状态,会去执行do_signal*/ if (thread_info_flags & (_TIF_SIGPENDING | _TIF_NOTIFY_SIGNAL)) do_signal(regs); // 核心信号分发函数(可能改变regs->ip) .....}1.13 signal.do_signal
通过get_signal函数,检测是否有信号待处理,
static void do_signal(struct task_struct *tsk){ struct ksignal ksig = { .sig = 0 }; // 初始化一个 ksignal 结构体,初始信号值为 0 ... get_signal(&ksig); // 检查是否有信号待处理,如果有,将其存储在 ksig 中 ...}1.14 signal.get_signal
在信号处理流程中检查task中的jobctl标志位是否是JOBCTL_TRAP_FREEZ,如果是的话,就执行冻结操作,当前这个函数也和我们最开始通过PS判断进程冻结状态时,看到进程的WCHAN是在do_freezer_trap上面对应了起来,最终在内核上面执行的冻结函数就是do_freezer_trap
bool get_signal(struct ksignal *ksig)...if (unlikely(current->jobctl & (JOBCTL_TRAP_MASK | JOBCTL_TRAP_FREEZE))) { if (current->jobctl & JOBCTL_TRAP_MASK) { do_jobctl_trap(); spin_unlock_irq(&sighand->siglock); } else if (current->jobctl & JOBCTL_TRAP_FREEZE) do_freezer_trap(); //如果jobctl中的标志位为 JOBCTL_TRAP_FREEZE,开始执行真正的冻结操作 goto relock; }...1.15 signal.do_freezer_trap
在冻结方法里会走到freezable_schedule()冻结进程调度方法里面去,然后调用schedule()方法,具体内核的调度策略就不细谈,主要了解这里的schedule() 是 Linux 内核中管理任务调度的关键接口。它负责将当前进程的CPU时间让给其他进程,并确保系统能够根据调度策略高效运行。
/codes/MTK_A16/alps/b0_sys/kernel-6.12/kernel/signal.c/** * do_freezer_trap - 处理 freezer 的 jobctl 陷阱 * * 将任务置于冻结状态,除非任务即将退出。在这种情况下,它会清除 JOBCTL_TRAP_FREEZE 标志。 * * 上下文: * 必须持有 @current->sighand->siglock 锁调用, * 该锁在函数返回前总是会被释放。 */static void do_freezer_trap(void) __releases(¤t->sighand->siglock) // 标注函数会释放 siglock{ /* * 如果除了 JOBCTL_TRAP_FREEZE 外还有其他待处理的陷阱位, * 我们让出控制权以便其他陷阱有机会被处理。 * 无论如何,我们都会返回。 */ if ((current->jobctl & (JOBCTL_PENDING_MASK | JOBCTL_TRAP_FREEZE)) != JOBCTL_TRAP_FREEZE) { spin_unlock_irq(¤t->sighand->siglock); return; } /* * 现在我们可以确定没有待处理的致命信号和 * 其他待处理的陷阱。清除 TIF_SIGPENDING 标志, * 避免立即从 schedule() 中返回(如果有非致命信号待处理), * 并将任务置为可中断的睡眠状态。 */ __set_current_state(TASK_INTERRUPTIBLE|TASK_FREEZABLE); //当前进程的状态设置为 TASK_INTERRUPTIBLE。在这个状态下,进程是可中断的,等待某些事件(如信号或定时器)时进入睡眠 clear_thread_flag(TIF_SIGPENDING); //清除 TIF_SIGPENDING 线程标志,表明此时线程认为已经处理完所有未决的信号 spin_unlock_irq(¤t->sighand->siglock); // 释放锁并启用中断 cgroup_enter_frozen(); //表明cgroup进入冻结状态 schedule(); //进程调度挂起,让出CPU,【进程冻结真正的逻辑】标准的调度调用,当前任务会进入睡眠状态,并且系统会调度其他任务运行。此时,任务进入了可中断的睡眠状态,等待被唤醒或其他事件发生 /* * 我们可能被任务工作(task_work)唤醒, * 执行它以清除 TIF_NOTIFY_SIGNAL 标志。 * 如果有必要,调用者会重试。 */ clear_notify_signal(); // 清除通知信号标志 if (unlikely(task_work_pending(current))) // 检查是否有待处理的任务工作 task_work_run(); // 执行待处理的任务工作}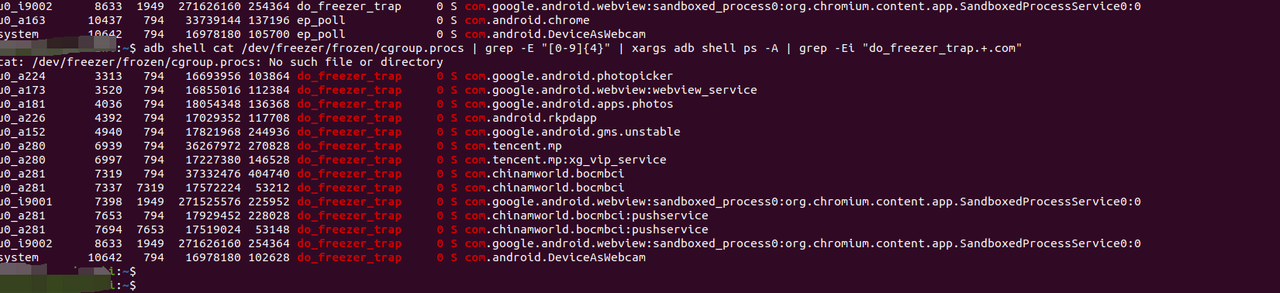
1.16 总结
综上,我们可以对冻结的实现做个简单总结,上层通过cgroup 中间抽象层将cgroup.freeze节点,写值为1,然后内核监控这个节点的值,对写了这个节点的进程,将jobctl中的标志位设置为 JOBCTL_TRAP_FREEZE,然后处于TIF_SIGPENDING的状态(有待处理的信号),信号处理机制监控到以后,调用内核的调度方法,将进程主动挂起,将当前进程的CPU时间让给其他进程,从而实现了进程的冻结。
2.冻结流程的简单图解
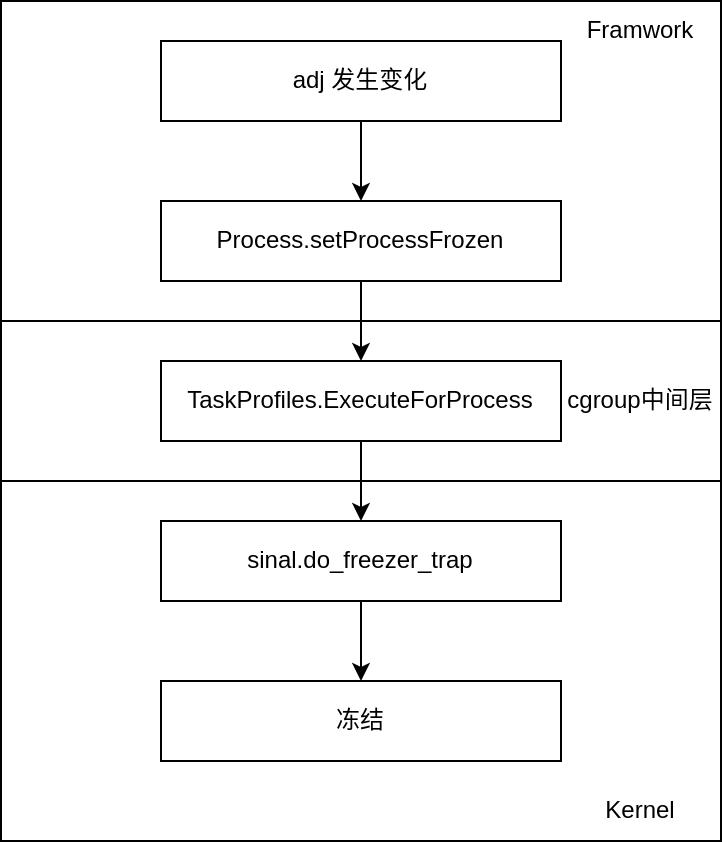
1.判断冻结功能是否开启、应用是否属于豁免的应用、应用是否已经被冻结、应用是否不应该被冻结。当做完基础的判断之后,然后看应用当前的 adj 是否大于等于 900 (CACHE_APP) 激进模式是大于600 来决定是否冻结应用,然后开启一个延迟0~10s,如果这个10s内状态都没有变化,就执行冻结流程,调用cgroup中间层
2.cgroup中间层判断执行冻结,将/sys/fs/cgroup路径下面对应的cgroup.freeze节点,写值为1,反之解冻就是将值写为0
3.内核监控cgroup.freeze节点,如值为1,将jobctl中的标志位设置为 JOBCTL_TRAP_FREEZE,然后处于TIF_SIGPENDING的状态
4.信号机制监控到TIF_SIGPENDING状态任务,判断标志位是否是JOBCTL_TRAP_FREEZE,调用内核的调度方法,将进程主动挂起,让出CPU资源