基于hive和mapreduce的地铁数据分析及可视化
项目概况
**👇👇👇👇👇👇👇👇**
**👆👆👆👆👆👆👆👆**
数据类型
地铁数据
开发环境
centos7
软件版本
hadoop3.2.0、hive3.1.2、mysql5.7.38、jdk8、sqoop1.4.7
开发语言
Java
开发流程
数据上传(hdfs)->数据分析(mapreduce和hive)->后端(springboot)->前端(html+js+css)
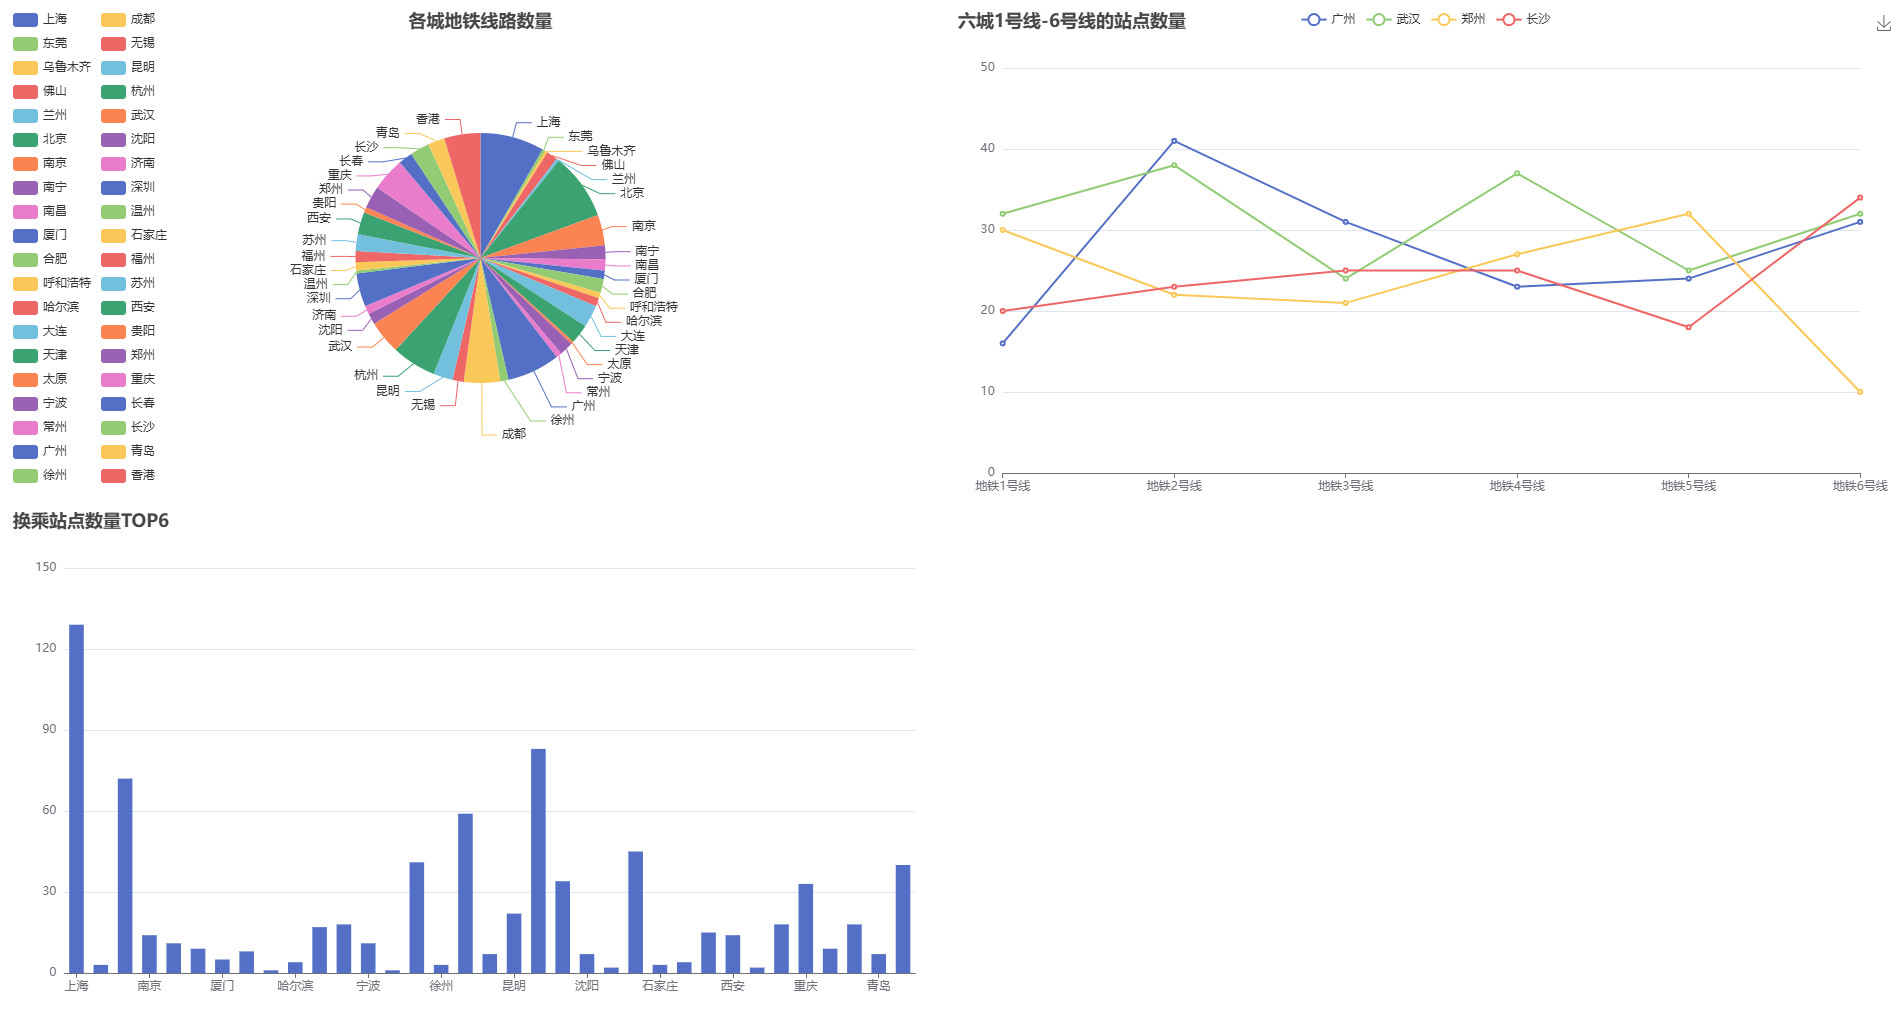
可视化图表
操作步骤
启动MySQL
shell
# 查看mysql是否启动 启动命令: systemctl start mysqld.service
systemctl status mysqld.service
# 进入mysql终端
# MySQL的用户名:root 密码:123456
# MySQL的用户名:root 密码:123456
# MySQL的用户名:root 密码:123456
mysql -uroot -p123456
启动Hadoop
shell
# 离开安全模式: hdfs dfsadmin -safemode leave
# 启动hadoop
bash /export/software/hadoop-3.2.0/sbin/start-hadoop.sh
启动hive
shell
# 在第一个窗口中,执行后等待10-20秒
/export/software/apache-hive-3.1.2-bin/bin/hive --service metastore

# 在第二个窗口中,执行后等待10-20秒
/export/software/apache-hive-3.1.2-bin/bin/hive --service hiveserver2

# 连接进入hive终端命令如下:
# /export/software/apache-hive-3.1.2-bin/bin/beeline -u jdbc:hive2://master:10000 -n root
准备目录
shell
mkdir -p /data/jobs/project/
cd /data/jobs/project/

# 上传 "project-hive-mapreduce-subway-analysis-data-screen/project_subway_station/data/" 目录下的 "subway_station.csv" 文件 到 "/data/jobs/project/" 目录
上传文件到hdfs
shell
cd /data/jobs/project/

hdfs dfs -mkdir -p /data/input/
hdfs dfs -rm -r /data/input/*
hdfs dfs -put -f subway_station.csv /data/input/
hdfs dfs -ls /data/input/
程序打包
shell
cd /data/jobs/project/

# 对 "project-hive-mapreduce-subway-analysis-data-screen/project_subway_station" 目录下的项目 "project_subway_station" 进行打包
# 打包命令: mvn clean package -Dmaven.test.skip=true

# 上传 "project_subway_station/target/" 目录下的 "project_subway_station-jar-with-dependencies.jar" 文件 到 "/data/jobs/project/" 目录
mapreduce数据分析
shell
cd /data/jobs/project/

# 上传 "project-hive-mapreduce-subway-analysis-data-screen/project_subway_station" 目录下的 "run_mr.sh" 文件 到 "/data/jobs/project/" 目录

sed -i 's/\r//g' run_mr.sh
bash run_mr.sh

# 查看结果
hdfs dfs -ls /data/output/university_station_cities/
hdfs dfs -ls /data/output/max_stations_lines/
hdfs dfs -ls /data/output/most_frequent_chars/
hdfs dfs -ls /data/output/avg_stations_per_line/
hdfs dfs -ls /data/output/top_cities_by_lines/
hdfs dfs -ls /data/output/longest_station_names/
hive数据分析
shell
cd /data/jobs/project/

# 上传 "project-hive-mapreduce-subway-analysis-data-screen/project_subway_station" 目录下的 "hive.sql" 文件 到 "/data/jobs/project/" 目录

# 连接进入hive终端命令如下:
# /export/software/apache-hive-3.1.2-bin/bin/beeline -u jdbc:hive2://master:10000 -n root

# 快速执行hive.sql
hive -v -f hive.sql

# 查看结果
hdfs dfs -ls /data/output/city_line_count/
hdfs dfs -ls /data/output/city_transfer_level/
hdfs dfs -ls /data/output/same_line_station_count_in_specific_cities/
hdfs dfs -ls /data/output/top_6_cities_by_transfer_stations/
启动可视化
shell
cd /data/jobs/project/

# 对 "project-hive-mapreduce-subway-analysis-data-screen/project_subway_station" 目录下的项目 "project_subway_station" 进行打包
# 打包命令: mvn clean package -Dmaven.test.skip=true

# 上传 "project_subway_station/target/" 目录下的 "project_subway_station-jar-with-dependencies.jar" 文件 到 "/data/jobs/project/" 目录

java -jar /data/jobs/project/springboot-demo-1.0-SNAPSHOT.jar org.example.SpringBootApplication