- 🍨 本文为 🔗365天深度学习训练营中的学习记录博客
- 🍖 原作者: K同学啊
一、准备工作
import jieba

jieba.suggest_freq('沙瑞金',True)#加入一些词,使得jieba分词准确率更高
jieba.suggest_freq('田国富',True)
jieba.suggest_freq('高育良',True)
jieba.suggest_freq('侯亮平',True)
jieba.suggest_freq('钟小艾',True)
jieba.suggest_freq('陈岩石',True)
jieba.suggest_freq('欧阳菁',True)
jieba.suggest_freq('易学习',True)
jieba.suggest_freq('王大路',True)
jieba.suggest_freq('蔡成功',True)
jieba.suggest_freq('孙连城',True)
jieba.suggest_freq('季昌明',True)
jieba.suggest_freq('丁义珍',True)
jieba.suggest_freq('郑西坡',True)
jieba.suggest_freq('赵东来',True)
jieba.suggest_freq('高小琴',True)
jieba.suggest_freq('赵瑞龙',True)
jieba.suggest_freq('林华华',True)
jieba.suggest_freq('陆亦可',True)
jieba.suggest_freq('刘新建',True)
jieba.suggest_freq('刘庆祝',True)
jieba.suggest_freq('赵德汉',True)

with open('./data/in_the_name_of_people.txt',encoding='utf-8') as f:
    result_cut = []
    lines = f.readlines()
    for line in lines:
        result_cut.append(jieba.lcut(line))

f.close()

result_cut

# 添加自定义停用词
stopwords_list = [",","。","\n","\u3000"," ",":","!","?","..."] # \u3000 是 Unicode 编码中的全角空格(也称为 "全角空白符"),是中文排版中常用的空格形式。

def remove_stopwords(ls):  # 去除停用词
    return [word for word in ls if word not in stopwords_list]

result_stop=[remove_stopwords(x) for x in result_cut if remove_stopwords(x)]

result_stop

print(result_stop[100:103])
二、训练Word2Vec模型
from gensim.models import Word2Vec

model = Word2Vec(result_stop,     # 用于训练的语料数据
                 vector_size=100, # 是指特征向量的维度,默认为100。
                 window=5,        # 一个句子中当前单词和被预测单词的最大距离。
                 min_count=1)     # 可以对字典做截断,词频少于min_count次数的单词会被丢弃掉, 默认值为5。
三、模型应用
3.1 计算词汇相似性
# 计算两个词的相似度
print(model.wv.similarity('沙瑞金', '季昌明'))
print(model.wv.similarity('沙瑞金', '田国富'))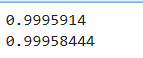
# 选出最相似的5个词
for e in model.wv.most_similar(positive=['沙瑞金'], topn=5):
    print(e[0], e[1])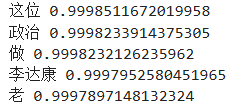
3.2 找出不匹配的词汇
odd_word = model.wv.doesnt_match(["苹果", "香蕉", "橙子", "书"])
print(f"在这组词汇中不匹配的词汇:{odd_word}")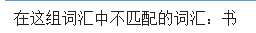
3.2 计算词汇的词频
word_frequency = model.wv.get_vecattr("沙瑞金", "count")
print(f"沙瑞金:{word_frequency}")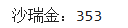
总结
本次打卡学习了word2vec模型的调用和使用,了解到了其在文本任务中的作用和便利性。