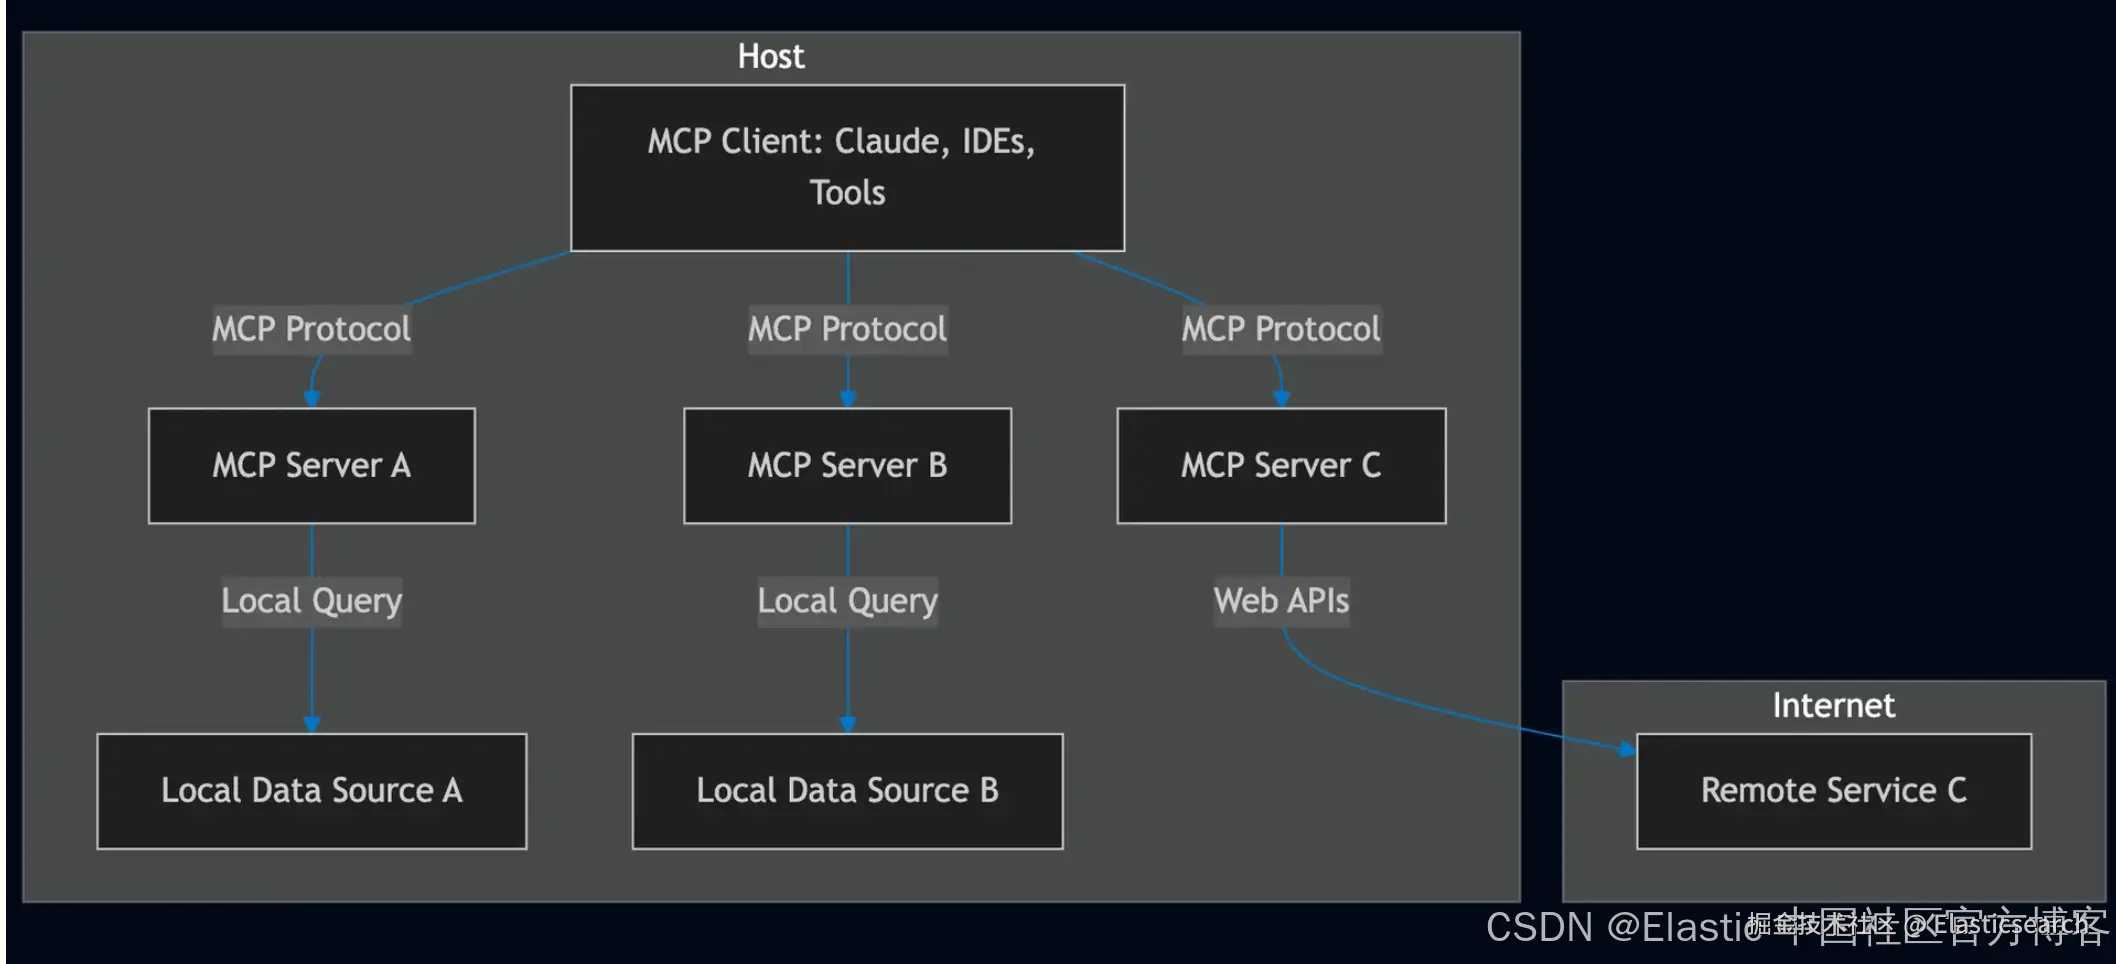
访问外部知识在提升 LLM 响应能力的现代 AI 工作流中起着关键作用。但高效管理 context、确保 AI agents 之间的通信,以及扩展工具以协同工作并非易事。这就是 Model Context Protocol (MCP) 的作用所在。
Model Context Protocol 是一个开放标准,使开发者能够在他们的数据源和 AI 驱动的工具之间建立安全的双向连接。其架构非常直接:开发者可以通过 MCP servers 暴露他们的数据,或者构建连接这些服务器的 AI 应用(MCP clients)。MCP server 充当 AI 模型与外部存储的数据之间的桥梁,例如存储在 Elasticsearch vector store 中的数据。
在这篇文章中,我们将探讨:
- MCP server 是什么以及它如何工作。
- MCP 如何简化 RAG 并支持 agentic workflows。
- 构建 MCP server 以从 Elasticsearch 语义搜索数据的指南。
- 使用 MCP Inspector 和 Claude Desktop App(实现 MCP client 协议)的动手演示。
安装
Elasticsearch 及 Kibana
如果你还没有安装好自己的 Elasticsearch 及 Kibana,那么请参考一下的文章来进行安装:
在安装的时候,请选择 Elastic Stack 8.x/9.x 进行安装。在安装的时候,我们可以看到如下的安装信息:
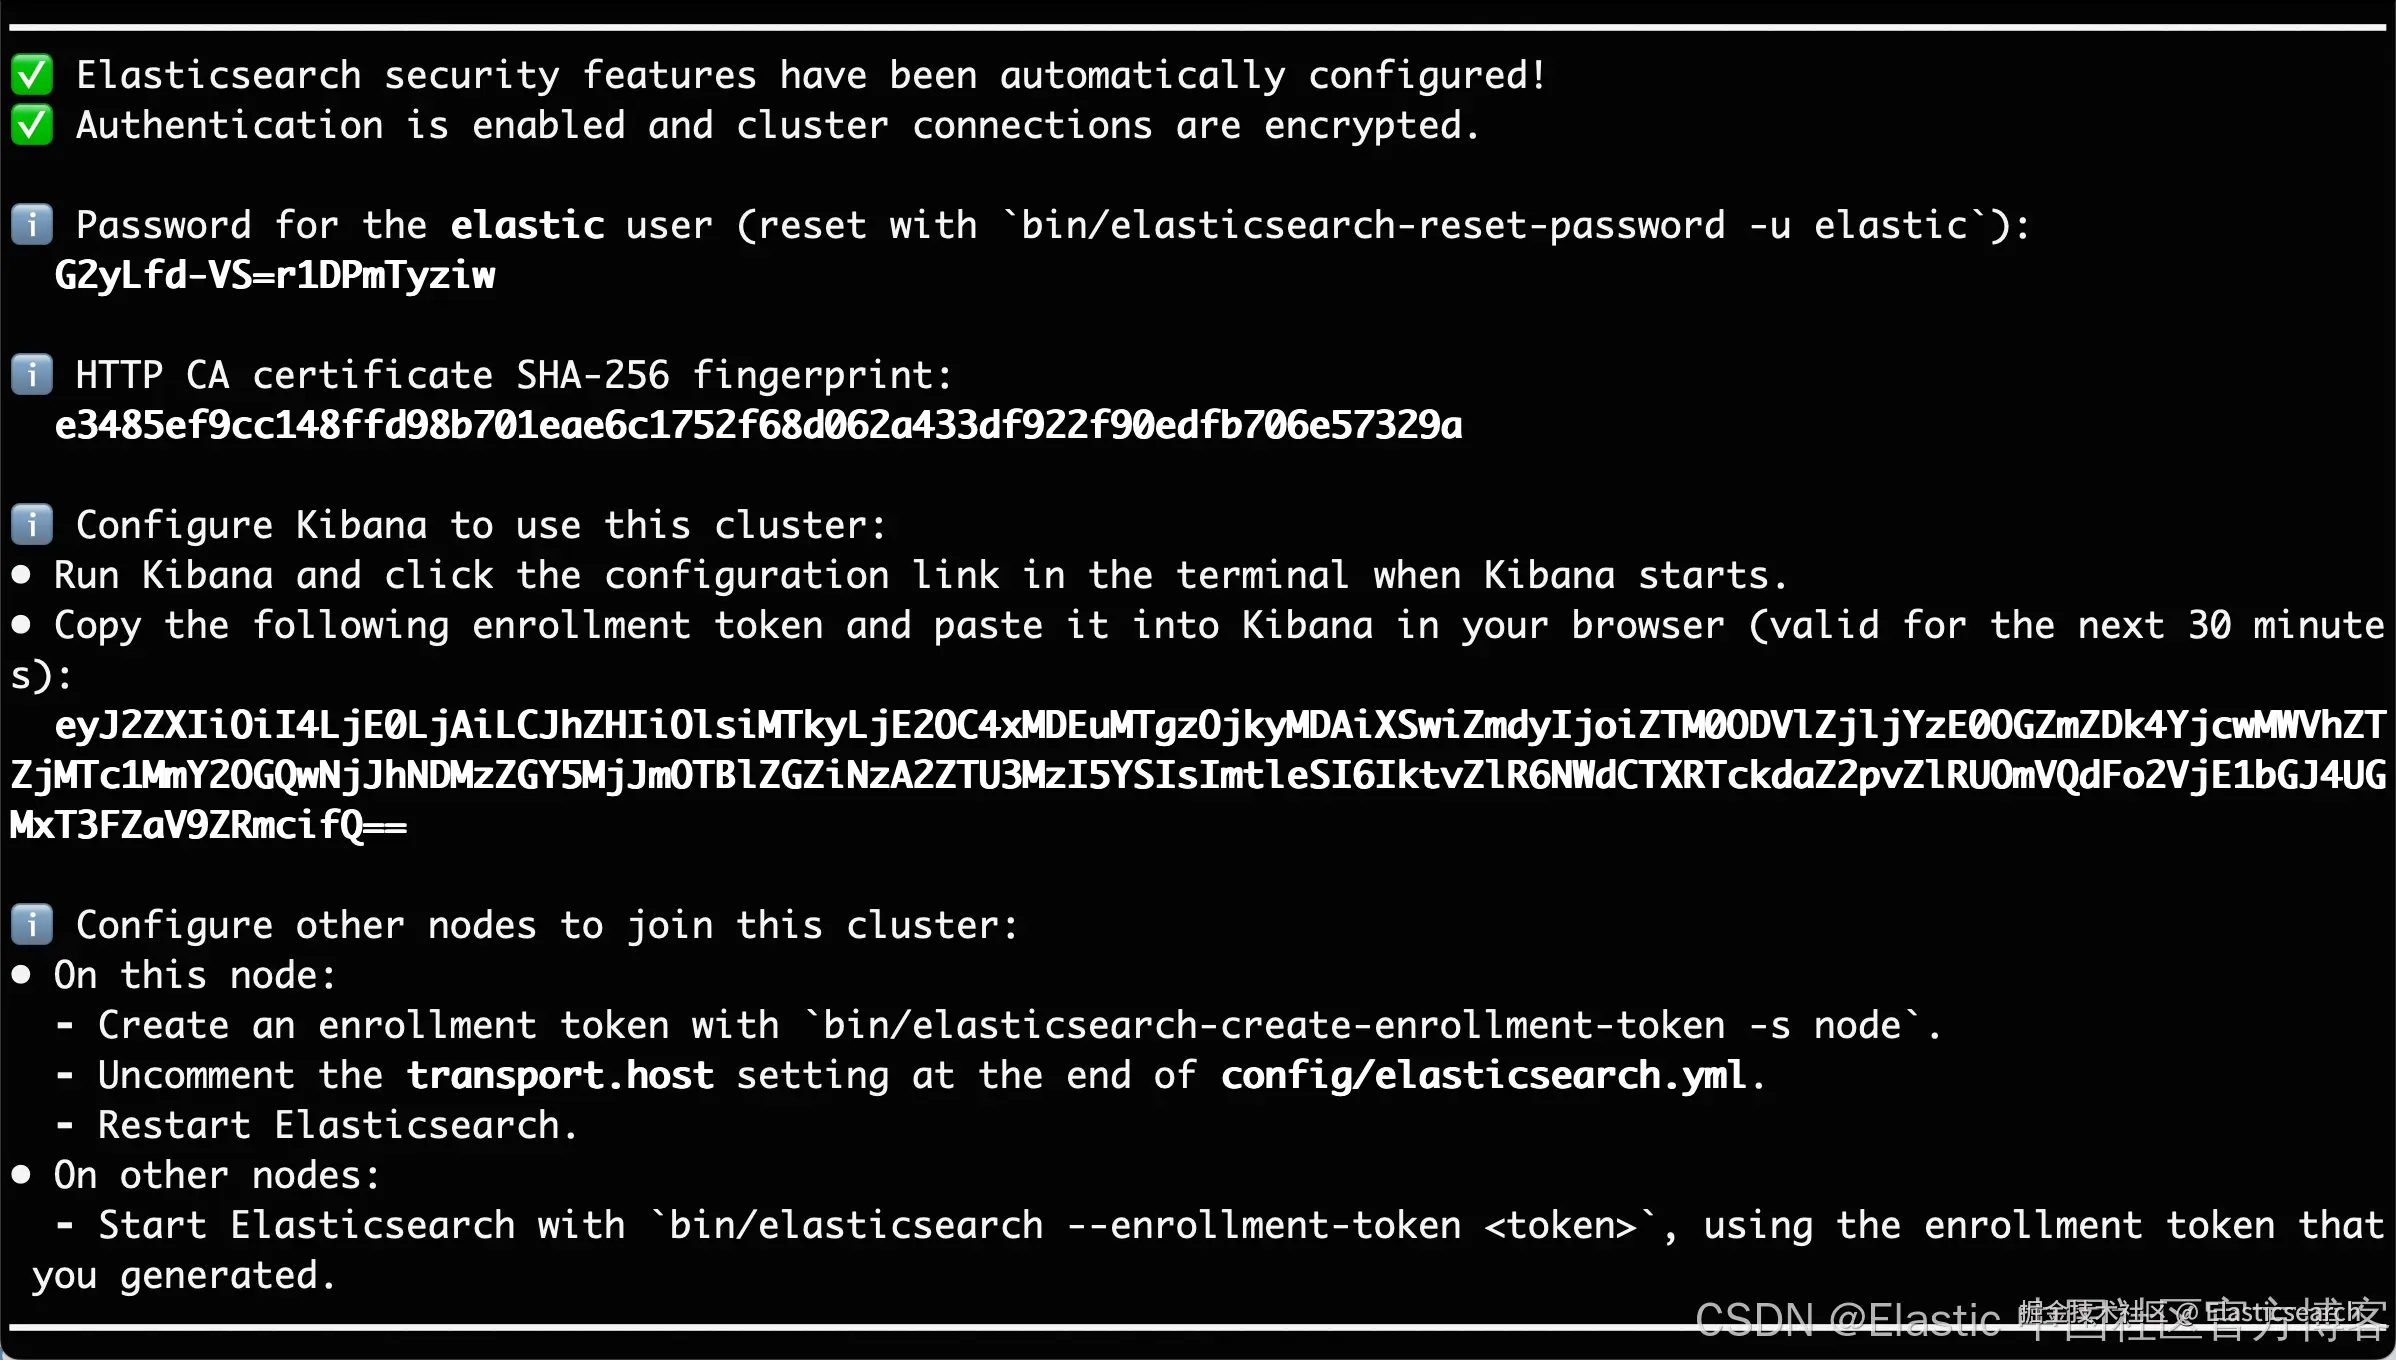
在本文中,我们使用 Elastic Stack 9.1.2 来进行展示。
启动白金试用
我们需要使用到内置的 ELSER 模型来向量化我们的数据。我们需要启动白金试用:
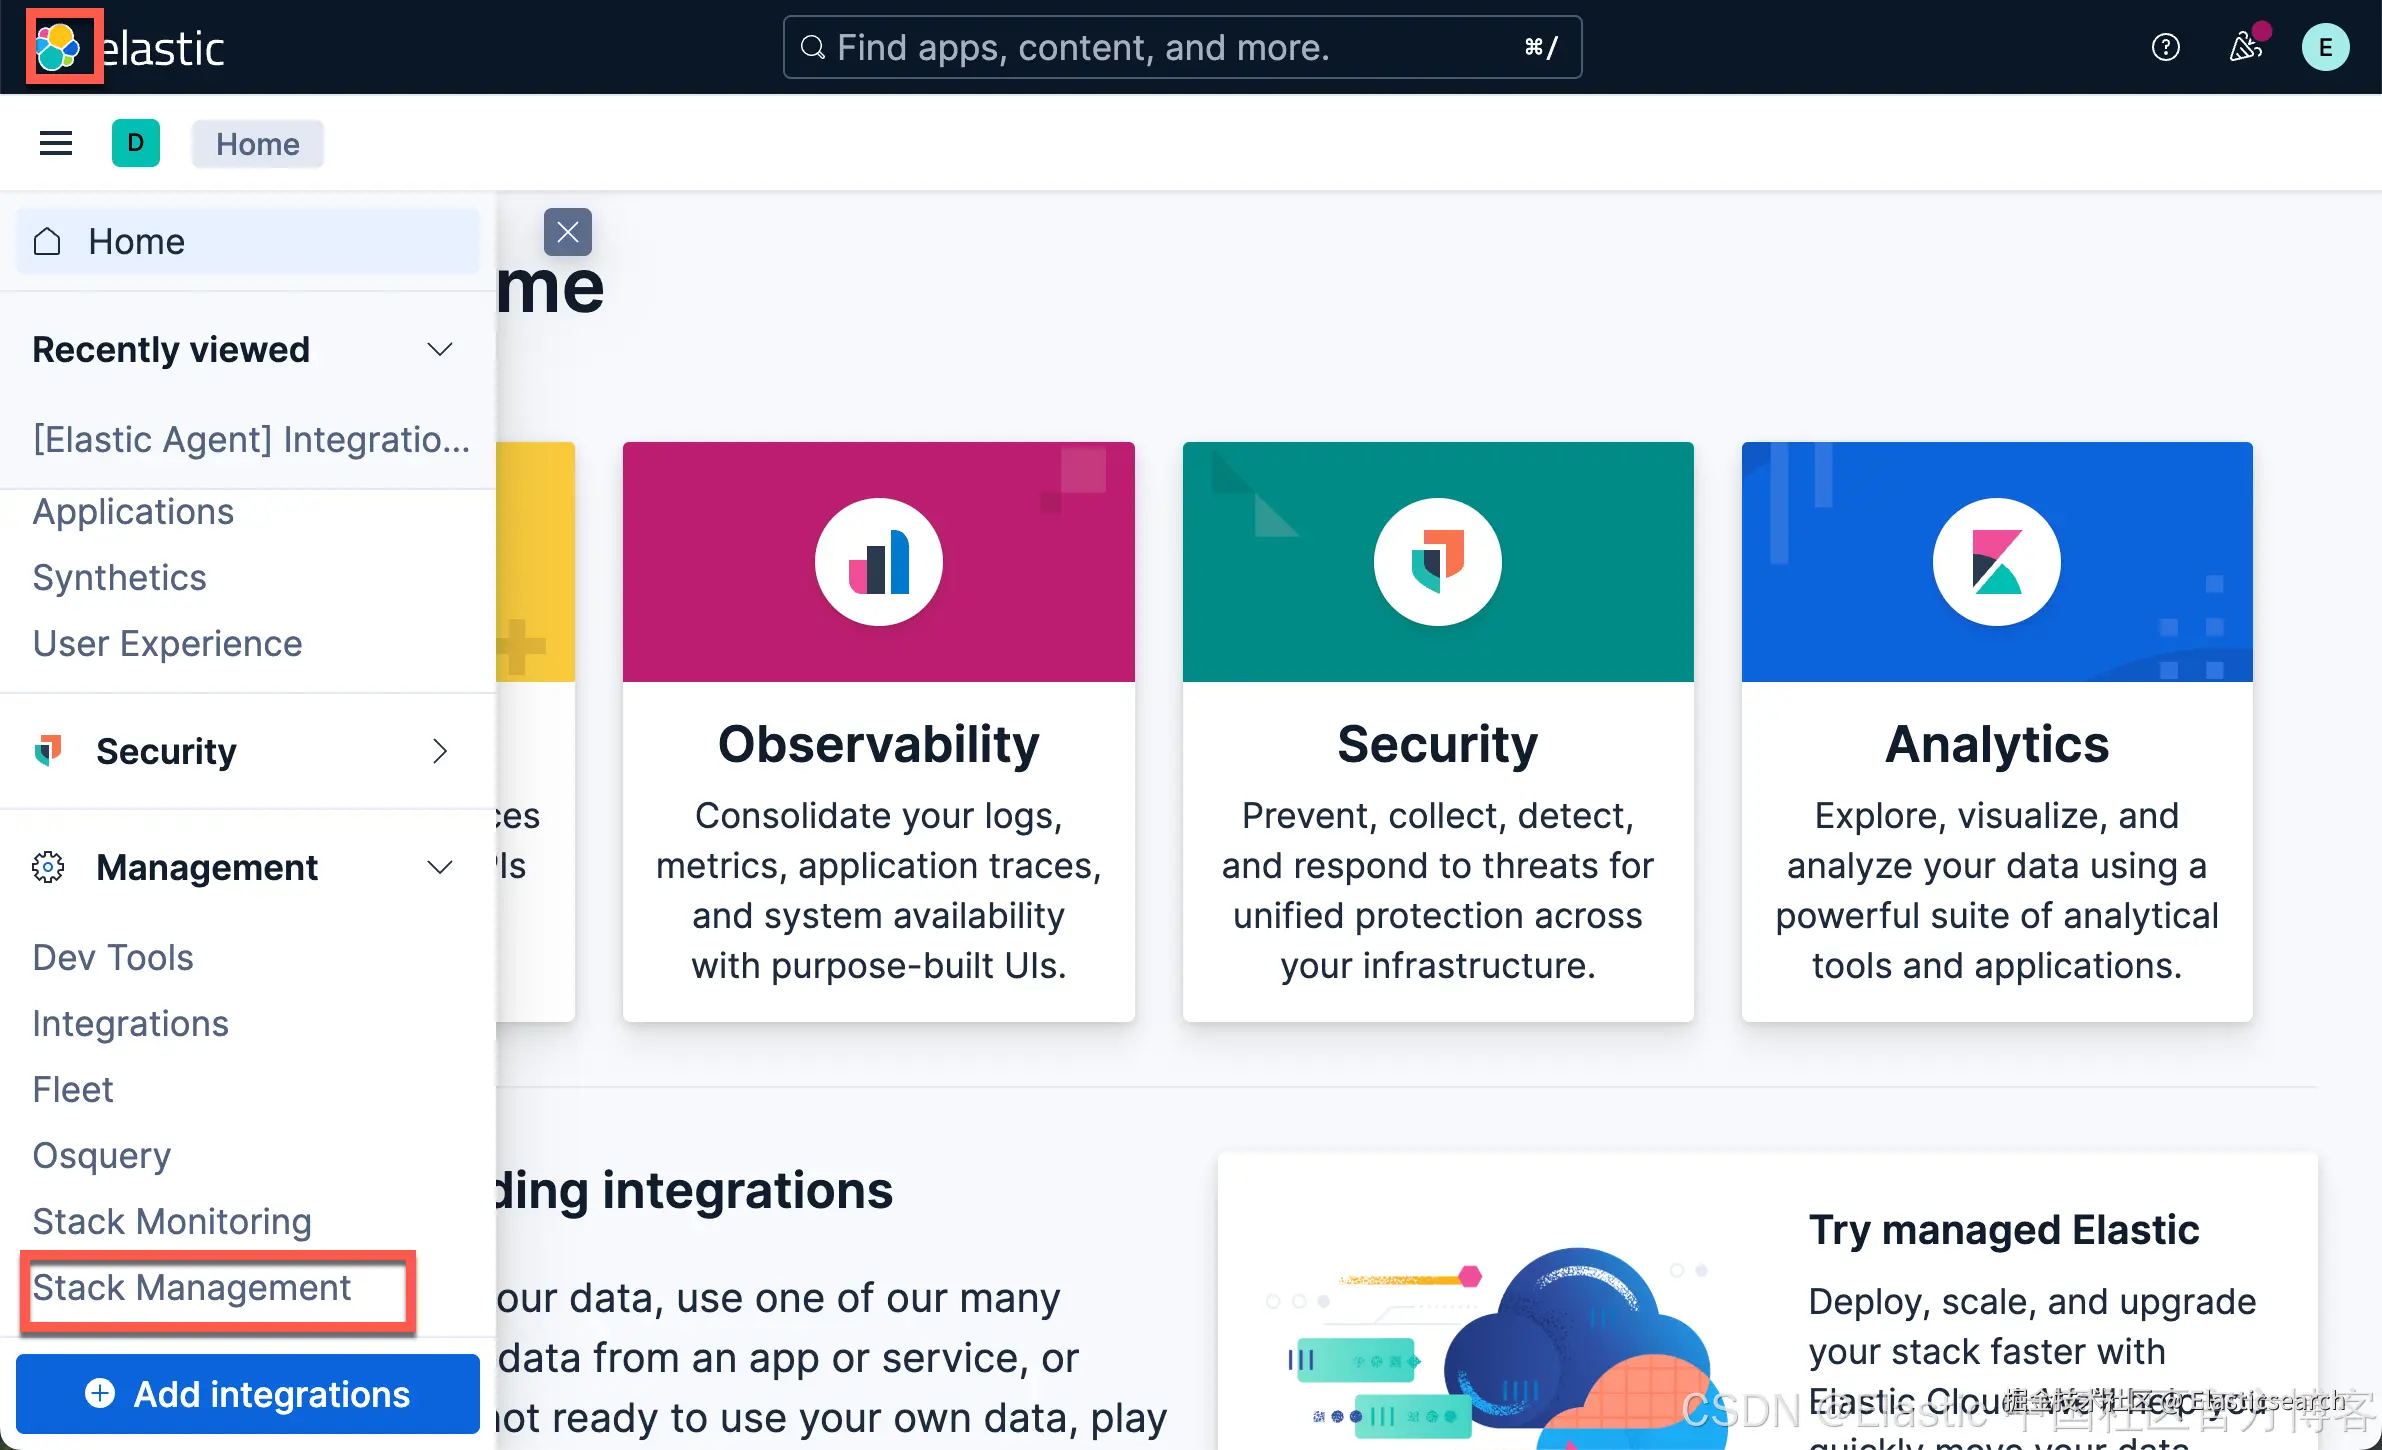
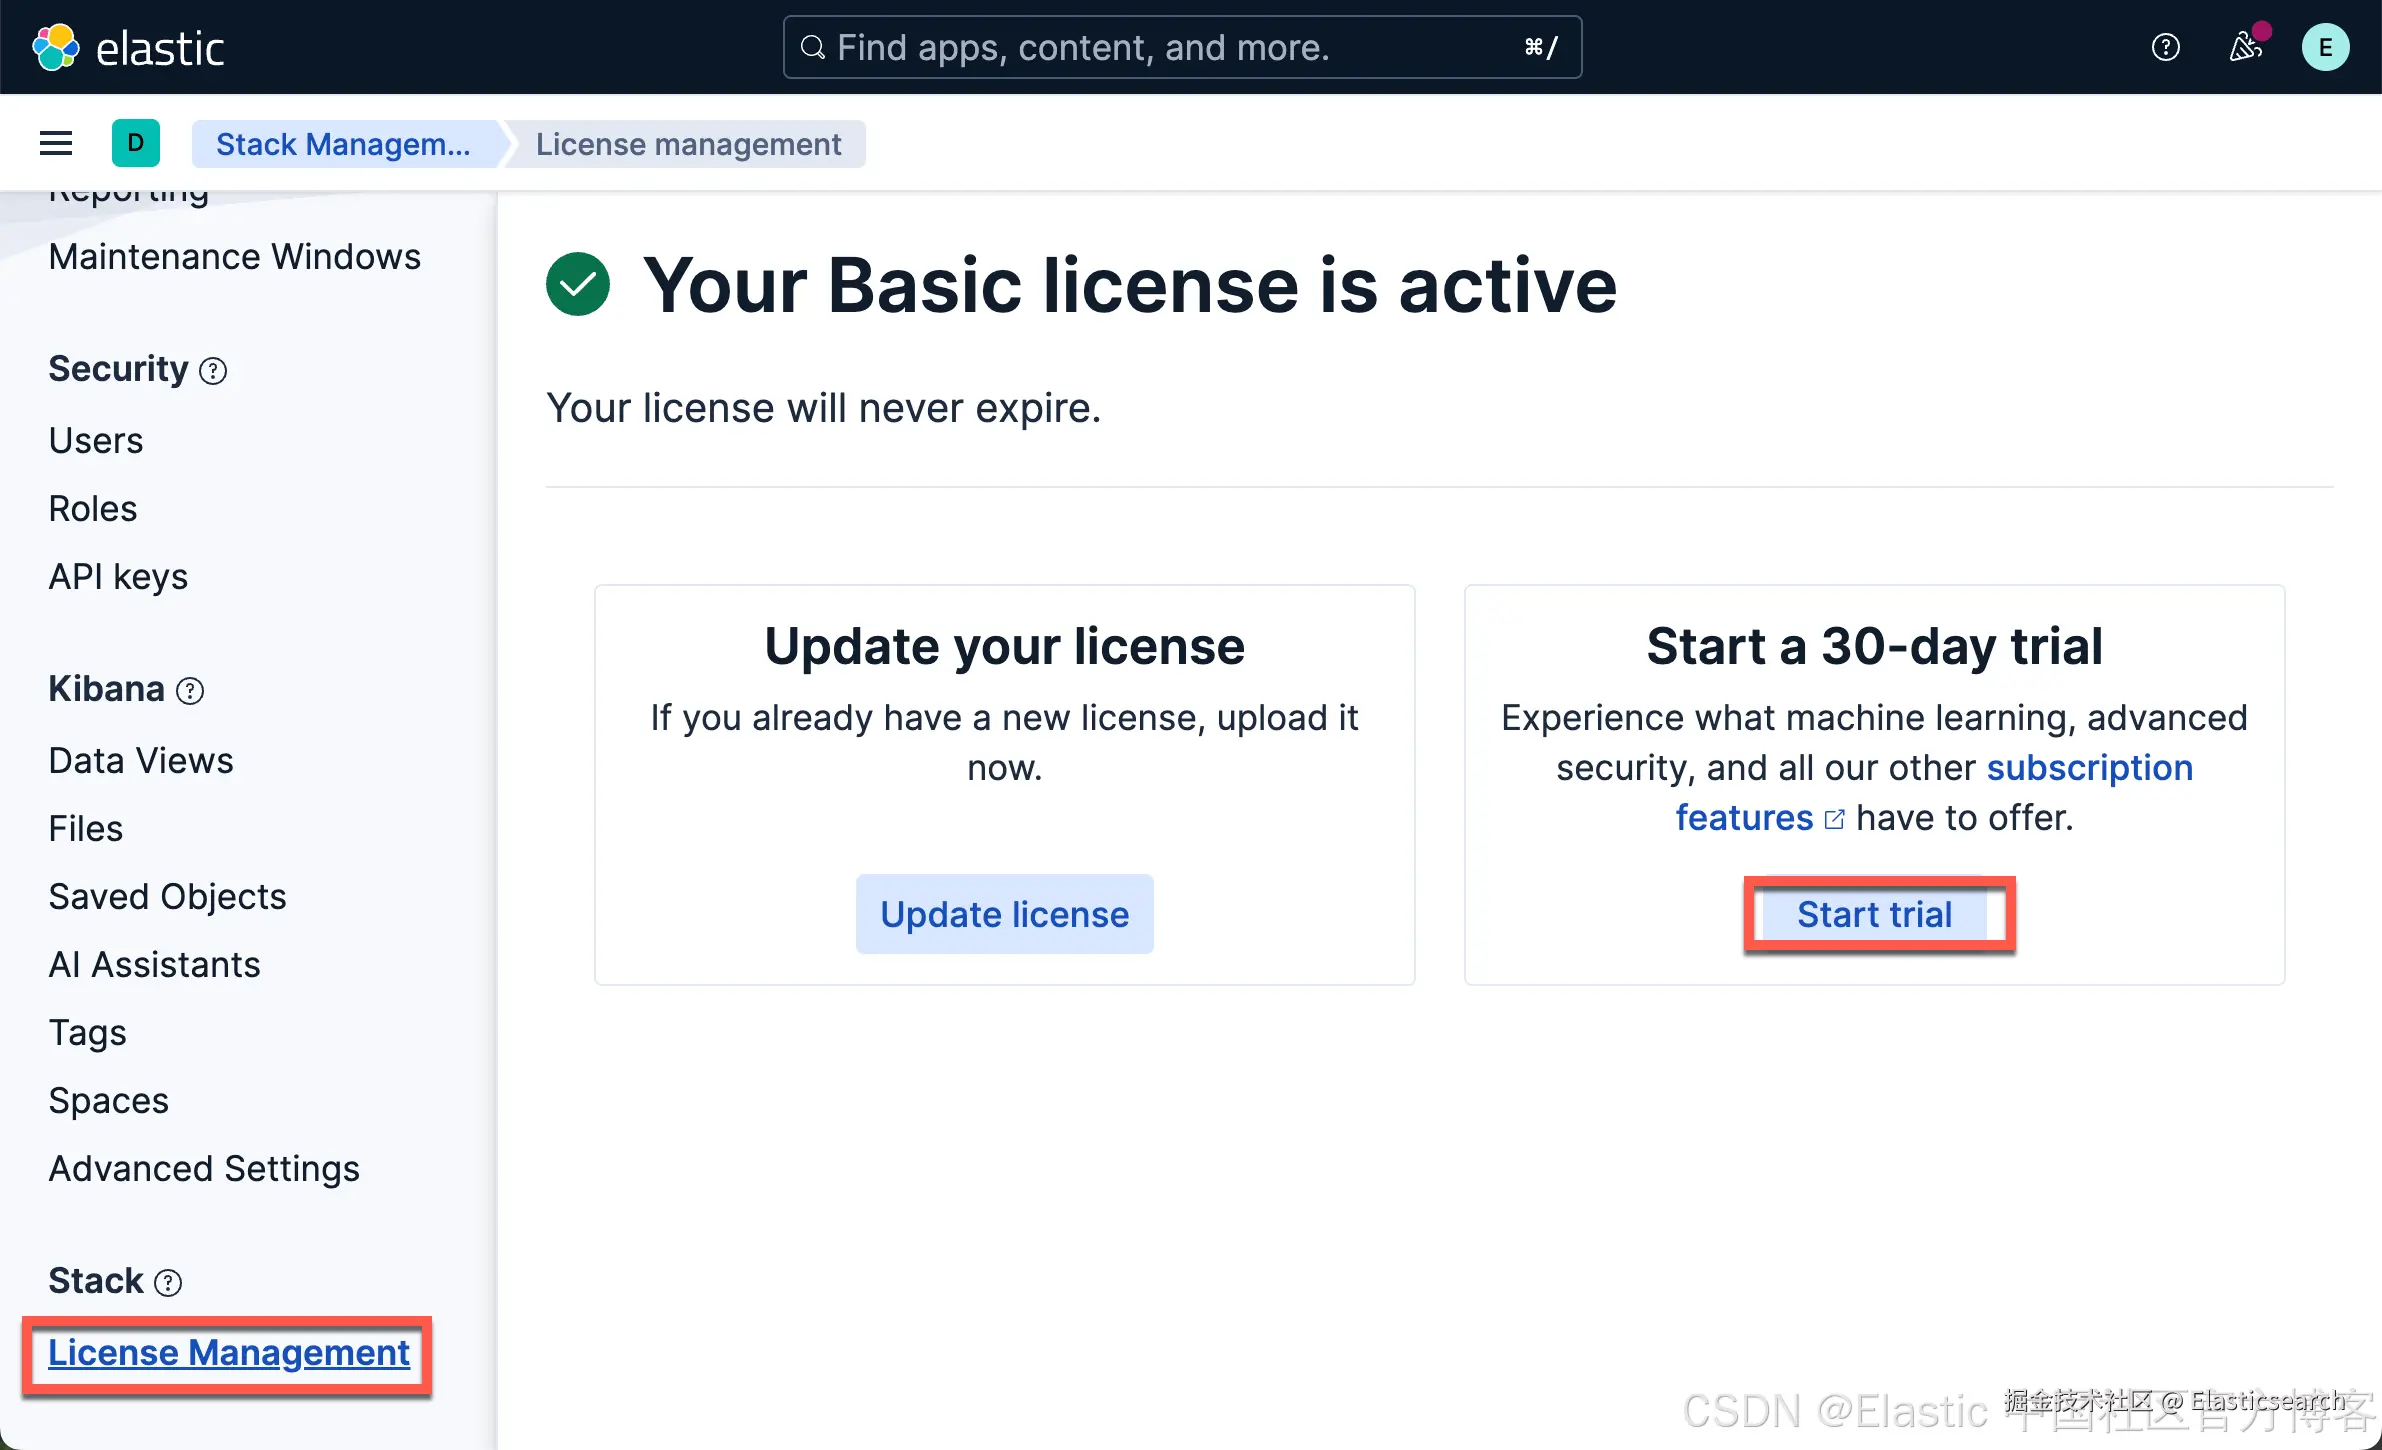
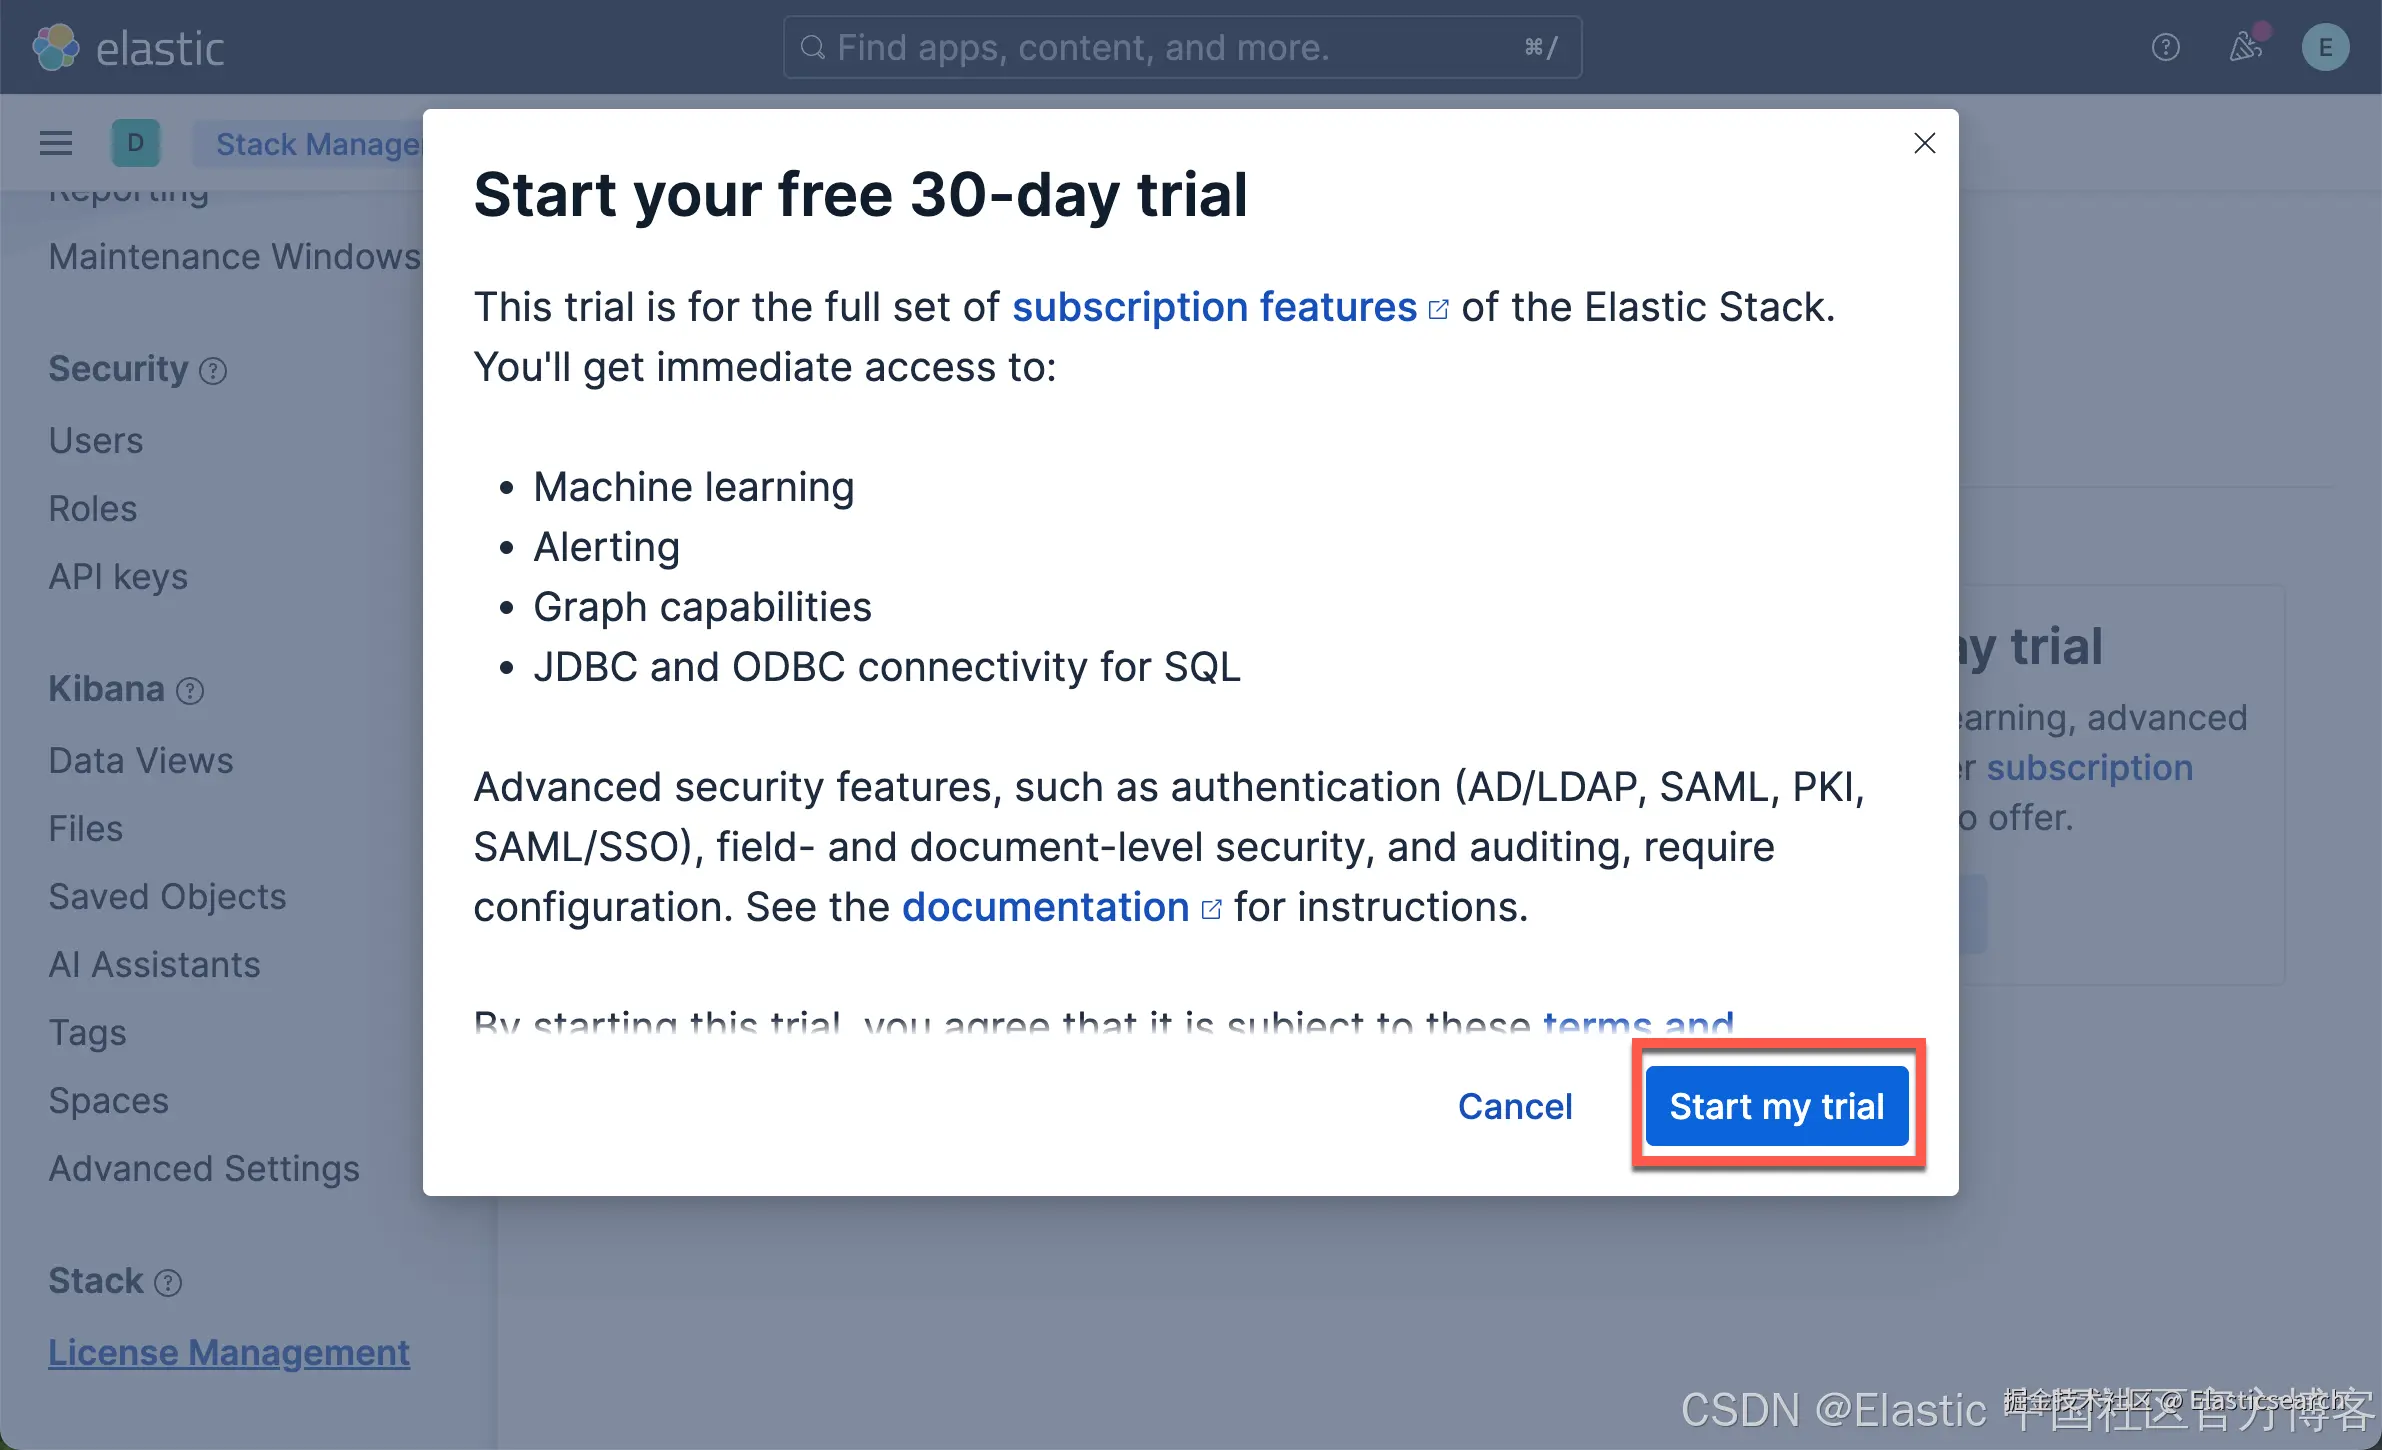
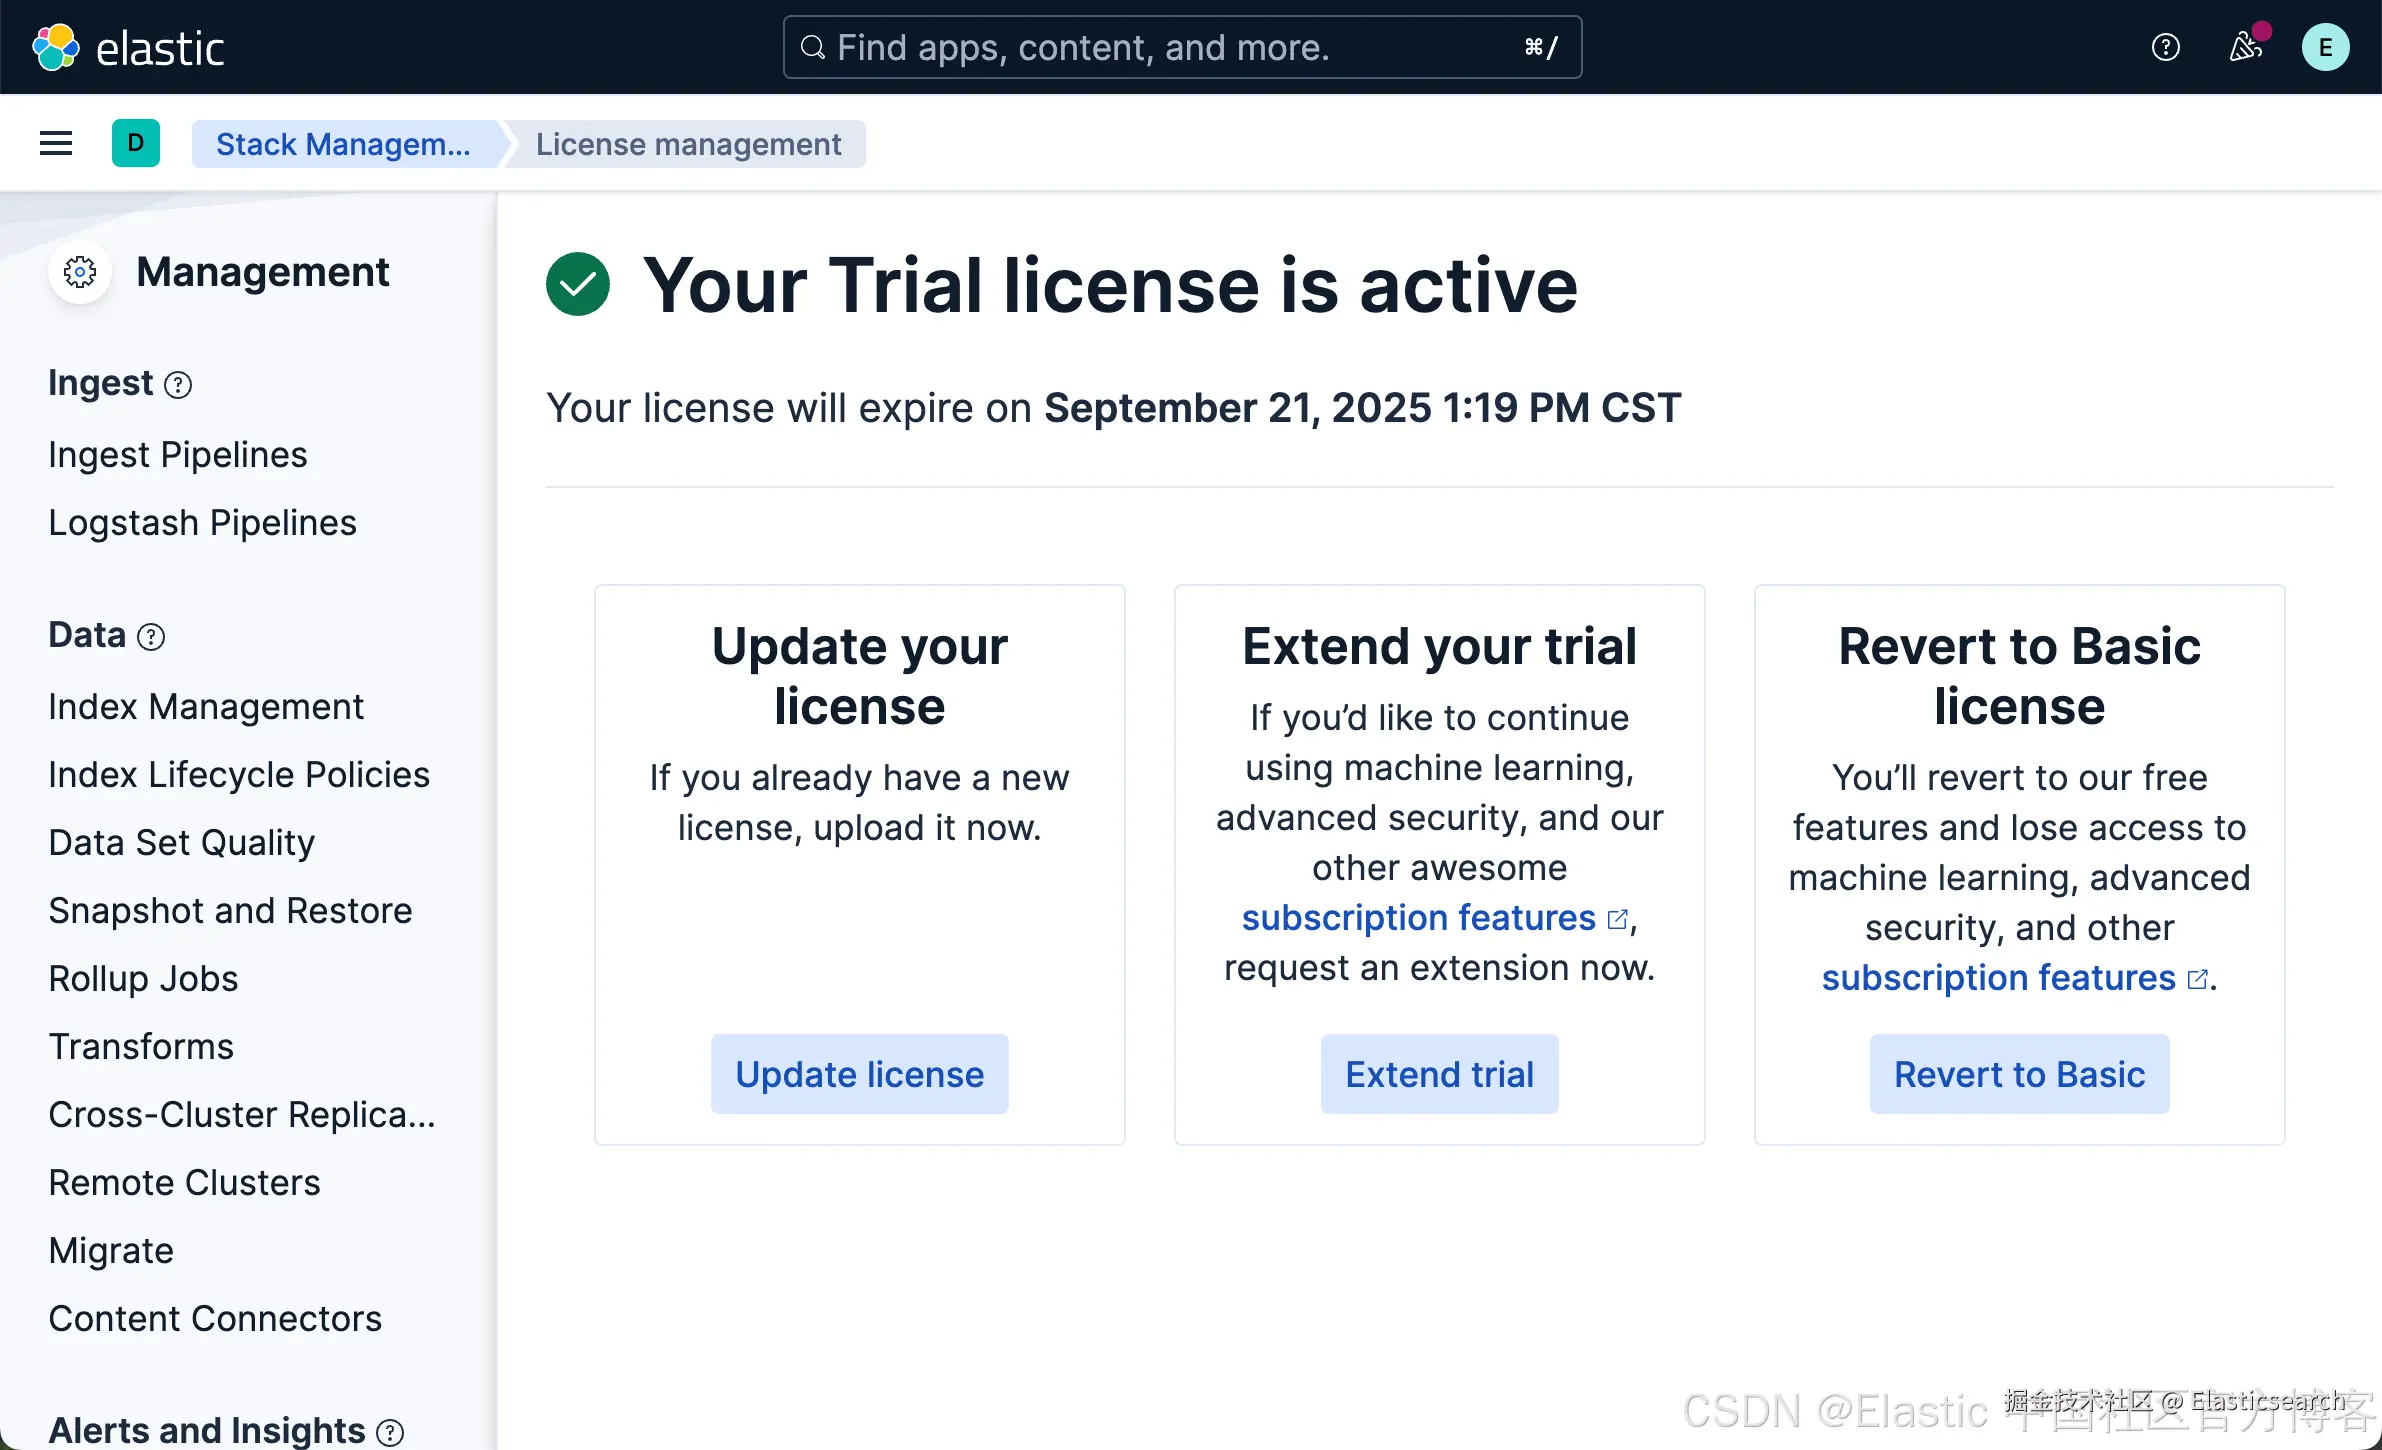
这样就启动了白金试用。
下载 ELSER 模型
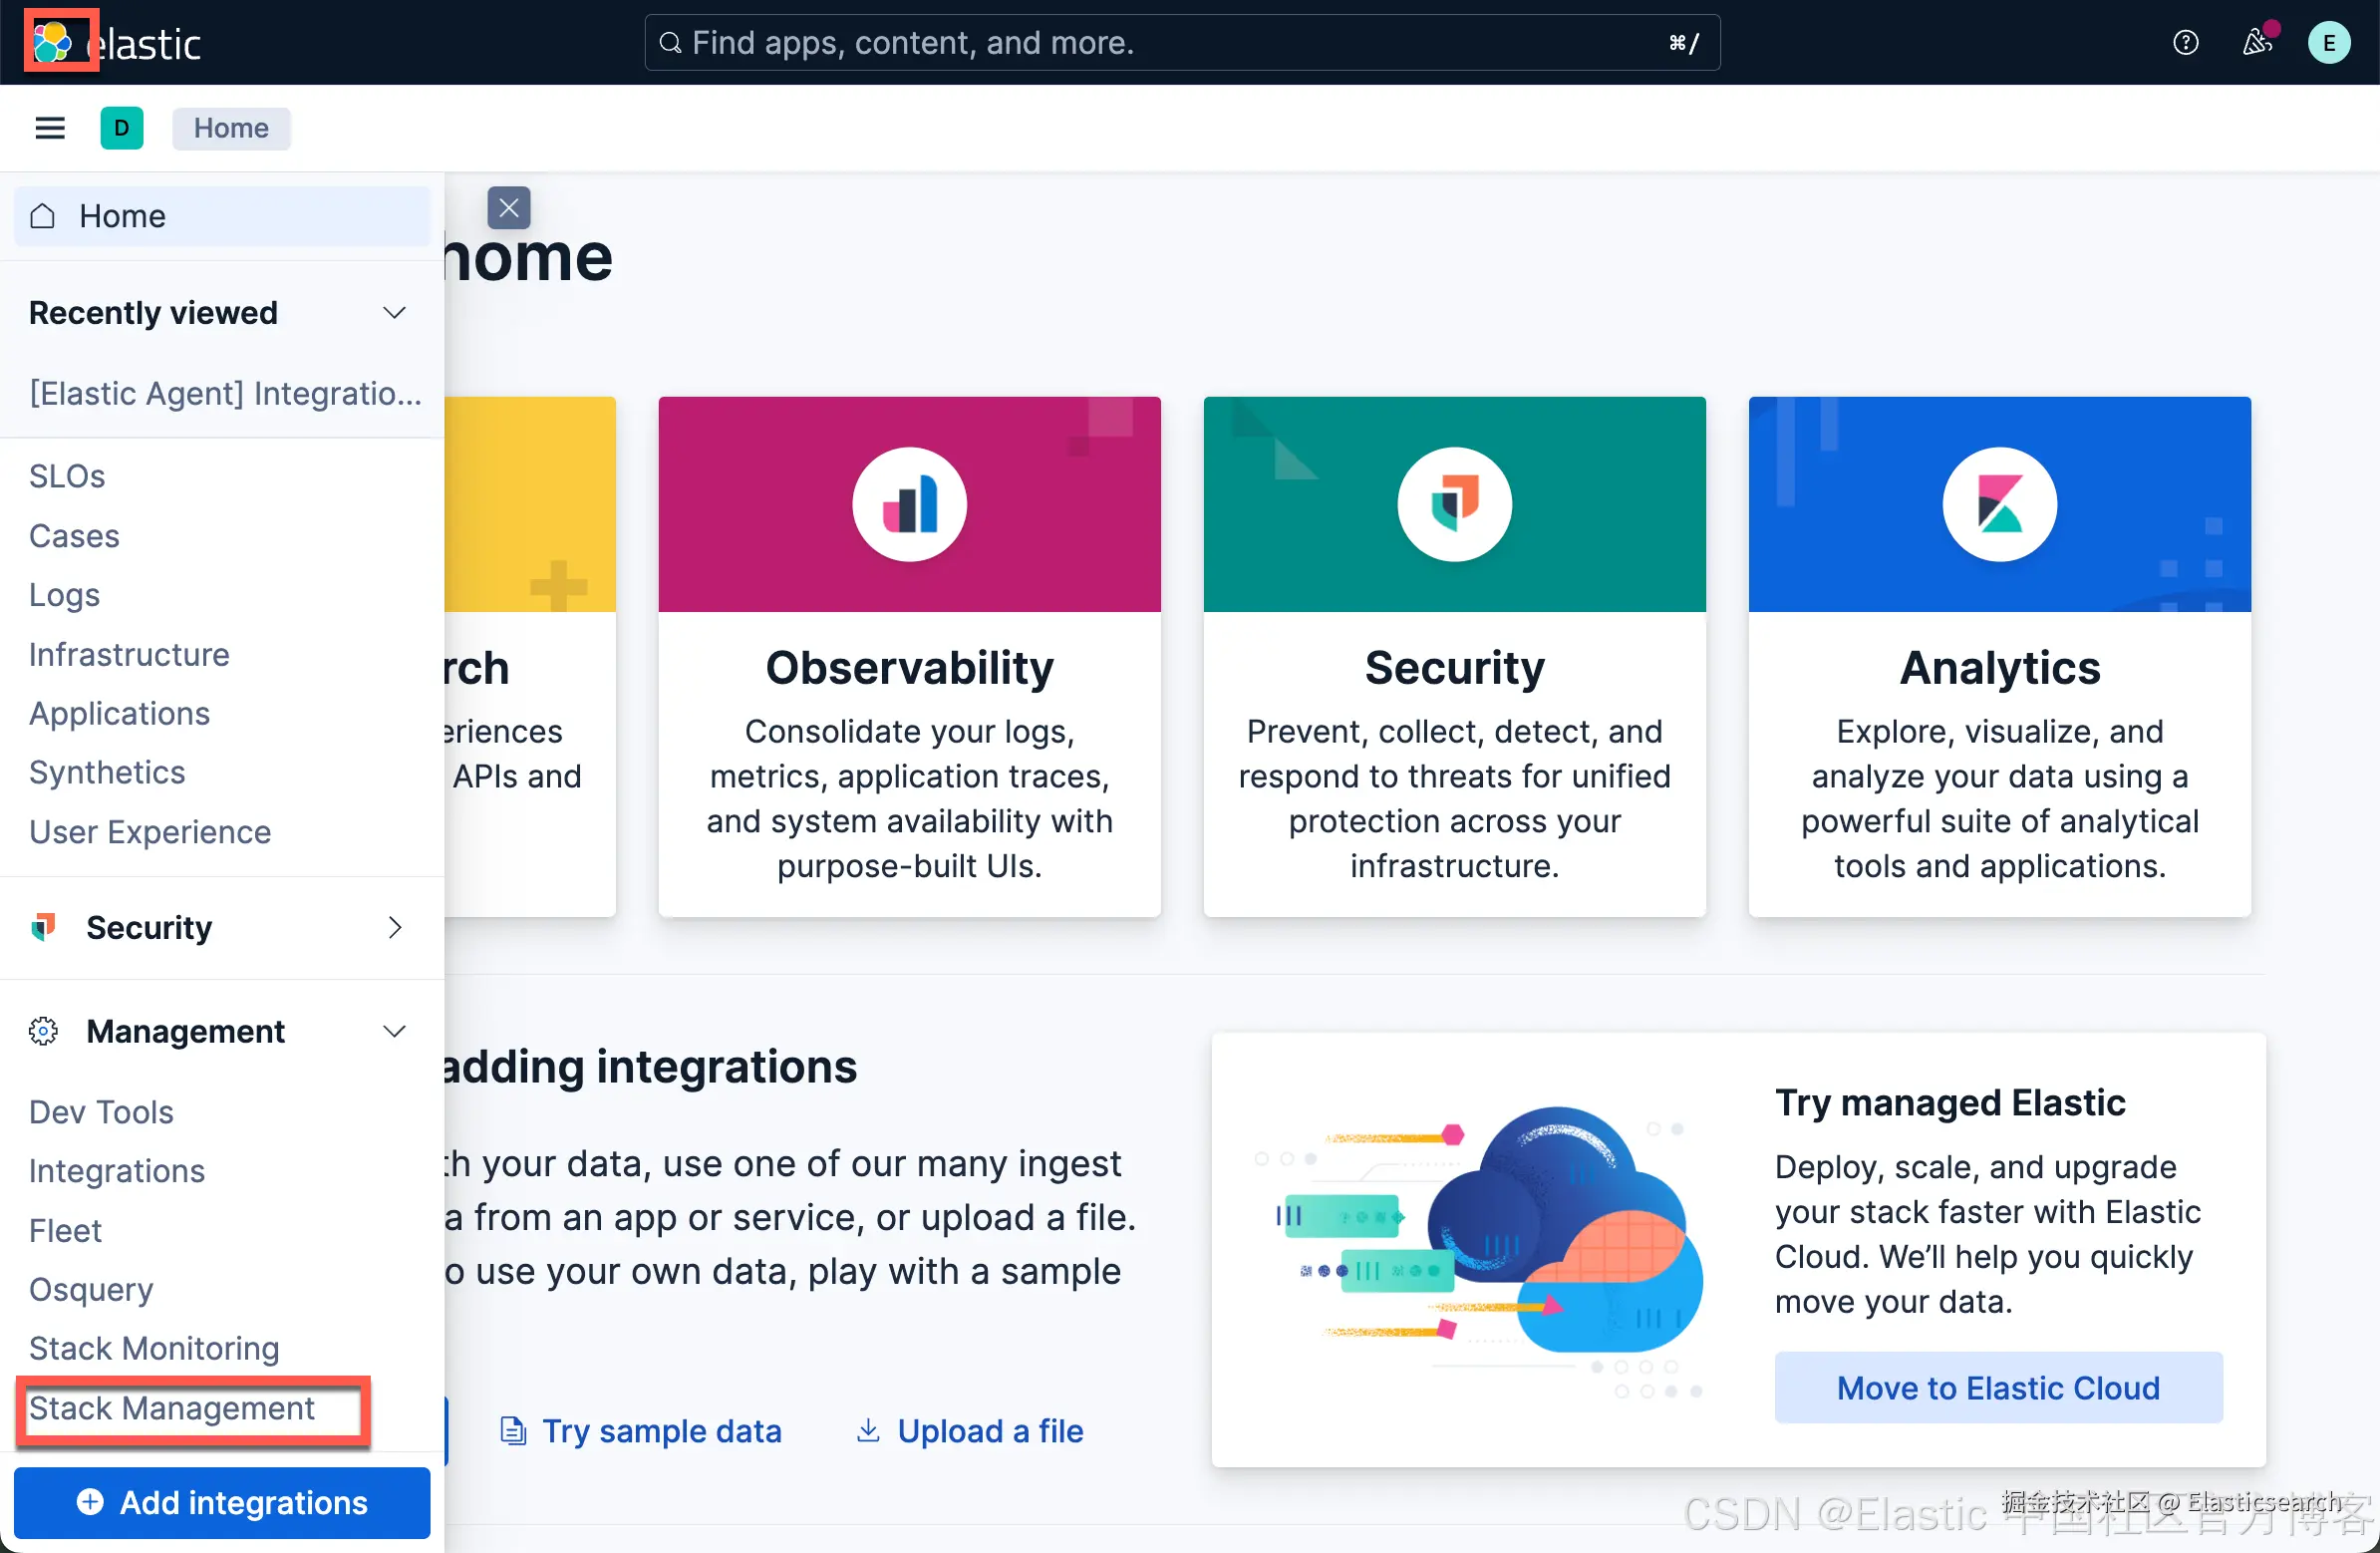
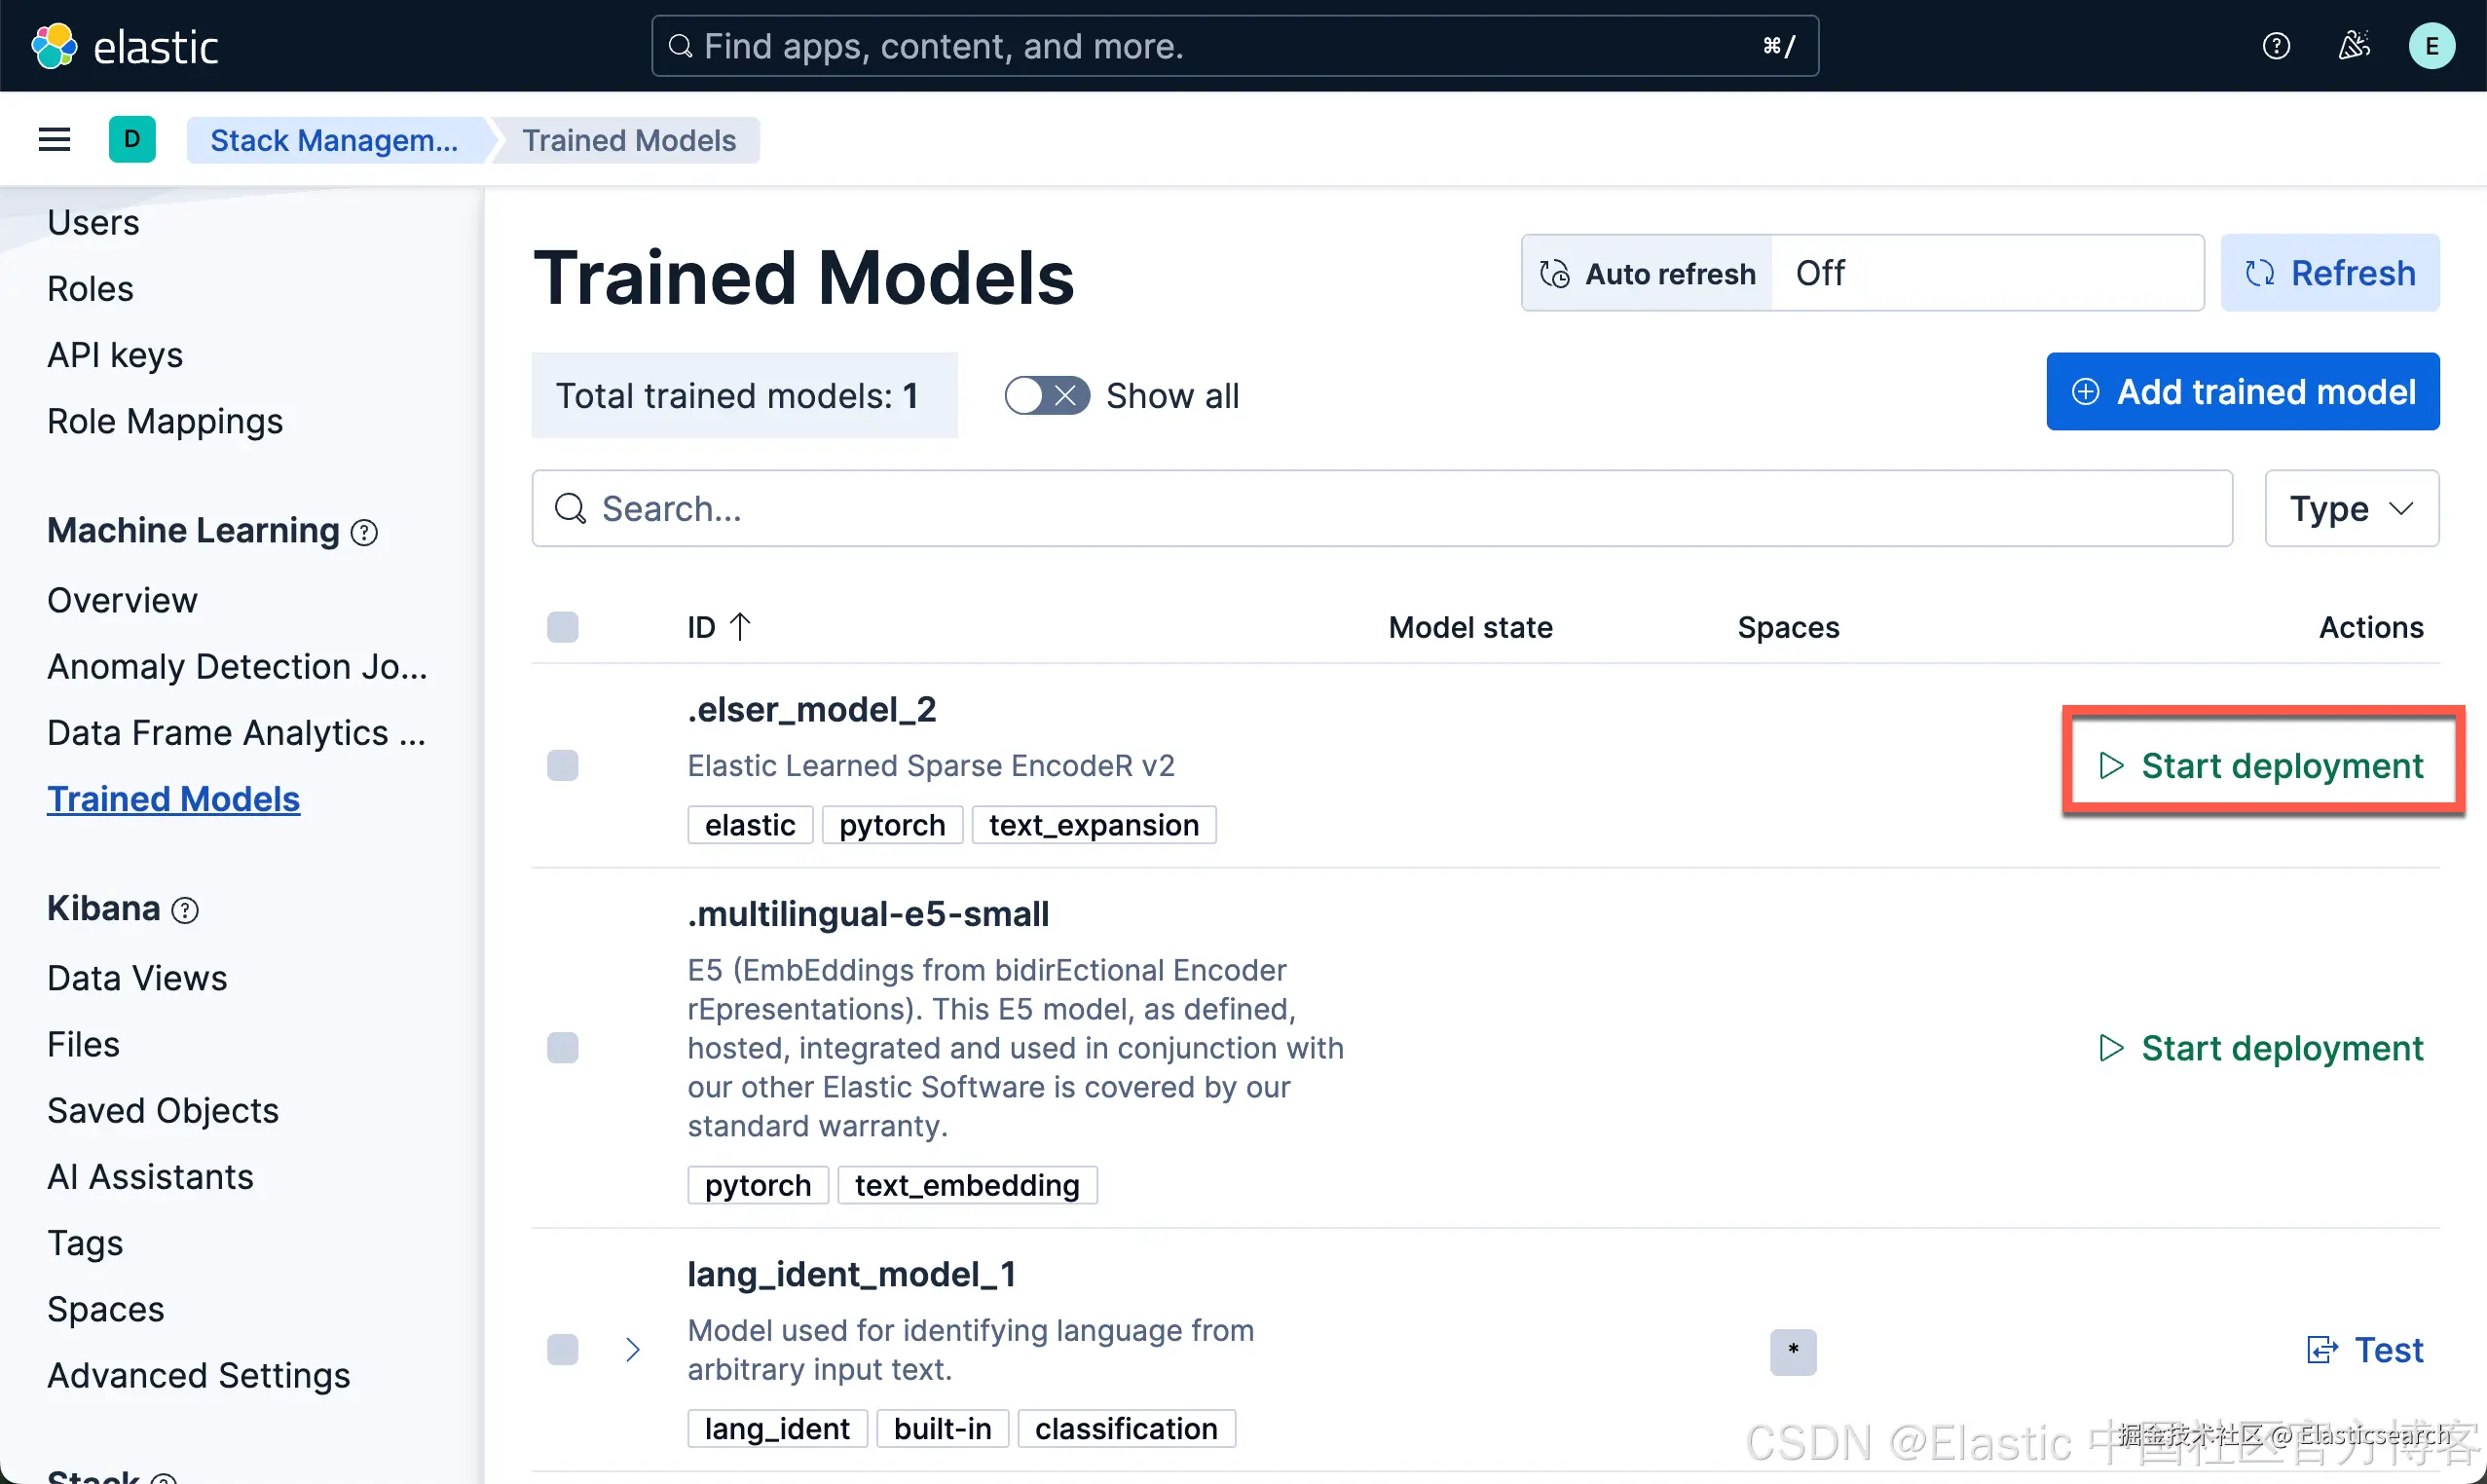
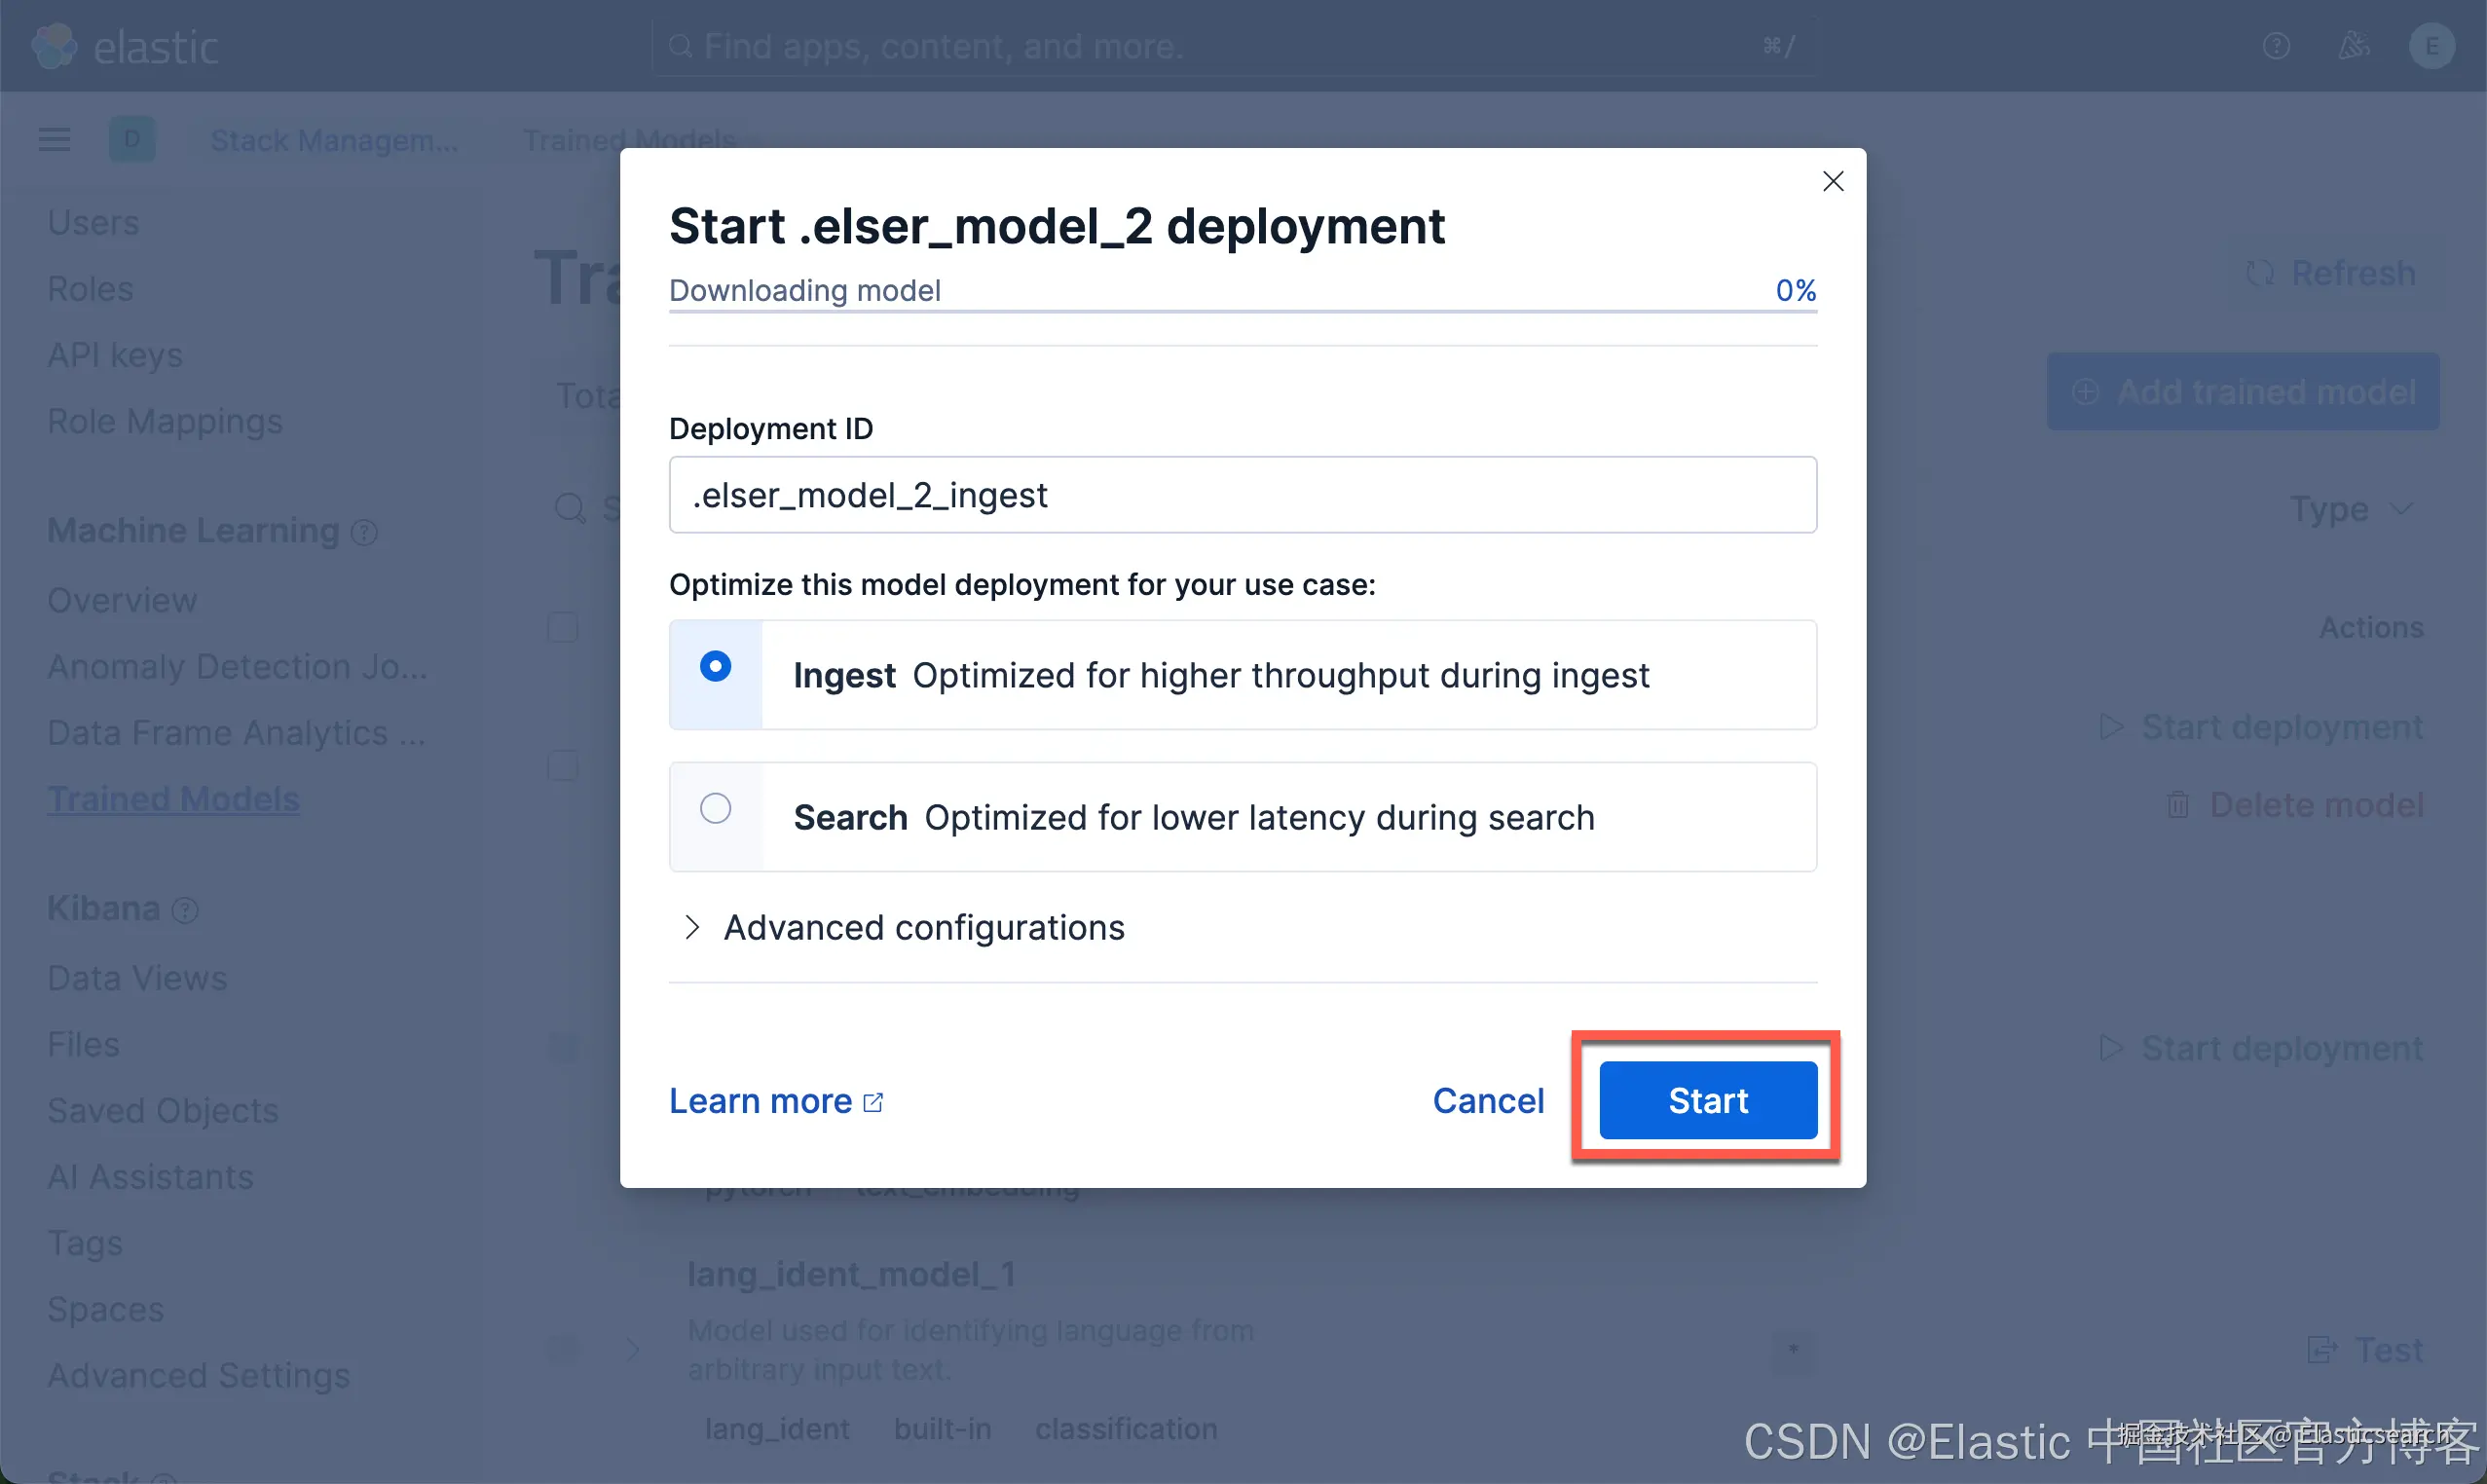
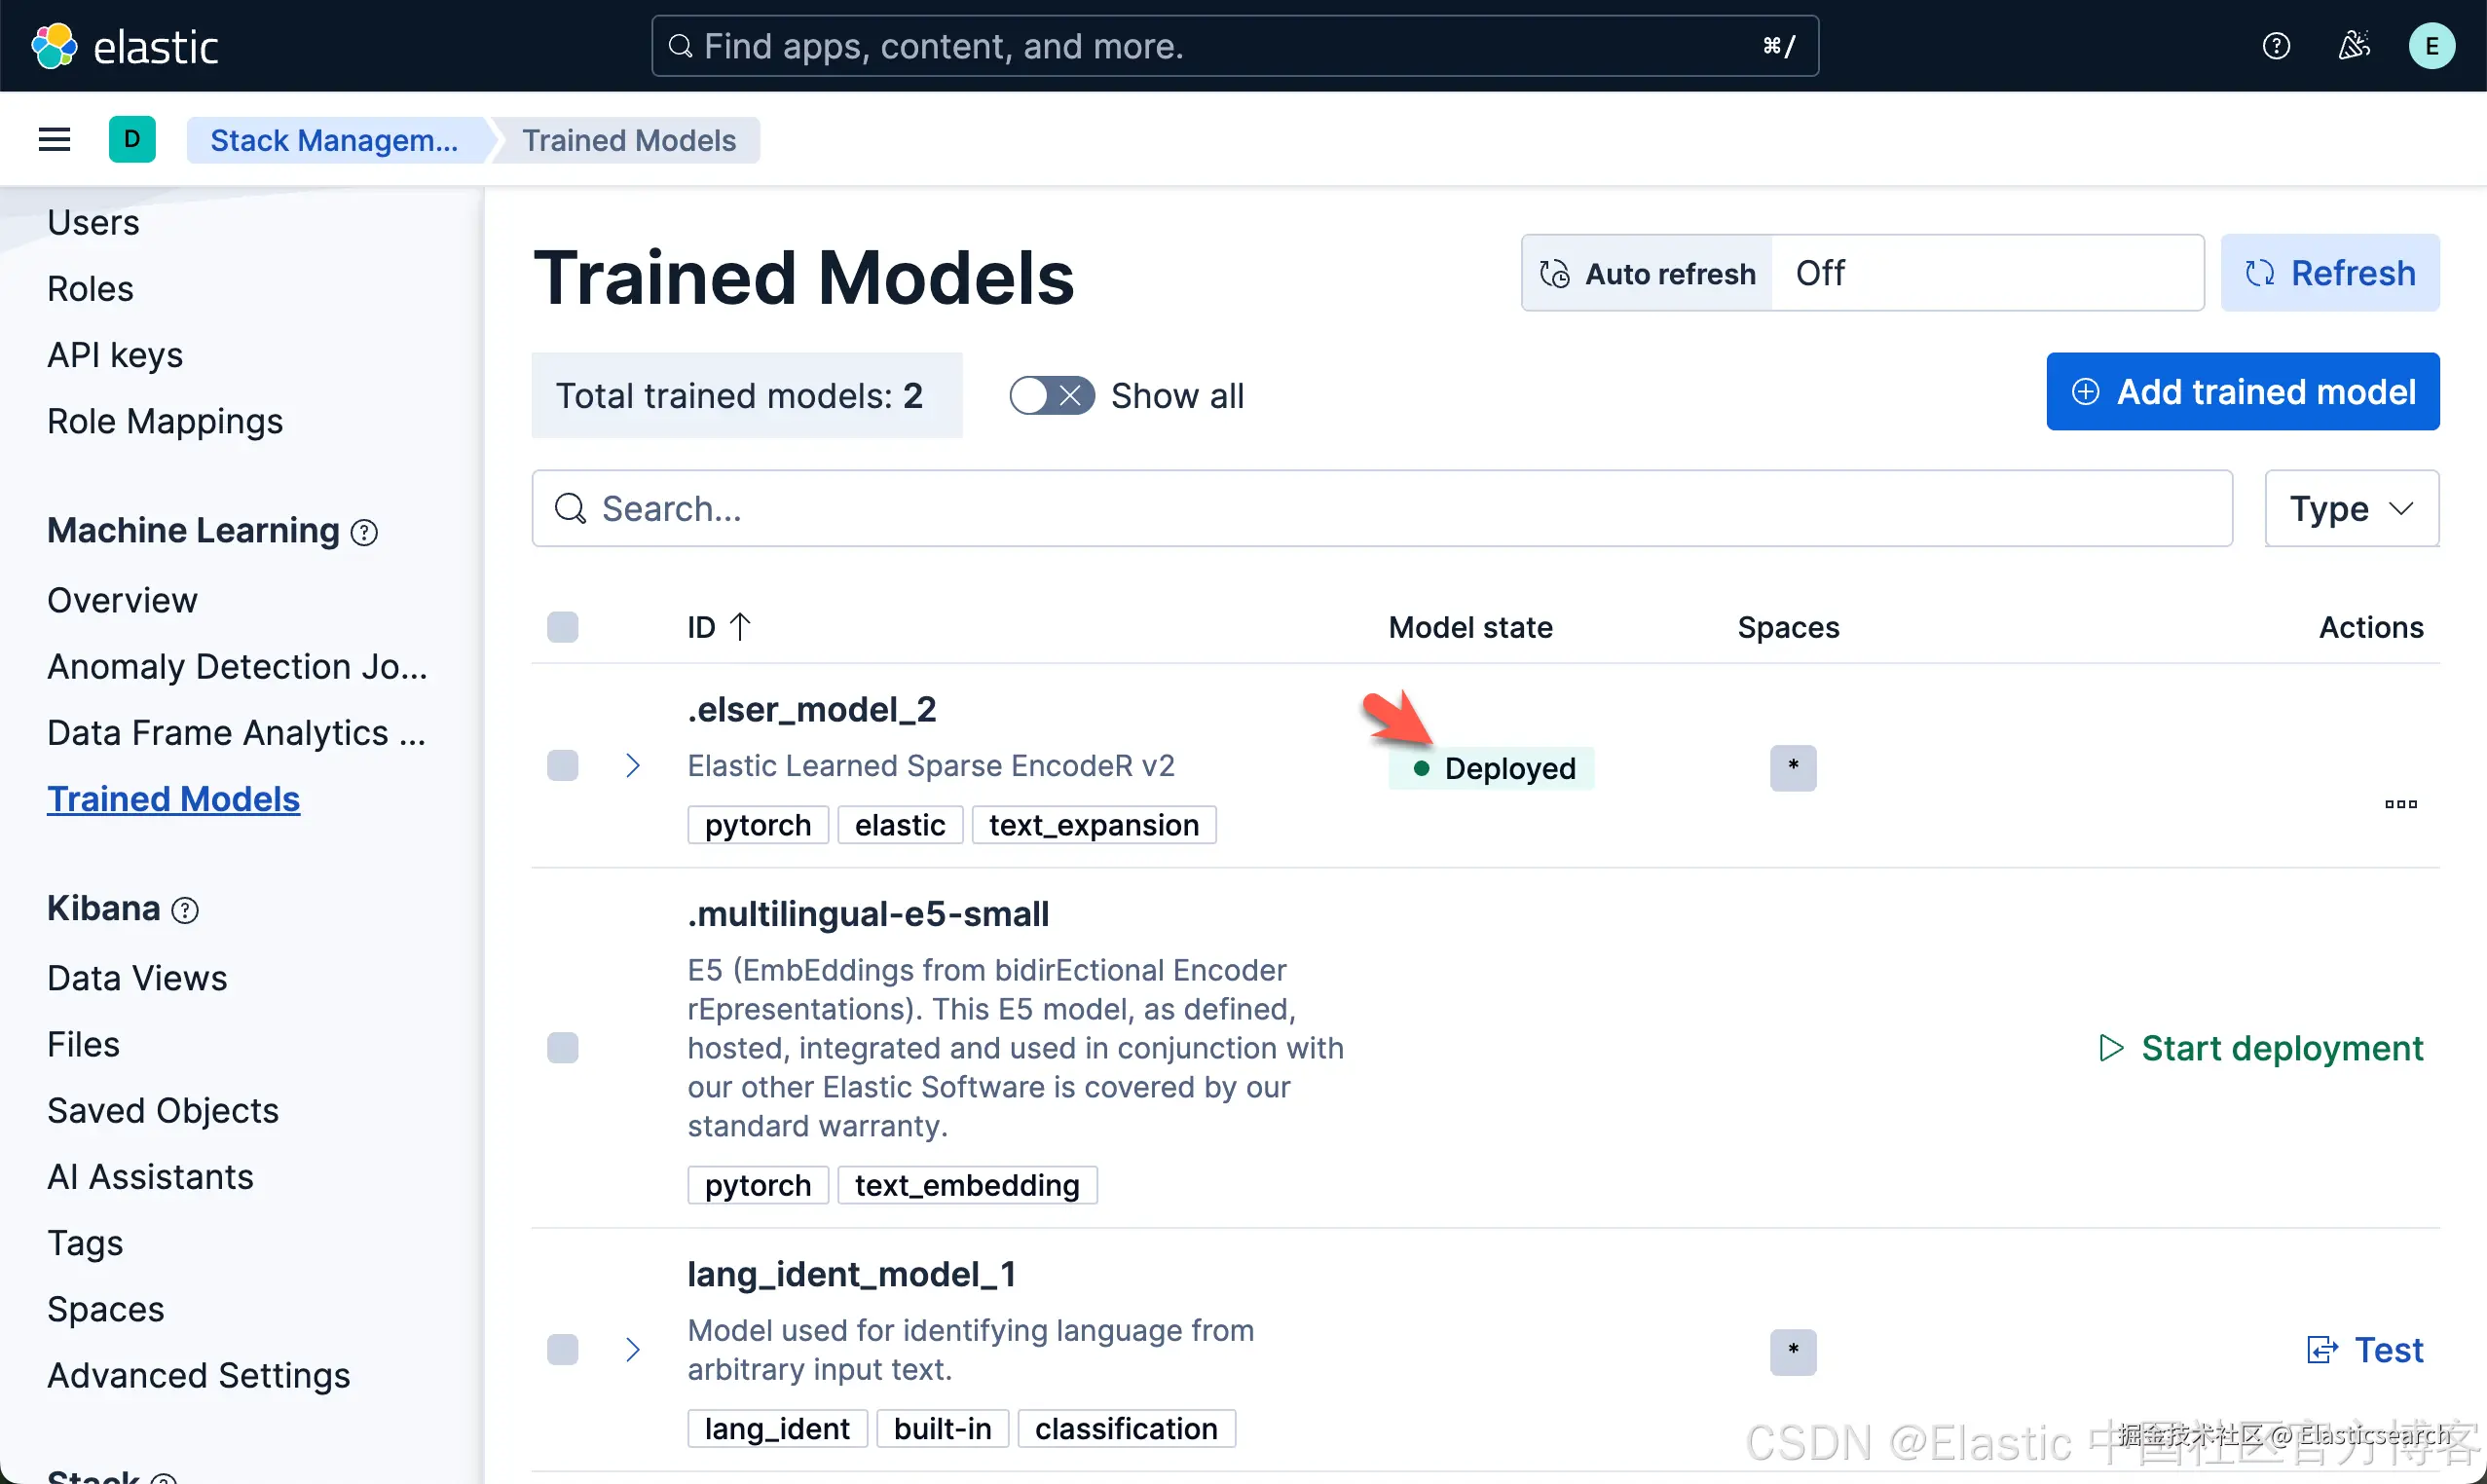
如果我们看到 Deployed,则表面我们已经成功地部署了 ELSER 模型。我们可以看到如下的 inference id 已经被生成:
bash
`GET _inference/_all`AI写代码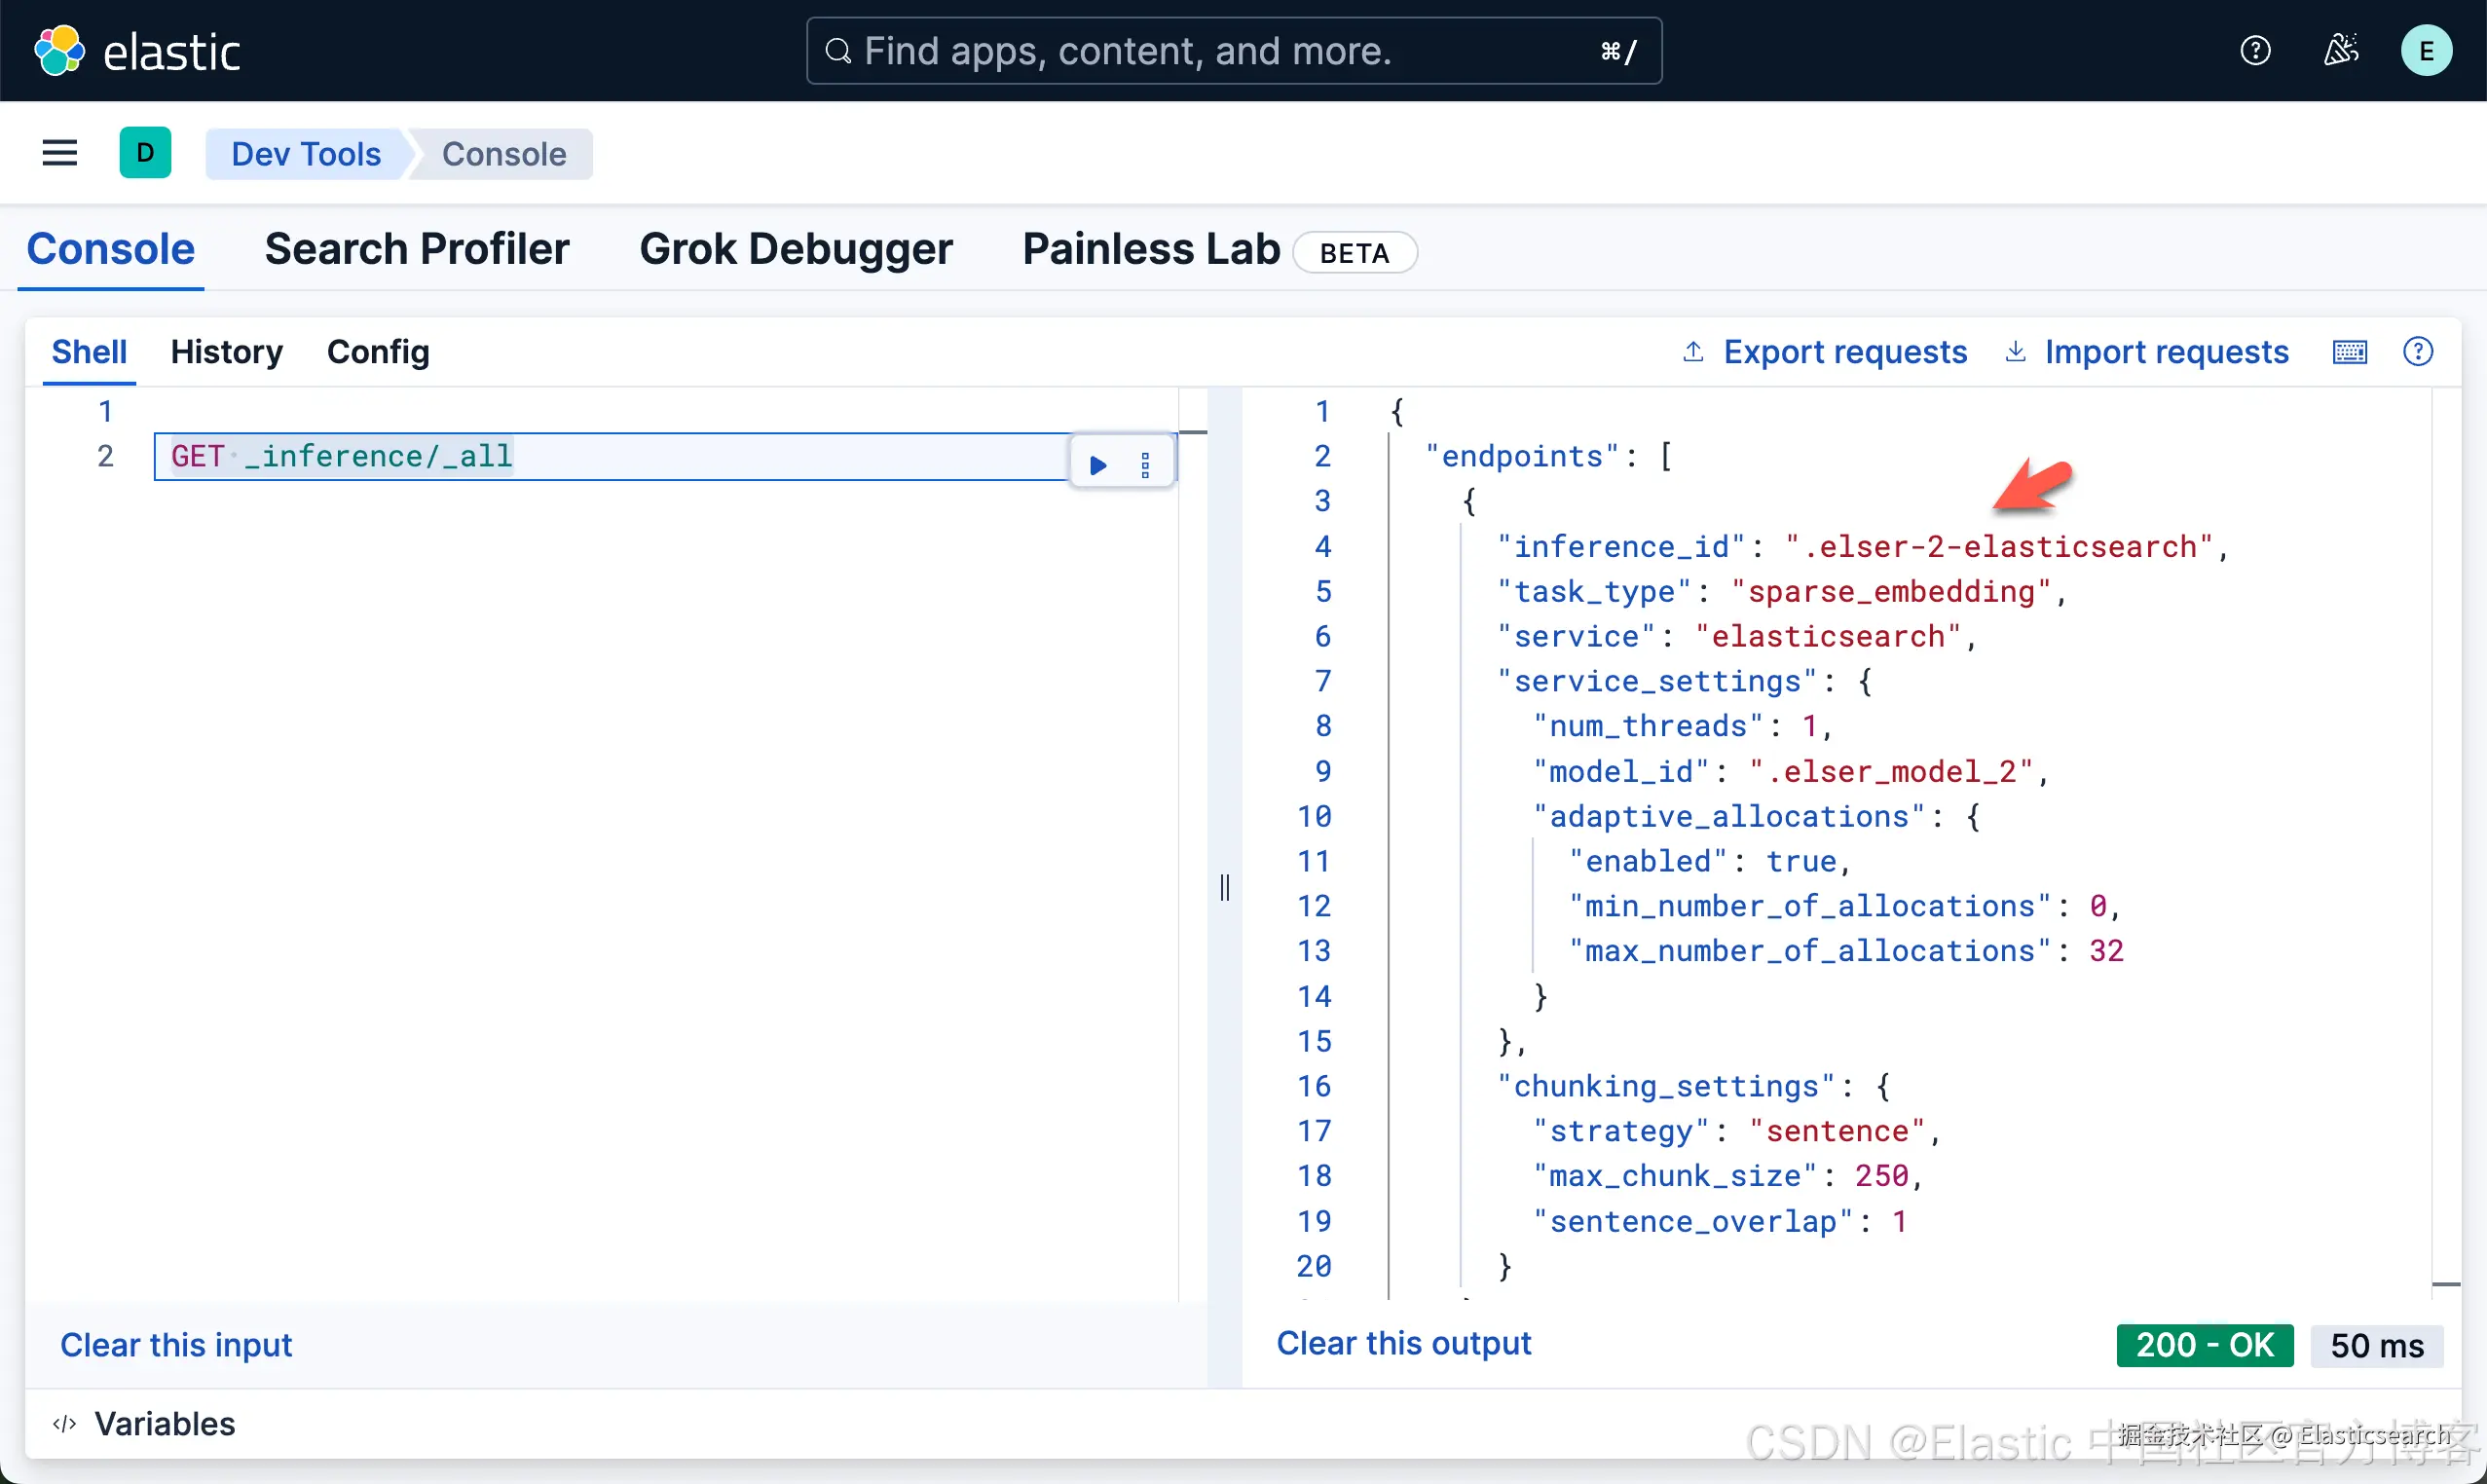
在下面,我们将使用如上所示的 .elser-2-elasticsearch inference id。
Elasticsearch MCP 服务器更新
自从发布这篇博客以来,我们推出了 elastic/mcp-server-elasticsearch。你可以在博客文章中了解更多信息:Connect Agents to Elasticsearch with Model Context Protocol。对于最新的 mcp-server-elasticsearch,你需要参考文章 "将 agents 连接到 Elasticsearch 使用模型上下文协议 - docker" 来拿进行连接。
什么是 Model Context Protocol (MCP)?
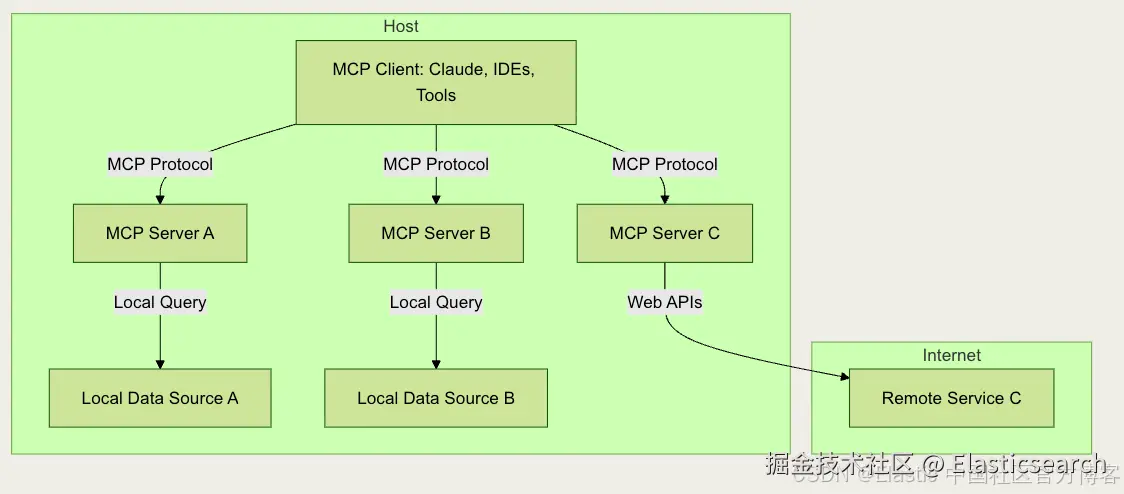
Model Context Protocol 定义了一种结构化方式,让 AI models 可以请求信息、执行工具,并在多次交互中保持 context(详细内容请参阅官方文档)。它规范了以下之间的通信:
- MCP Clients (聊天应用、AI assistants),代表用户请求 信息或调用工具。
- MCP Servers (搜索工具、数据库、外部 APIs),响应相关数据或执行操作。
与传统的基于 RAG 的设置仅检索文档不同,MCP 使 AI 能够通过调用一个或多个 MCP servers 暴露的多个工具来编排和执行 workflows。
MCP 架构
为什么在 RAG 中使用 MCP Server 与 Elasticsearch?
语义搜索通过理解 context 和 intent 提升了传统基于关键词的搜索。将 MCP server 与 Elasticsearch 集成,我们可以实现:
- 更准确的搜索结果 -- MCP 允许 AI models 选择专用的搜索工具,甚至动态创建超越简单关键词匹配的结构化查询。
- 动态 agent workflows -- AI 可以根据实时数据调用 APIs、过滤响应并触发操作。
- 多工具集成 -- MCP 让 AI 与多个数据源交互,将搜索与实时洞察结合。
构建 MCP Server
让我们构建一个 MCP Tool,使你能够在 Elastic Search Labs 的博客中进行语义搜索。助手将根据用户的意图使用此工具。
我准备了一个 demo repo,这是抓取示例数据集、使用 semantic_text 映射嵌入抓取内容,并通过 MCP server 暴露工具进行语义搜索的良好起点。
你可以通过以下步骤轻松将其适配到你自己的用例,或查看 repo 的 README 获取更多细节。
抓取博客数据并在 Elasticsearch 中生成 Embeddings
为了支持语义查询,我们将使用 semantic_text,这是一种专门的 mapping,在数据被写入索引后会自动执行分块和 embedding。
创建一个用于存储数据的索引:
c
`PUT search-labs-posts`AI写代码更新 mappings。Elastic Open Crawler 默认会将网站内容填充到 body 字段中:
bash
`
1. PUT search-labs-posts/_mappings
2. {
3. "properties": {
4. "body": {
5. "type": "text",
6. "copy_to": "semantic_body"
7. },
8. "semantic_body": {
9. "type": "semantic_text",
10. "inference_id": ".elser-2-elasticsearch"
11. }
12. }
13. }
`AI写代码注意 :.elser-2-elasticsearch 是 ES 中预配置的推理端点。它将被 semantic_text mapping 用来为自动分块的内容生成稀疏 embeddings。
我正在使用 Elastic Open Crawler 快速将数据填充到 Elasticsearch 中。
你应该按照 demo repo 中列出的步骤操作。它会指导你把正确的 ES 凭证放入 crawler-config/elastic-search-labs-crawler.yml 中的爬虫配置里。
bash
`
1. $ pwd
2. /Users/liuxg/python
3. $ git clone https://github.com/liu-xiao-guo/elastic-semantic-search-mcp-server
4. Cloning into 'elastic-semantic-search-mcp-server'...
5. remote: Enumerating objects: 28, done.
6. remote: Counting objects: 100% (28/28), done.
7. remote: Compressing objects: 100% (19/19), done.
8. remote: Total 28 (delta 8), reused 20 (delta 4), pack-reused 0 (from 0)
9. Receiving objects: 100% (28/28), 15.62 KiB | 3.90 MiB/s, done.
10. Resolving deltas: 100% (8/8), done.
11. $ cd elastic-semantic-search-mcp-server/
12. $ ls
13. Makefile README.md crawler-config pyproject.toml server.py uv.lock
`AI写代码我们首先把 env.example 拷贝到 .env 文件中,并做相应的配置:
.env
ini
`

1.  ES_URL="https://192.168.101.192:9200"
2.  API_KEY="b2Nac21aa0I5NnpZa1ZqREJRWU46Q2lBZmU3aFNwMWVqZmtLMENLSE13QQ=="

`AI写代码注意:请在上面根据自己的 ES 配置做相应的修改。为了能够让 docker 能正确访问我们的 ES,我们的 ES 不能使用 localhost。
对于我们的 ES 安装,我们使用的是自签名证书。我们使用如下的命令把 ES 的证书拷贝到当前的目录下:
bash
`

1.  $ pwd
2.  /Users/liuxg/python/elastic-semantic-search-mcp-server
3.  $ cp ~/elastic/elasticsearch-9.1.4/config/certs/http_ca.crt ./crawler-config/
4.  $ ls ./crawler-config/
5.  elastic-search-labs-crawler.yml http_ca.crt                     test-crawler.yml

`AI写代码
由于我们是自签名的证书,我们需要重新修改一下 elastic-search-labs-crawler.yml 文件:
elastic-search-labs-crawler.yml
yaml
`
1. domains:
2. - url: https://www.elastic.co
3. seed_urls:
4. - https://www.elastic.co/search-labs
5. crawl_rules:
6. - policy: allow
7. type: begins
8. pattern: /search-labs
9. - policy: deny
10. type: regex
11. pattern: .*
13. output_sink: elasticsearch
14. output_index: search-labs-posts
16. max_crawl_depth: 10
17. max_title_size: 500
18. max_body_size: 5_242_880
19. max_keywords_size: 512
20. max_description_size: 512
21. max_indexed_links_count: 10
22. max_headings_count: 10
24. elasticsearch:
25. host: https://192.168.101.192
26. port: 9200
27. # username: elastic
28. # password: GK1JT0+tbYQV02R9jVP*
29. api_key: bzhZRW1wa0I5NnpZa1ZqRGhRYl86akdfMExCSkZzUUh2QVRsd2UtQ2tHUQ==
30. bulk_api:
31. max_items: 10
32. max_size_bytes: 1_048_576
33. ca_file: /app/config/http_ca.crt
`AI写代码请注意上面的 ca_file 配置。我们把证书配置进去。更多配置,请参阅文档。
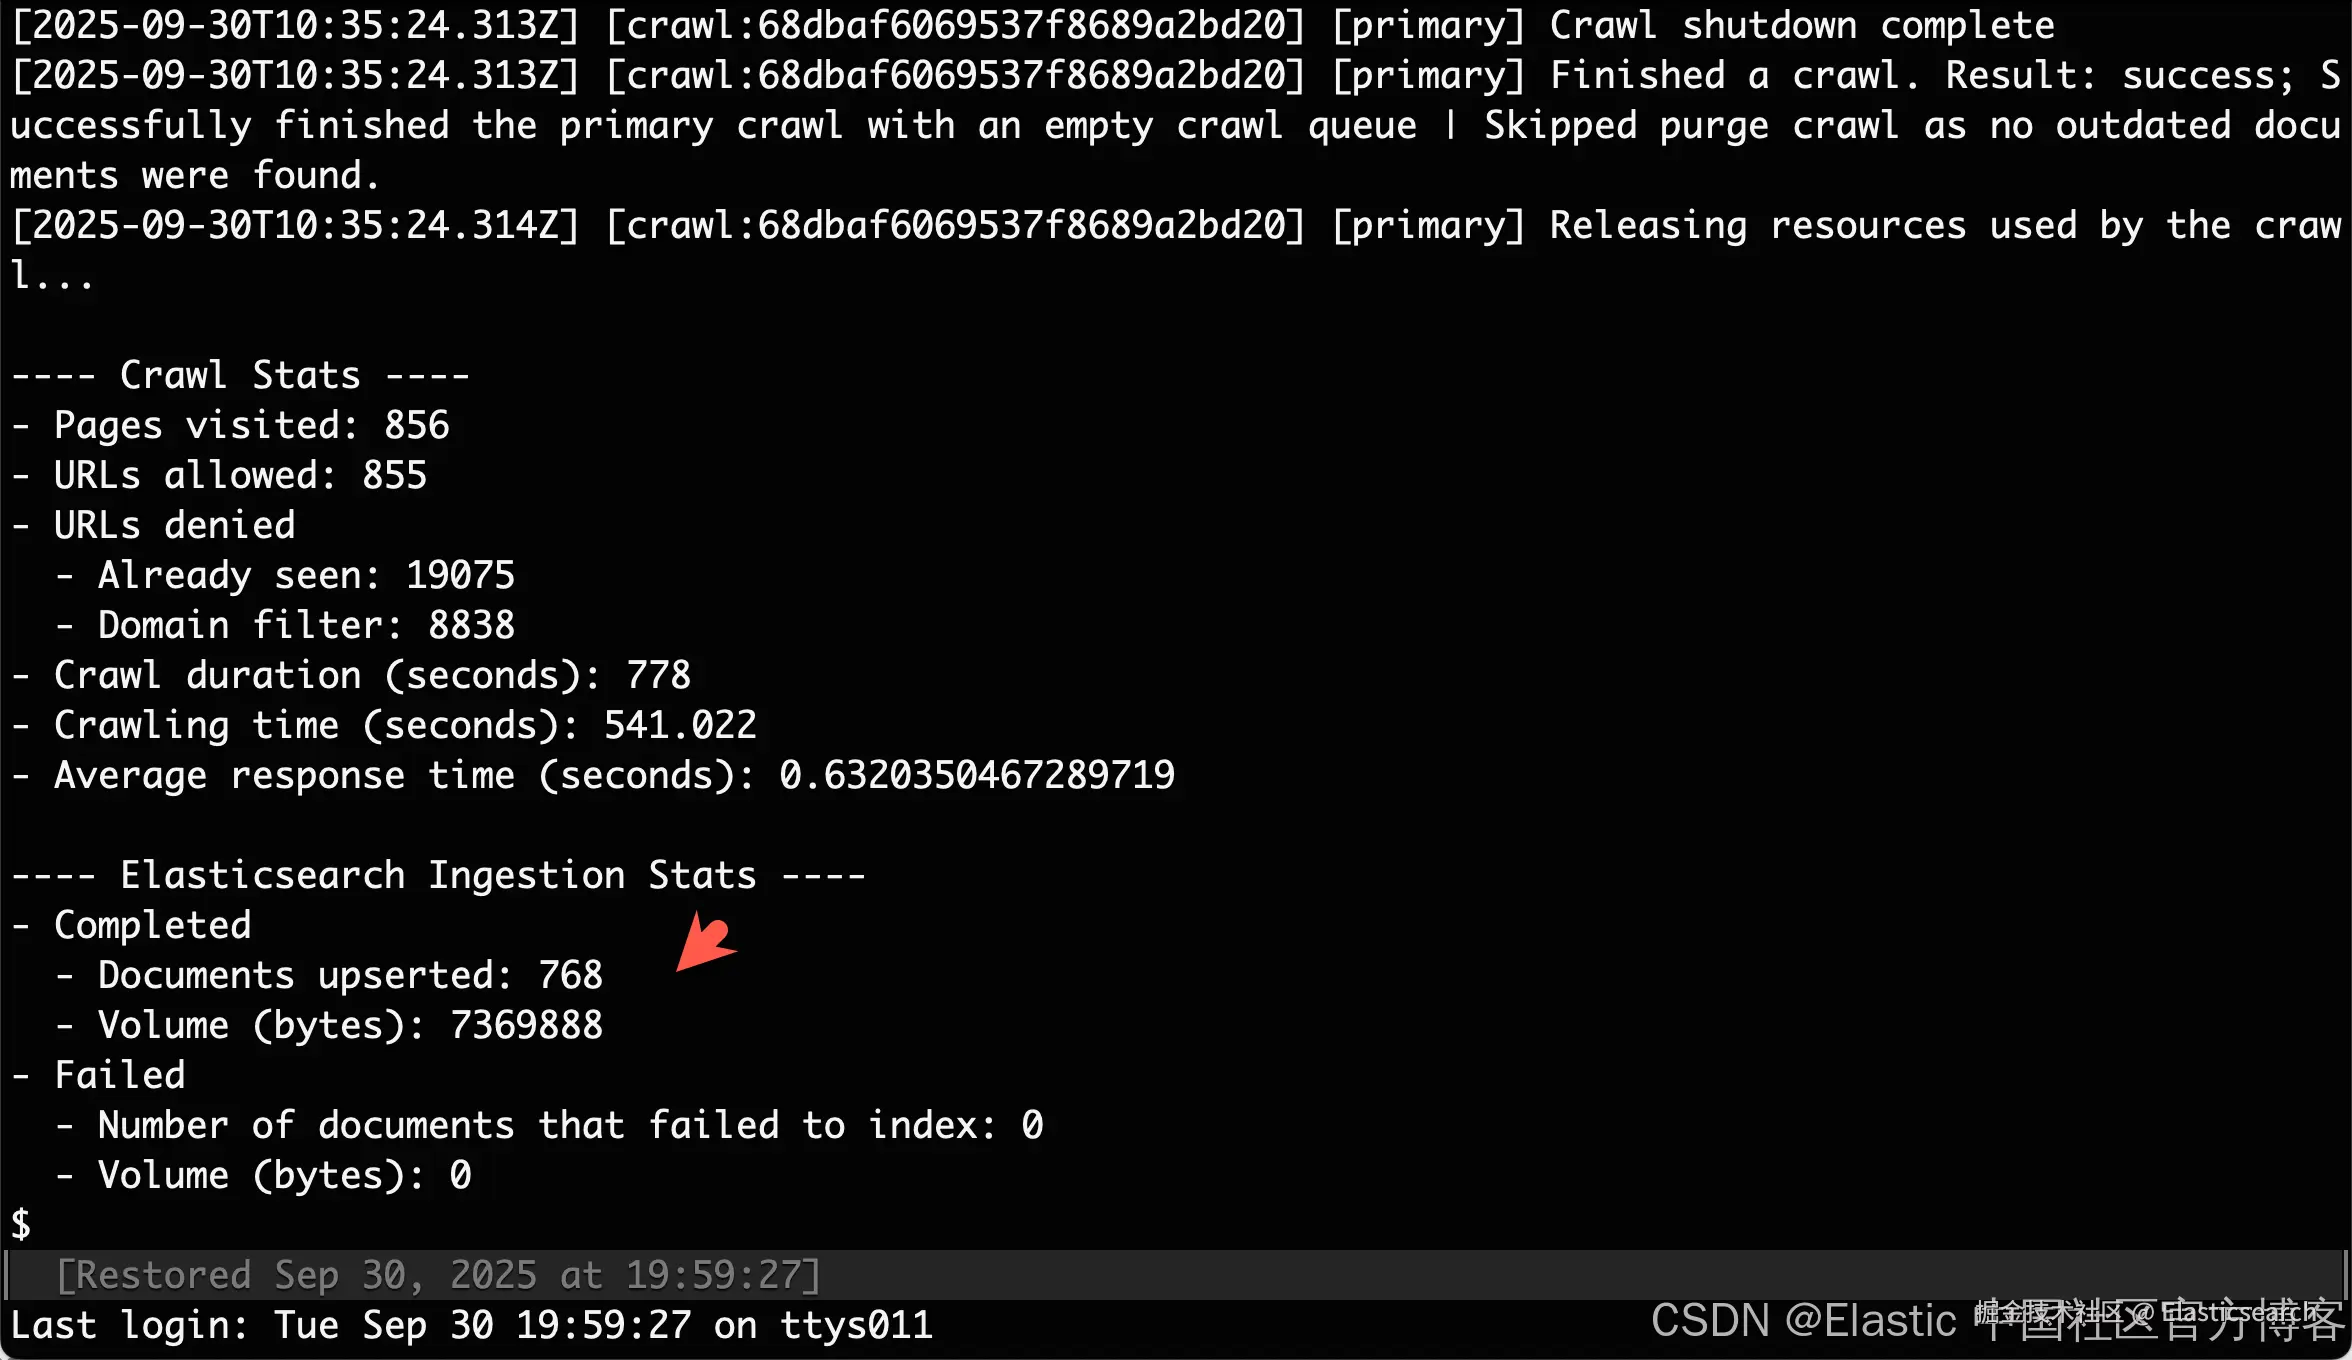
一旦爬虫配置完成,运行单次爬取只需:
我们接下来启动 docker,并运行如下的命令:
bash
`

1.  docker run --rm \
2.    --entrypoint /bin/bash \
3.    -v "$(pwd)/crawler-config:/app/config" \
4.    --network host \
5.    docker.elastic.co/integrations/crawler:latest \
6.    -c "bin/crawler crawl /app/config/elastic-search-labs-crawler.yml"

`AI写代码
ini
`
1. $ docker run --rm \
2. > --entrypoint /bin/bash \
3. > -v "$(pwd)/crawler-config:/app/config" \
4. > --network host \
5. > docker.elastic.co/integrations/crawler:latest \
6. > -c "bin/crawler crawl /app/config/elastic-search-labs-crawler.yml"
7. [2025-09-30T10:22:25.034Z] [crawl:68dbaf6069537f8689a2bd20] [primary] Initialized an in-memory URL queue for up to 10000 URLs
8. [2025-09-30T10:22:25.038Z] [crawl:68dbaf6069537f8689a2bd20] [primary] ES connections will be authorized with configured API key
9. [2025-09-30T10:22:25.544Z] [crawl:68dbaf6069537f8689a2bd20] [primary] Connected to ES at https://192.168.101.192:9200 - version: 9.1.4; build flavor: default
10. [2025-09-30T10:22:25.583Z] [crawl:68dbaf6069537f8689a2bd20] [primary] Index [search-labs-posts] was found!
11. [2025-09-30T10:22:25.583Z] [crawl:68dbaf6069537f8689a2bd20] [primary] Elasticsearch sink initialized for index [search-labs-posts] with pipeline [search-default-ingestion]
12. [2025-09-30T10:22:25.590Z] [crawl:68dbaf6069537f8689a2bd20] [primary] Starting the primary crawl with up to 10 parallel thread(s)...
13. [2025-09-30T10:22:26.903Z] [crawl:68dbaf6069537f8689a2bd20] [primary] Crawl status: queue_size=14, pages_visited=1, urls_allowed=15, urls_denied={}, crawl_duration_msec=1314, crawling_time_msec=1194.0, avg_response_time_msec=1194.0, active_threads=1, http_client={:max_connections=>100, :used_connections=>1}, status_codes={"200"=>1}
14. [2025-09-30T10:22:34.467Z] [crawl:68dbaf6069537f8689a2bd20] [primary] Sending bulk request with 10 items and resetting queue...
15. [2025-09-30T10:22:36.935Z] [crawl:68dbaf6069537f8689a2bd20] [primary] Crawl status: queue_size=706, pages_
`AI写代码我们可以在 Kibana 中查看被爬进的文档:
sql
`GET search-labs-posts/_search`AI写代码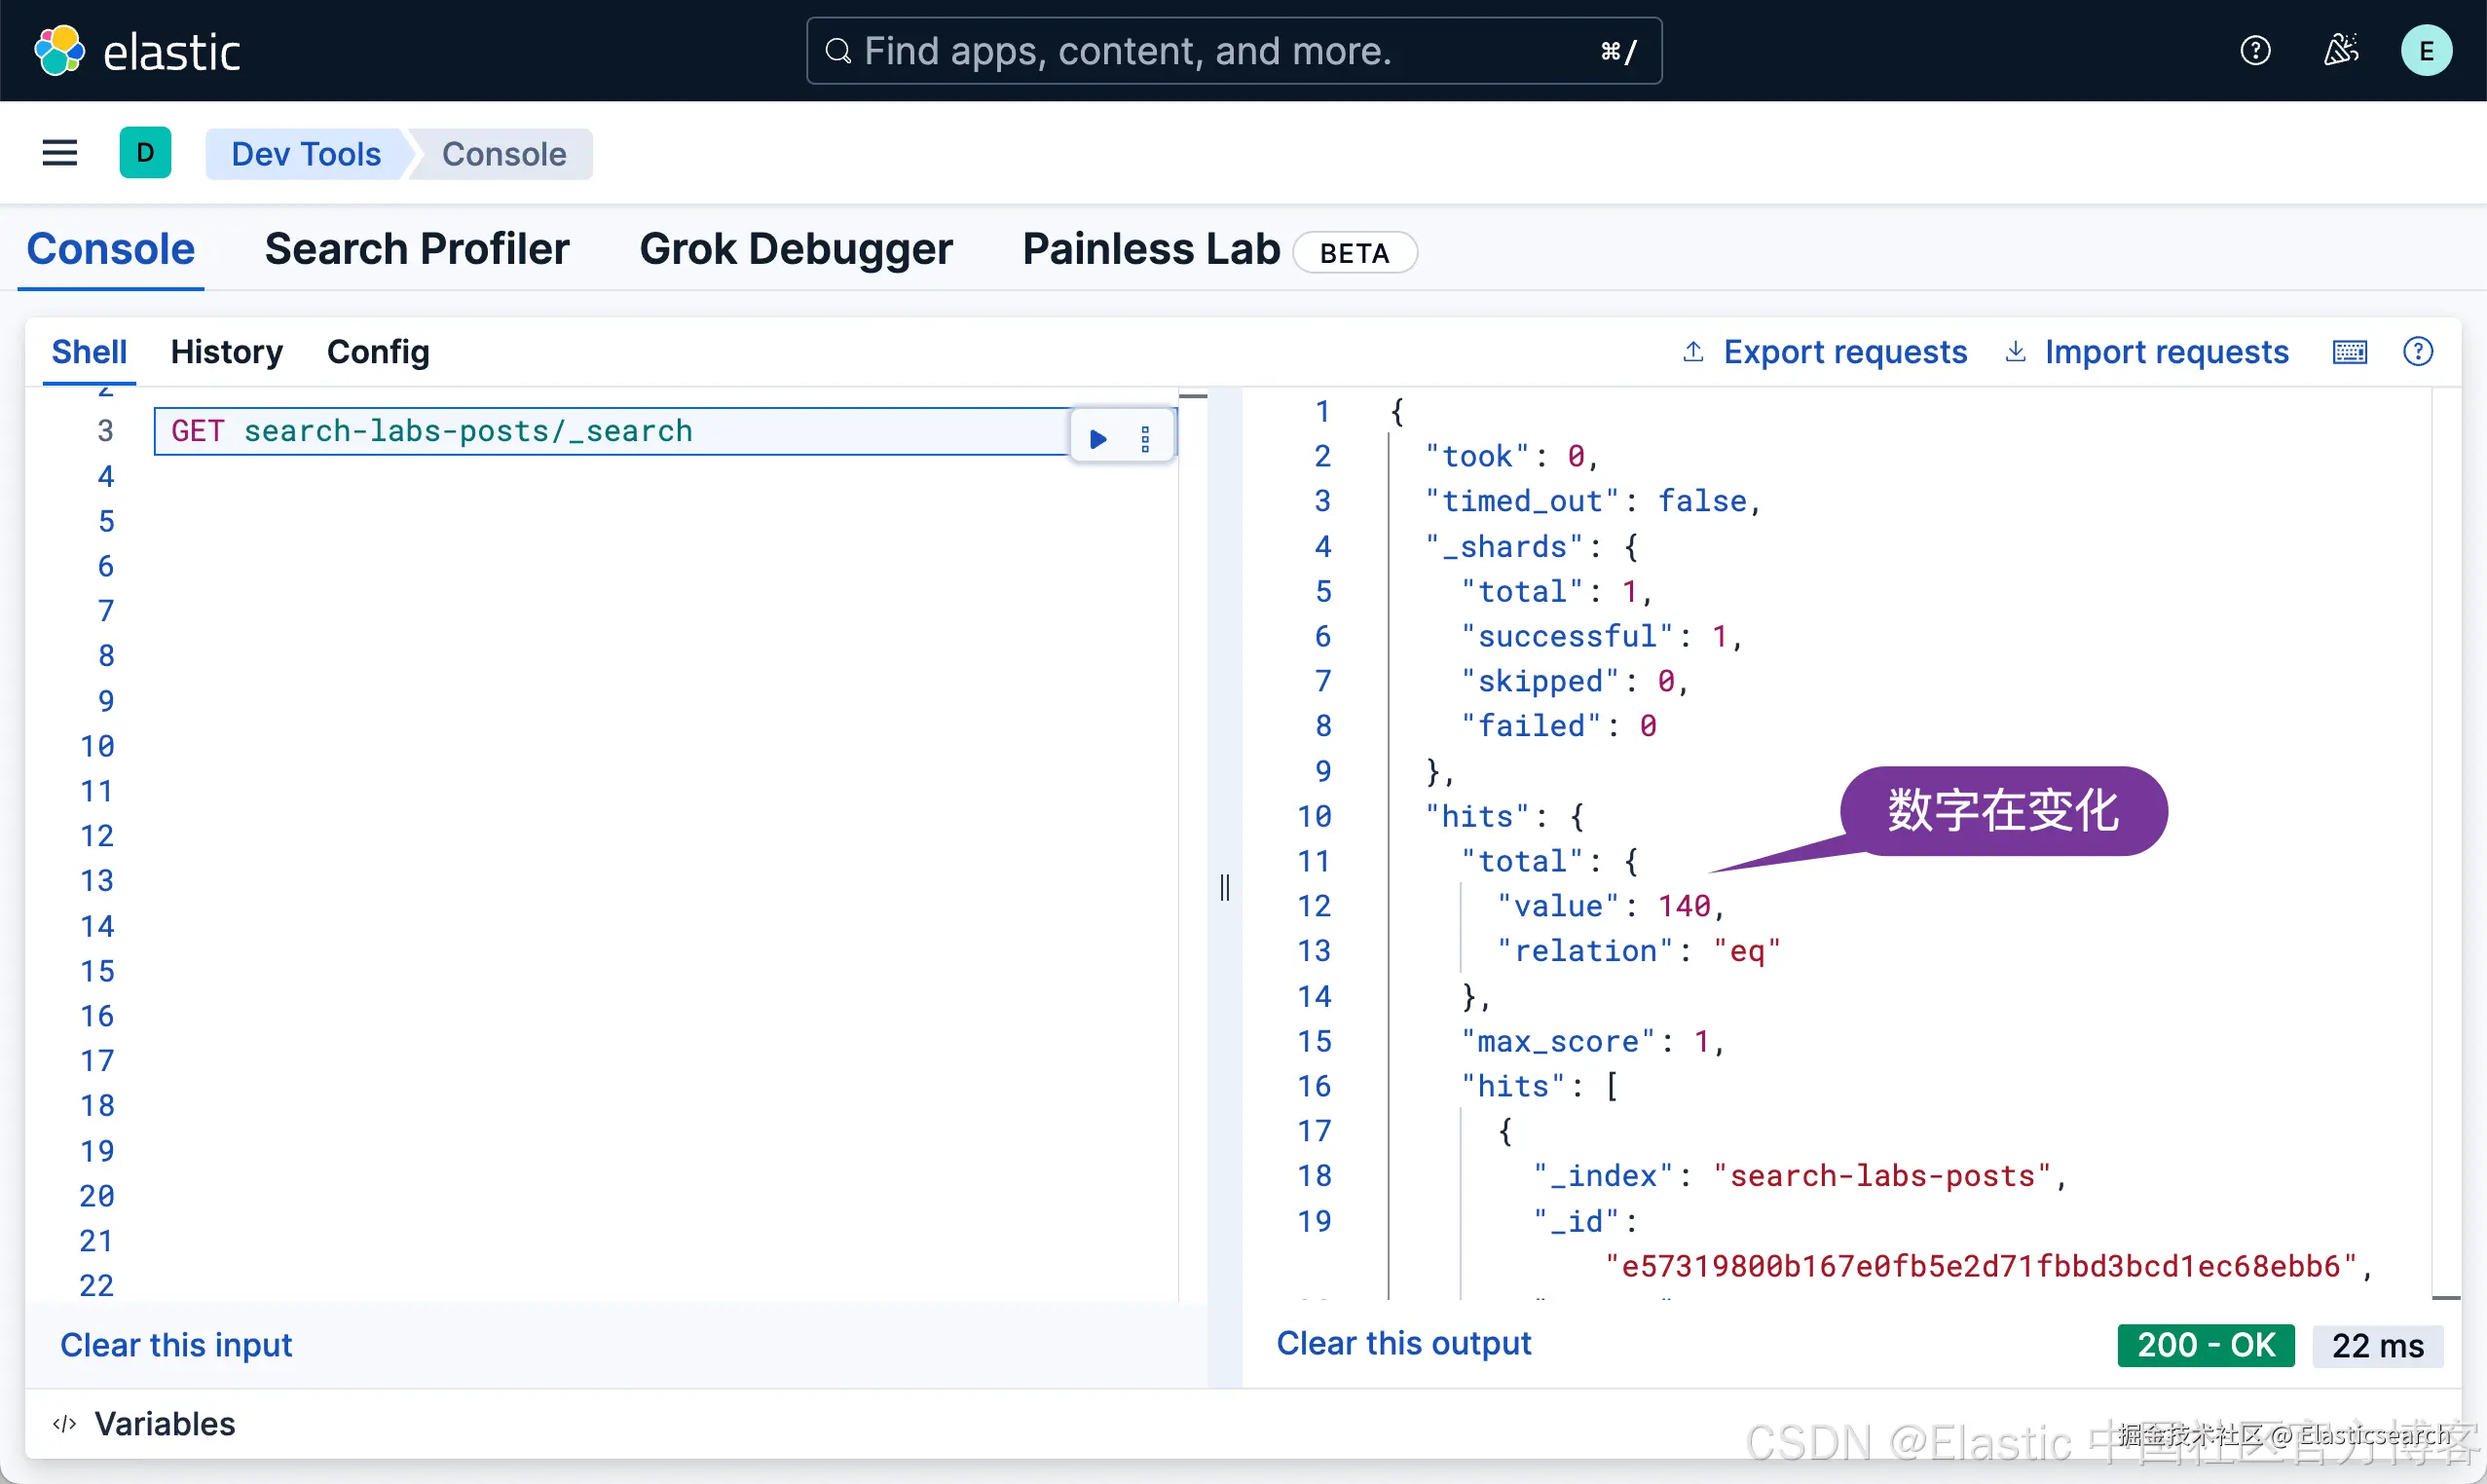
我们需要等待一定的时间来完成所有的文档写入。
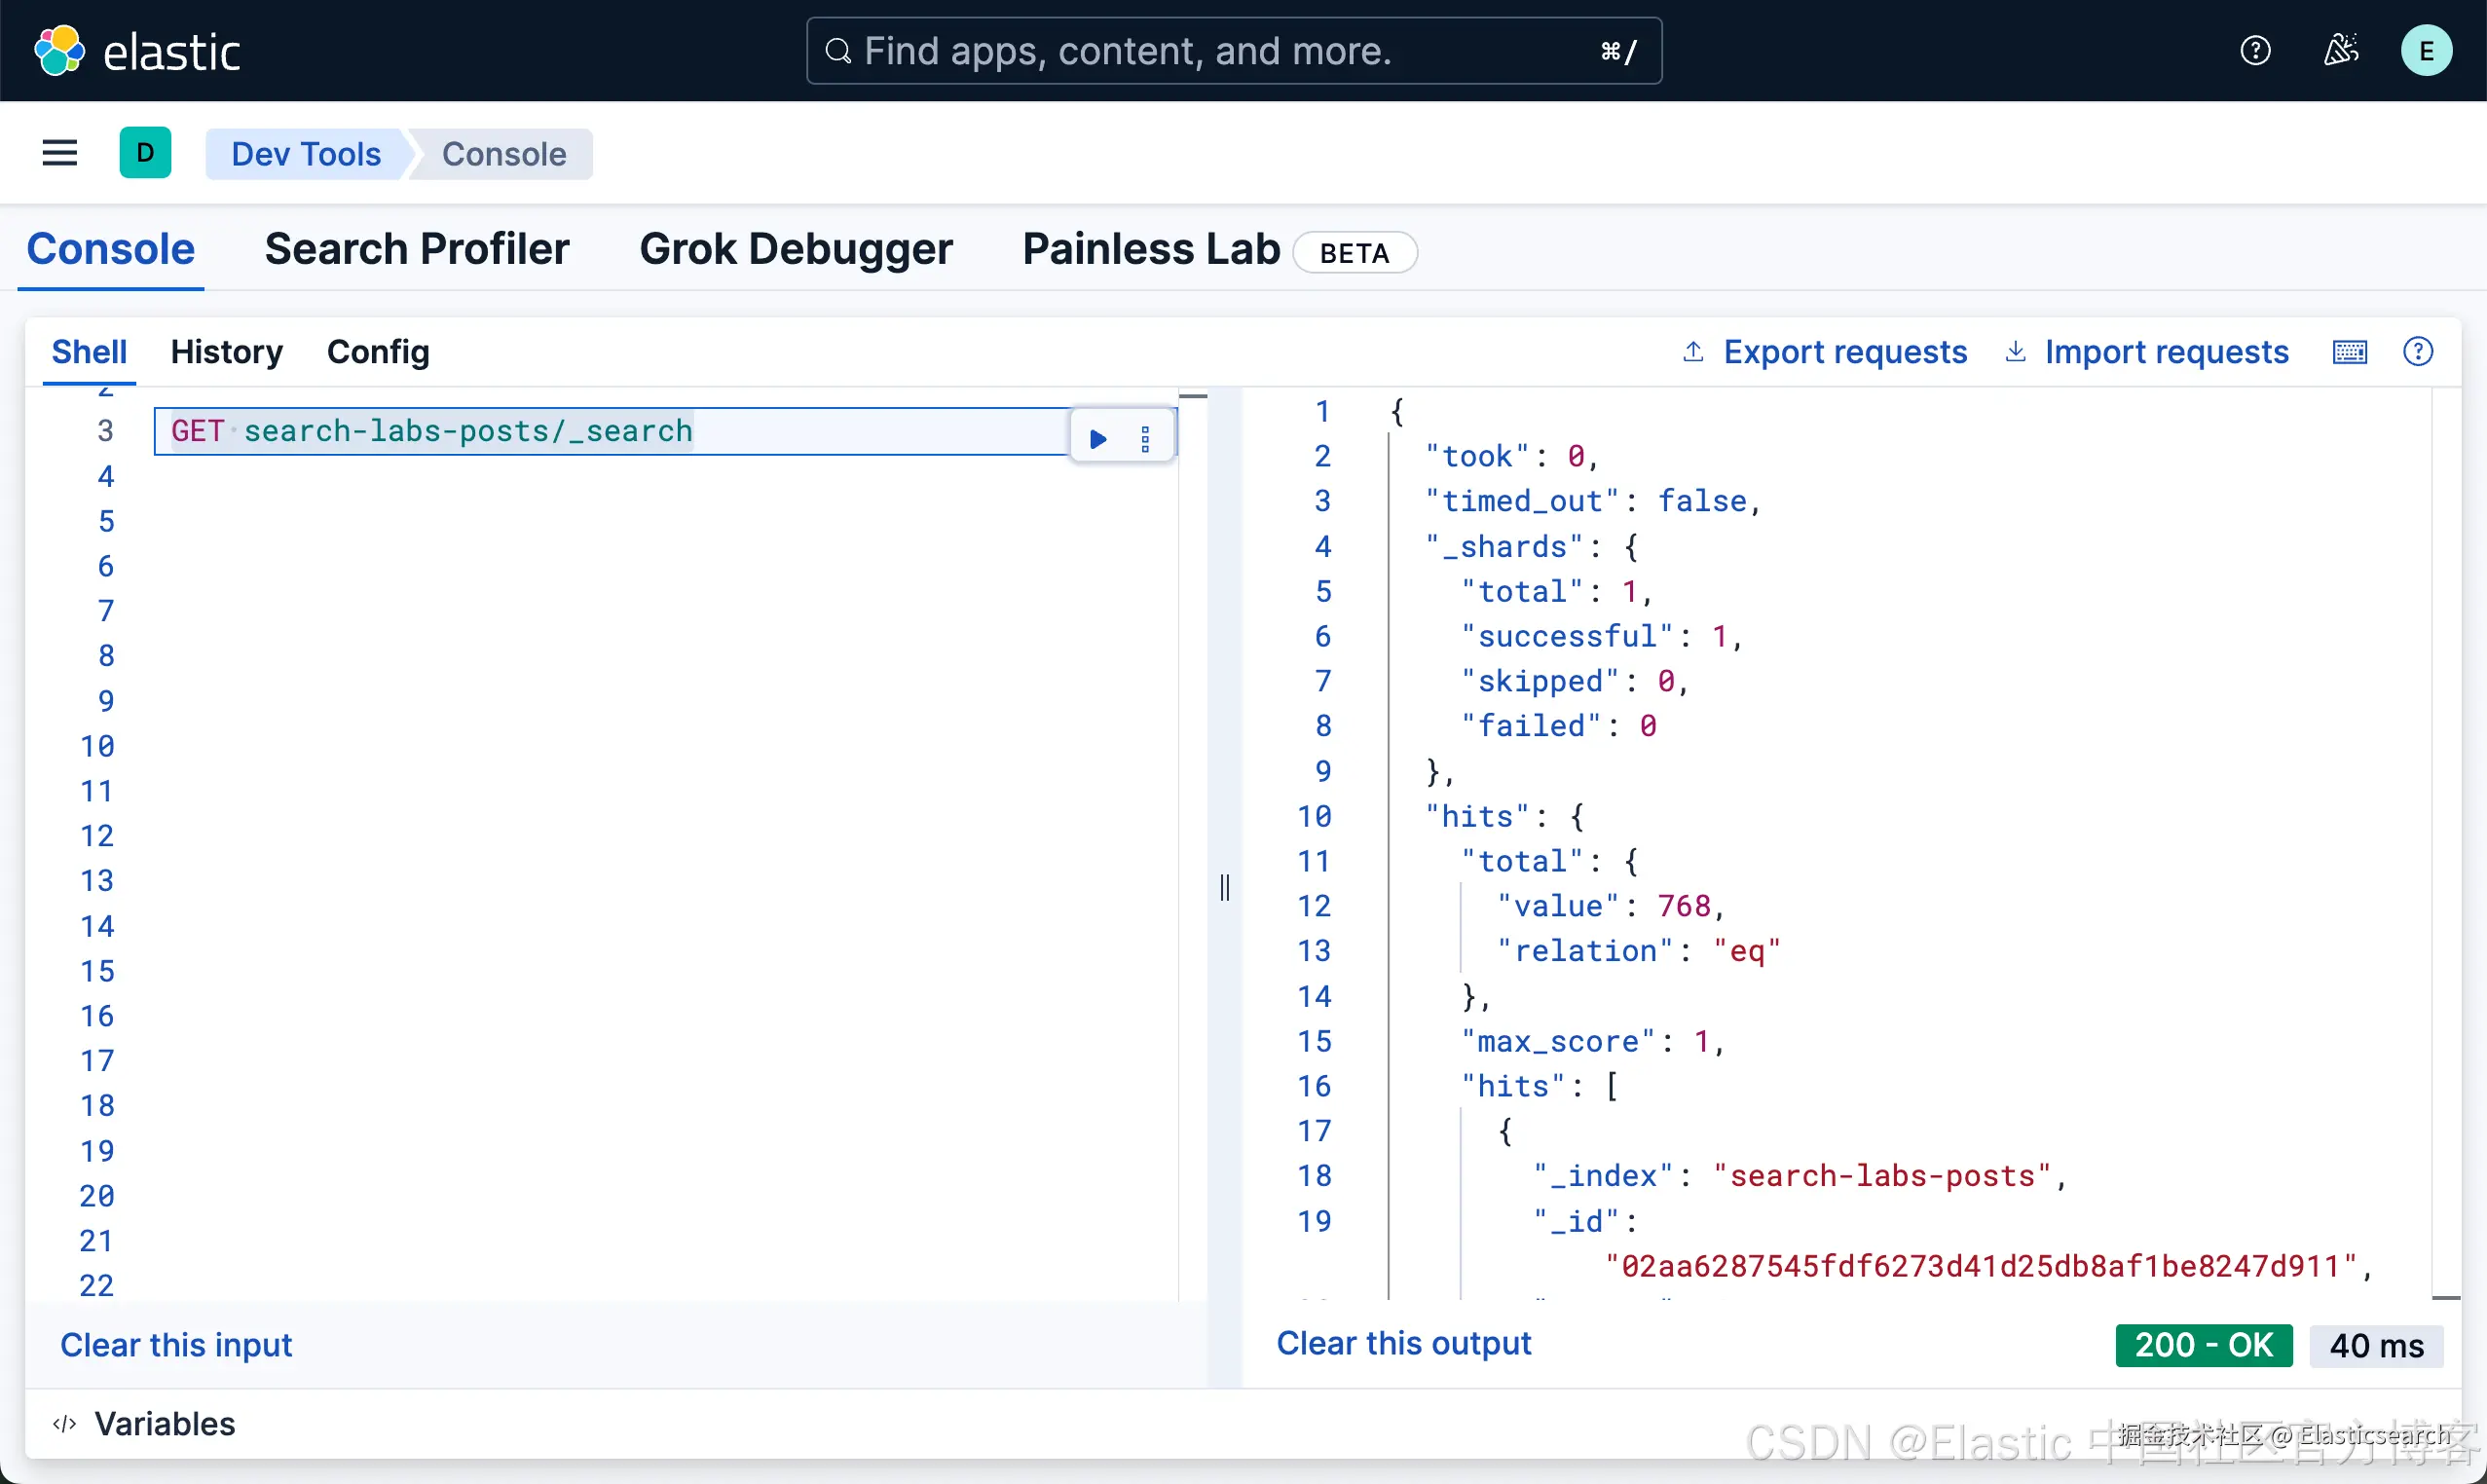
我们可以看到有 768 篇文章被写入。
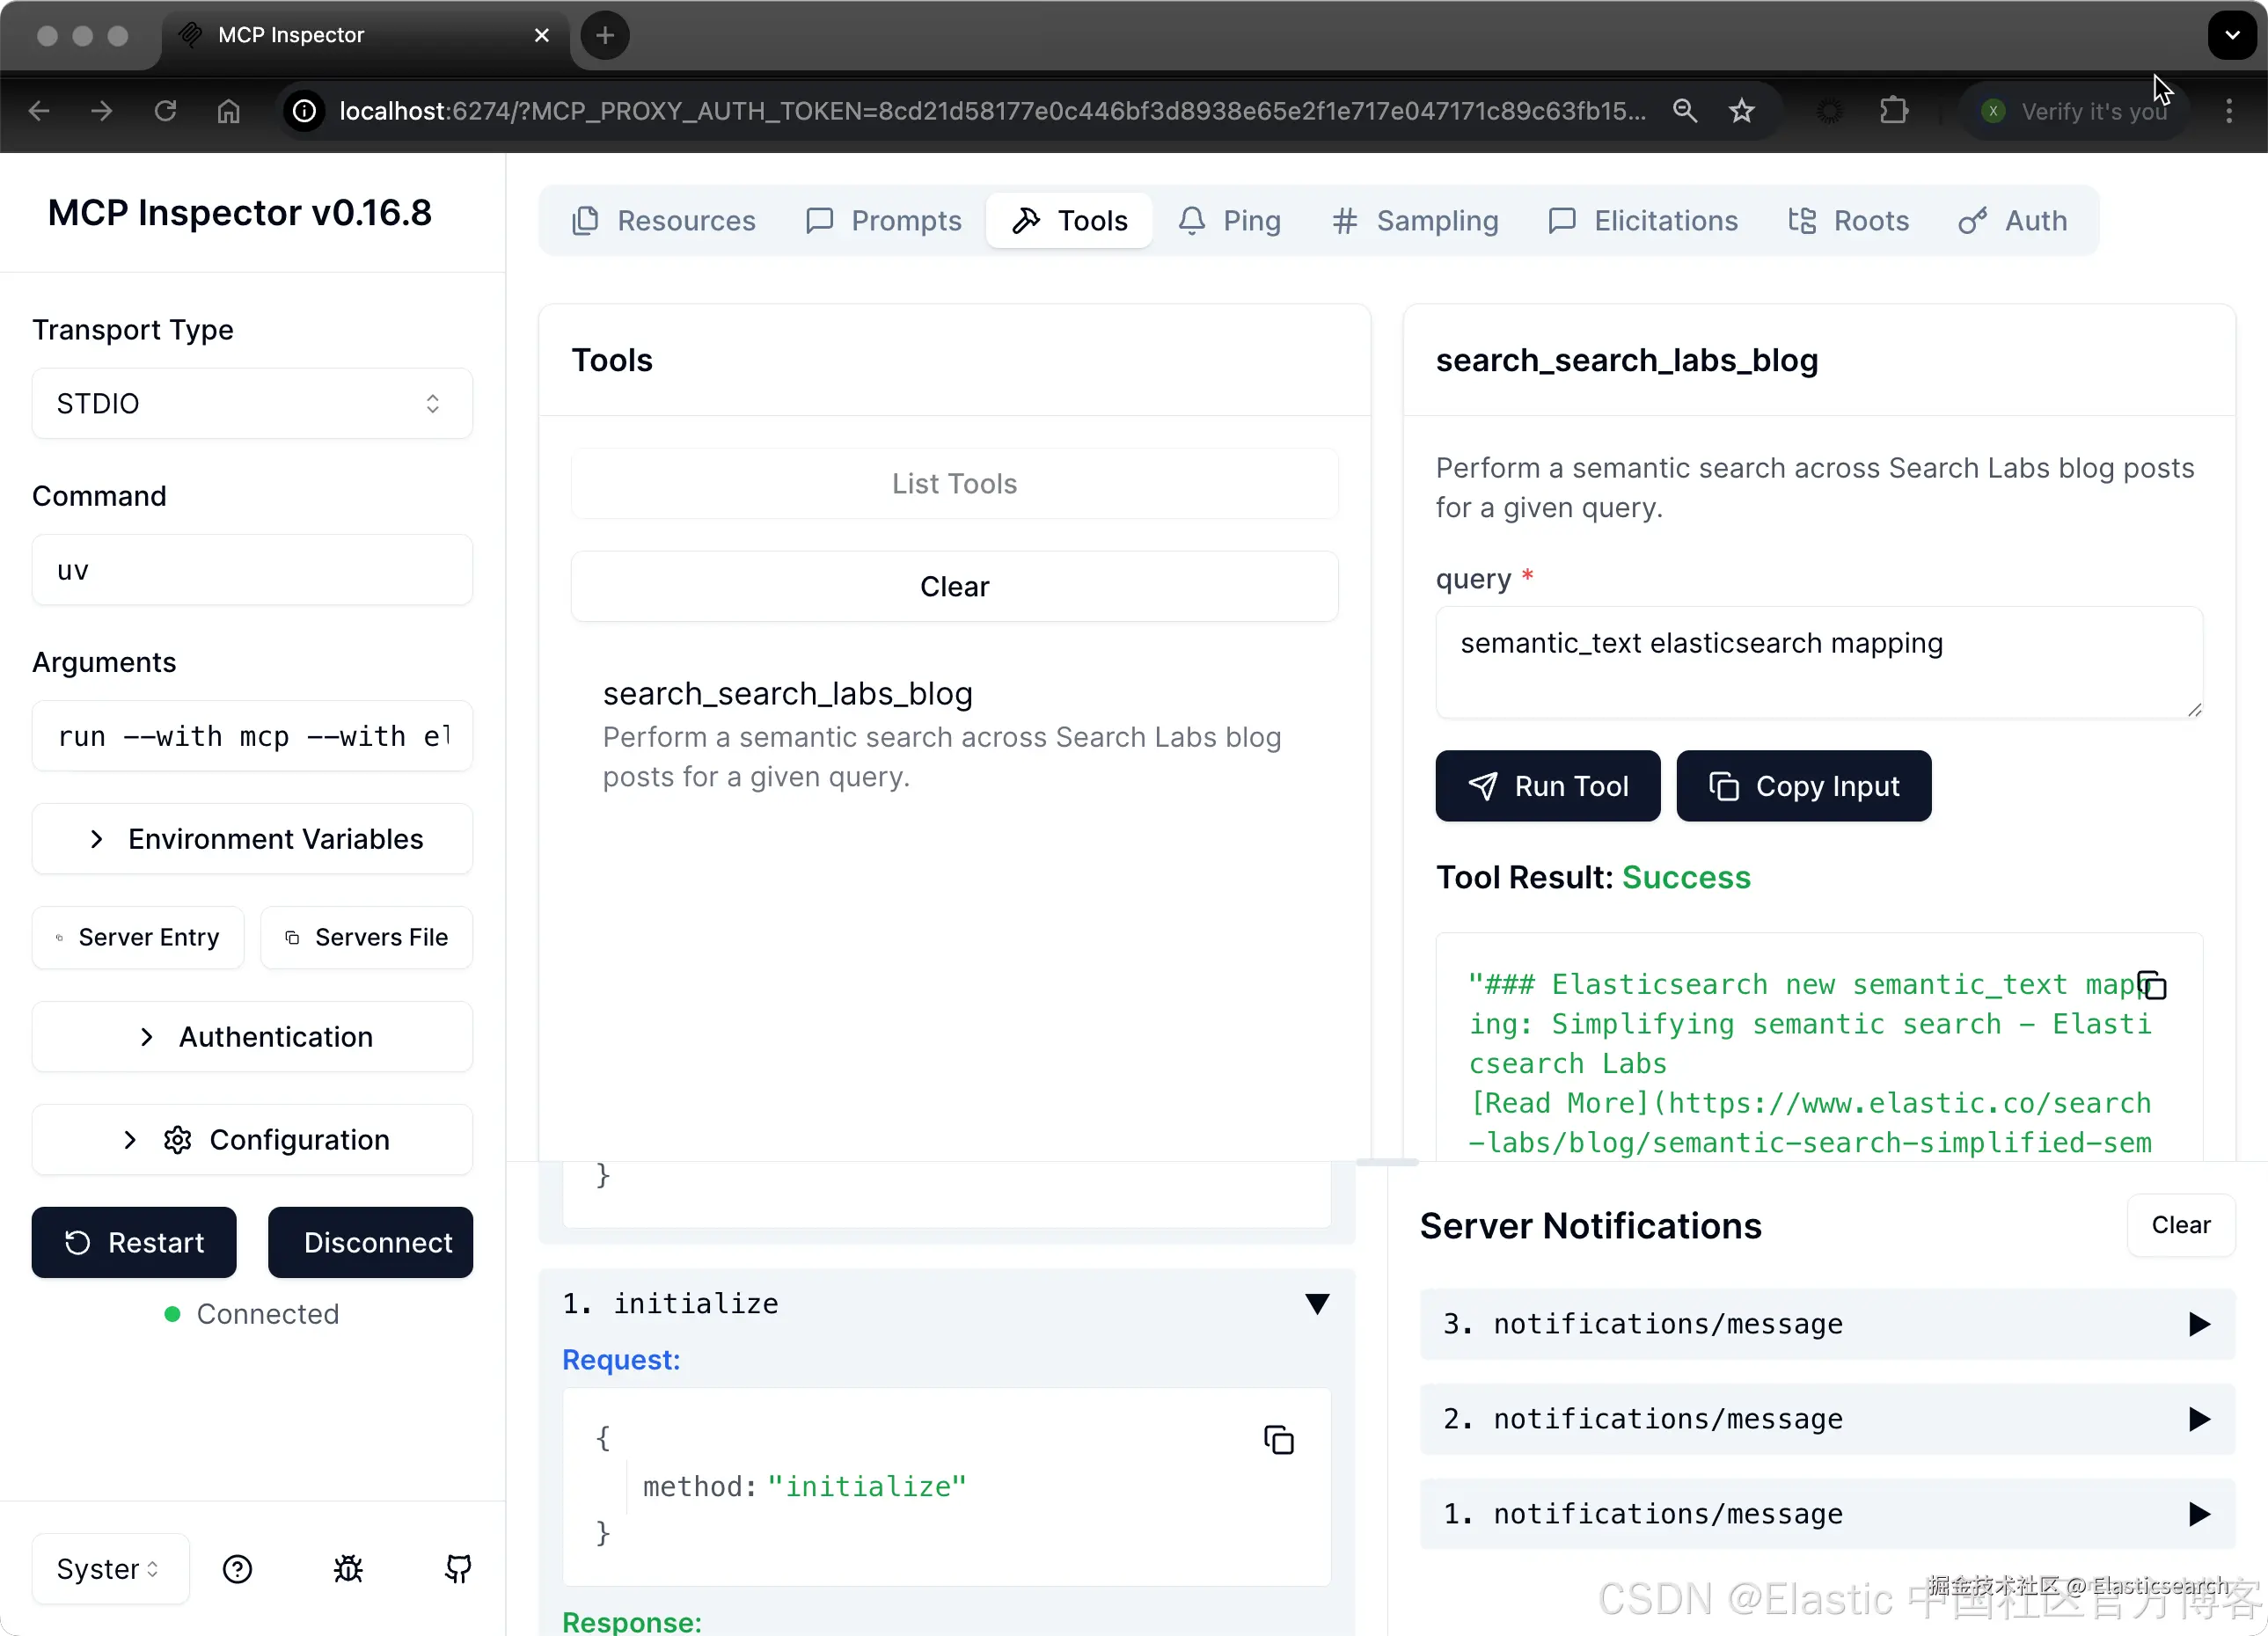
MCP Server 工具用于搜索相关博客文章
一旦你在 .env 文件中填入 ES_URL 和 API_KEY,就可以通过 MCP Inspector 工具开始与我们的 MCP server 交互。
开发非常直接,多亏了 MCP Python SDK。这里是我们所需的全部内容,不到 50 行代码!
python
`
1. import os
2. import sys
3. from dotenv import load_dotenv
4. from elasticsearch import Elasticsearch
5. from mcp.server.fastmcp import FastMCP
7. # Load environment variables
8. load_dotenv()
9. print("Beginning", file=sys.stderr)
11. ELASTCSEARCH_CERT_PATH = "/Users/liuxg/python/elastic-semantic-search-mcp-server/crawler-config/http_ca.crt"
12. ES_URL = os.getenv("ES_URL")
13. API_KEY = os.getenv("API_KEY")
15. # We can use the following method to output some logs to help debug
16. print(ES_URL, file=sys.stderr)
17. print(API_KEY, file=sys.stderr)
18. # ES_URL = "https://192.168.101.192:9200"
19. # API_KEY = "bzhZRW1wa0I5NnpZa1ZqRGhRYl86akdfMExCSkZzUUh2QVRsd2UtQ2tHUQ=="
21. # Setup Elasticsearch client
22. es_client = Elasticsearch(ES_URL, api_key= API_KEY,
23. ca_certs = ELASTCSEARCH_CERT_PATH, verify_certs = True)
24. print(es_client.info())
26. mcp = FastMCP("Search Labs Blog Search MCP", dependencies=["elasticsearch"])
29. # Elasticsearch search function
30. def search_search_labs(query: str) -> list[dict]:
31. """Perform semantic search on Search Labs blog posts."""
32. try:
33. results = es_client.search(
34. index="search-labs-posts",
35. body={
36. "query": {
37. "semantic": {"query": query, "field": "semantic_body"},
38. },
39. "_source": [
40. "title",
41. "url",
42. "semantic_body.inference.chunks.text",
43. ],
44. "size": 5,
45. },
46. )
47. return [
48. {
49. "title": hit["_source"].get("title", ""),
50. "url": hit["_source"].get("url", ""),
51. "content": [
52. chunk.get("text", "")
53. for chunk in hit["_source"]
54. .get("semantic_body", {})
55. .get("inference", {})
56. .get("chunks", [])[:3]
57. ],
58. }
59. for hit in results.get("hits", {}).get("hits", [])
60. ]
61. except Exception as e:
62. return [{"error": f"Search failed: {str(e)}"}]
65. # MCP tool for documentation search
66. @mcp.tool(
67. ,
68. description="Perform a semantic search across Search Labs blog posts for a given query.",
69. )
70. def search_search_labs_blog(query: str) -> str:
71. """Returns formatted search results from Search Labs blog posts."""
72. results = search_search_labs(query)
73. return (
74. "\n\n".join(
75. [
76. f"### {hit['title']}\n[Read More]({hit['url']})\n- {hit['content']}"
77. for hit in results
78. ]
79. )
80. if results
81. else "No results found."
82. )
85. # Start MCP server
86. if __name__ == "__main__":
87. print(f"MCP server '{mcp.name}' is running...")
88. mcp.run()
`AI写代码要运行开发版 inspector,只需调用:
go
`make dev`AI写代码
bash
``
1. $ pwd
2. /Users/liuxg/python/elastic-semantic-search-mcp-server
3. $ ls
4. Makefile __pycache__ node_modules package.json server.py
5. README.md crawler-config package-lock.json pyproject.toml uv.lock
6. $ sudo npm install @modelcontextprotocol/inspector@0.16.8
8. up to date, audited 232 packages in 2s
10. 40 packages are looking for funding
11. run `npm fund` for details
13. found 0 vulnerabilities
14. $ make dev
15. uv run mcp dev server.py
16. https://192.168.101.192:9200 bzhZRW1wa0I5NnpZa1ZqRGhRYl86akdfMExCSkZzUUh2QVRsd2UtQ2tHUQ==
17. {'name': 'liuxgn.local', 'cluster_name': 'elasticsearch', 'cluster_uuid': 'i0uJkyoLRT-M01FTEeGwMg', 'version': {'number': '9.1.4', 'build_flavor': 'default', 'build_type': 'tar', 'build_hash': '0b7fe68d2e369469ff9e9f344ab6df64ab9c5293', 'build_date': '2025-09-16T22:05:19.073893347Z', 'build_snapshot': False, 'lucene_version': '10.2.2', 'minimum_wire_compatibility_version': '8.19.0', 'minimum_index_compatibility_version': '8.0.0'}, 'tagline': 'You Know, for Search'}
18. Starting MCP inspector...
19. ⚙️ Proxy server listening on localhost:6277
20. 🔑 Session token: 8cd21d58177e0c446bf3d8938e65e2f1e717e047171c89c63fb155dae7c1011e
21. Use this token to authenticate requests or set DANGEROUSLY_OMIT_AUTH=true to disable auth
23. 🚀 MCP Inspector is up and running at:
24. http://localhost:6274/?MCP_PROXY_AUTH_TOKEN=8cd21d58177e0c446bf3d8938e65e2f1e717e047171c89c63fb155dae7c1011e
26. 🌐 Opening browser...
``AI写代码它会在 http://localhost:5173 打开 inspector,你可以通过 UI 中的协议与 MCP server 交互。
Claude Desktop 应用端到端演示
Claude Desktop App 实现了 MCP Client 接口。你可以通过运行以下命令将我们的 MCP server 添加到本地 Claude Desktop:
arduino
`
1. $ pwd
2. /Users/liuxg/python/elastic-semantic-search-mcp-server
3. $ ls
4. Makefile __pycache__ node_modules package.json server.py
5. README.md crawler-config package-lock.json pyproject.toml uv.lock
6. $ make install-claude-config
7. uv run mcp install server.py --with elasticsearch
8. https://192.168.101.192:9200 bzhZRW1wa0I5NnpZa1ZqRGhRYl86akdfMExCSkZzUUh2QVRsd2UtQ2tHUQ==
9. {'name': 'liuxgn.local', 'cluster_name': 'elasticsearch', 'cluster_uuid': 'i0uJkyoLRT-M01FTEeGwMg', 'version': {'number': '9.1.4', 'build_flavor': 'default', 'build_type': 'tar', 'build_hash': '0b7fe68d2e369469ff9e9f344ab6df64ab9c5293', 'build_date': '2025-09-16T22:05:19.073893347Z', 'build_snapshot': False, 'lucene_version': '10.2.2', 'minimum_wire_compatibility_version': '8.19.0', 'minimum_index_compatibility_version': '8.0.0'}, 'tagline': 'You Know, for Search'}
10. [10/01/25 12:22:48] INFO Added server 'Search Labs Blog Search MCP' to Claude config claude.py:126
11. INFO Successfully installed Search Labs Blog Search MCP in Claude app cli.py:468
`AI写代码这会更新你主目录下的 claude_desktop_config.json。在下一次重启时,Claude 应用会检测到该 server 并加载声明的工具。我们可以在 Claude Desktop 的设置中进行查看:
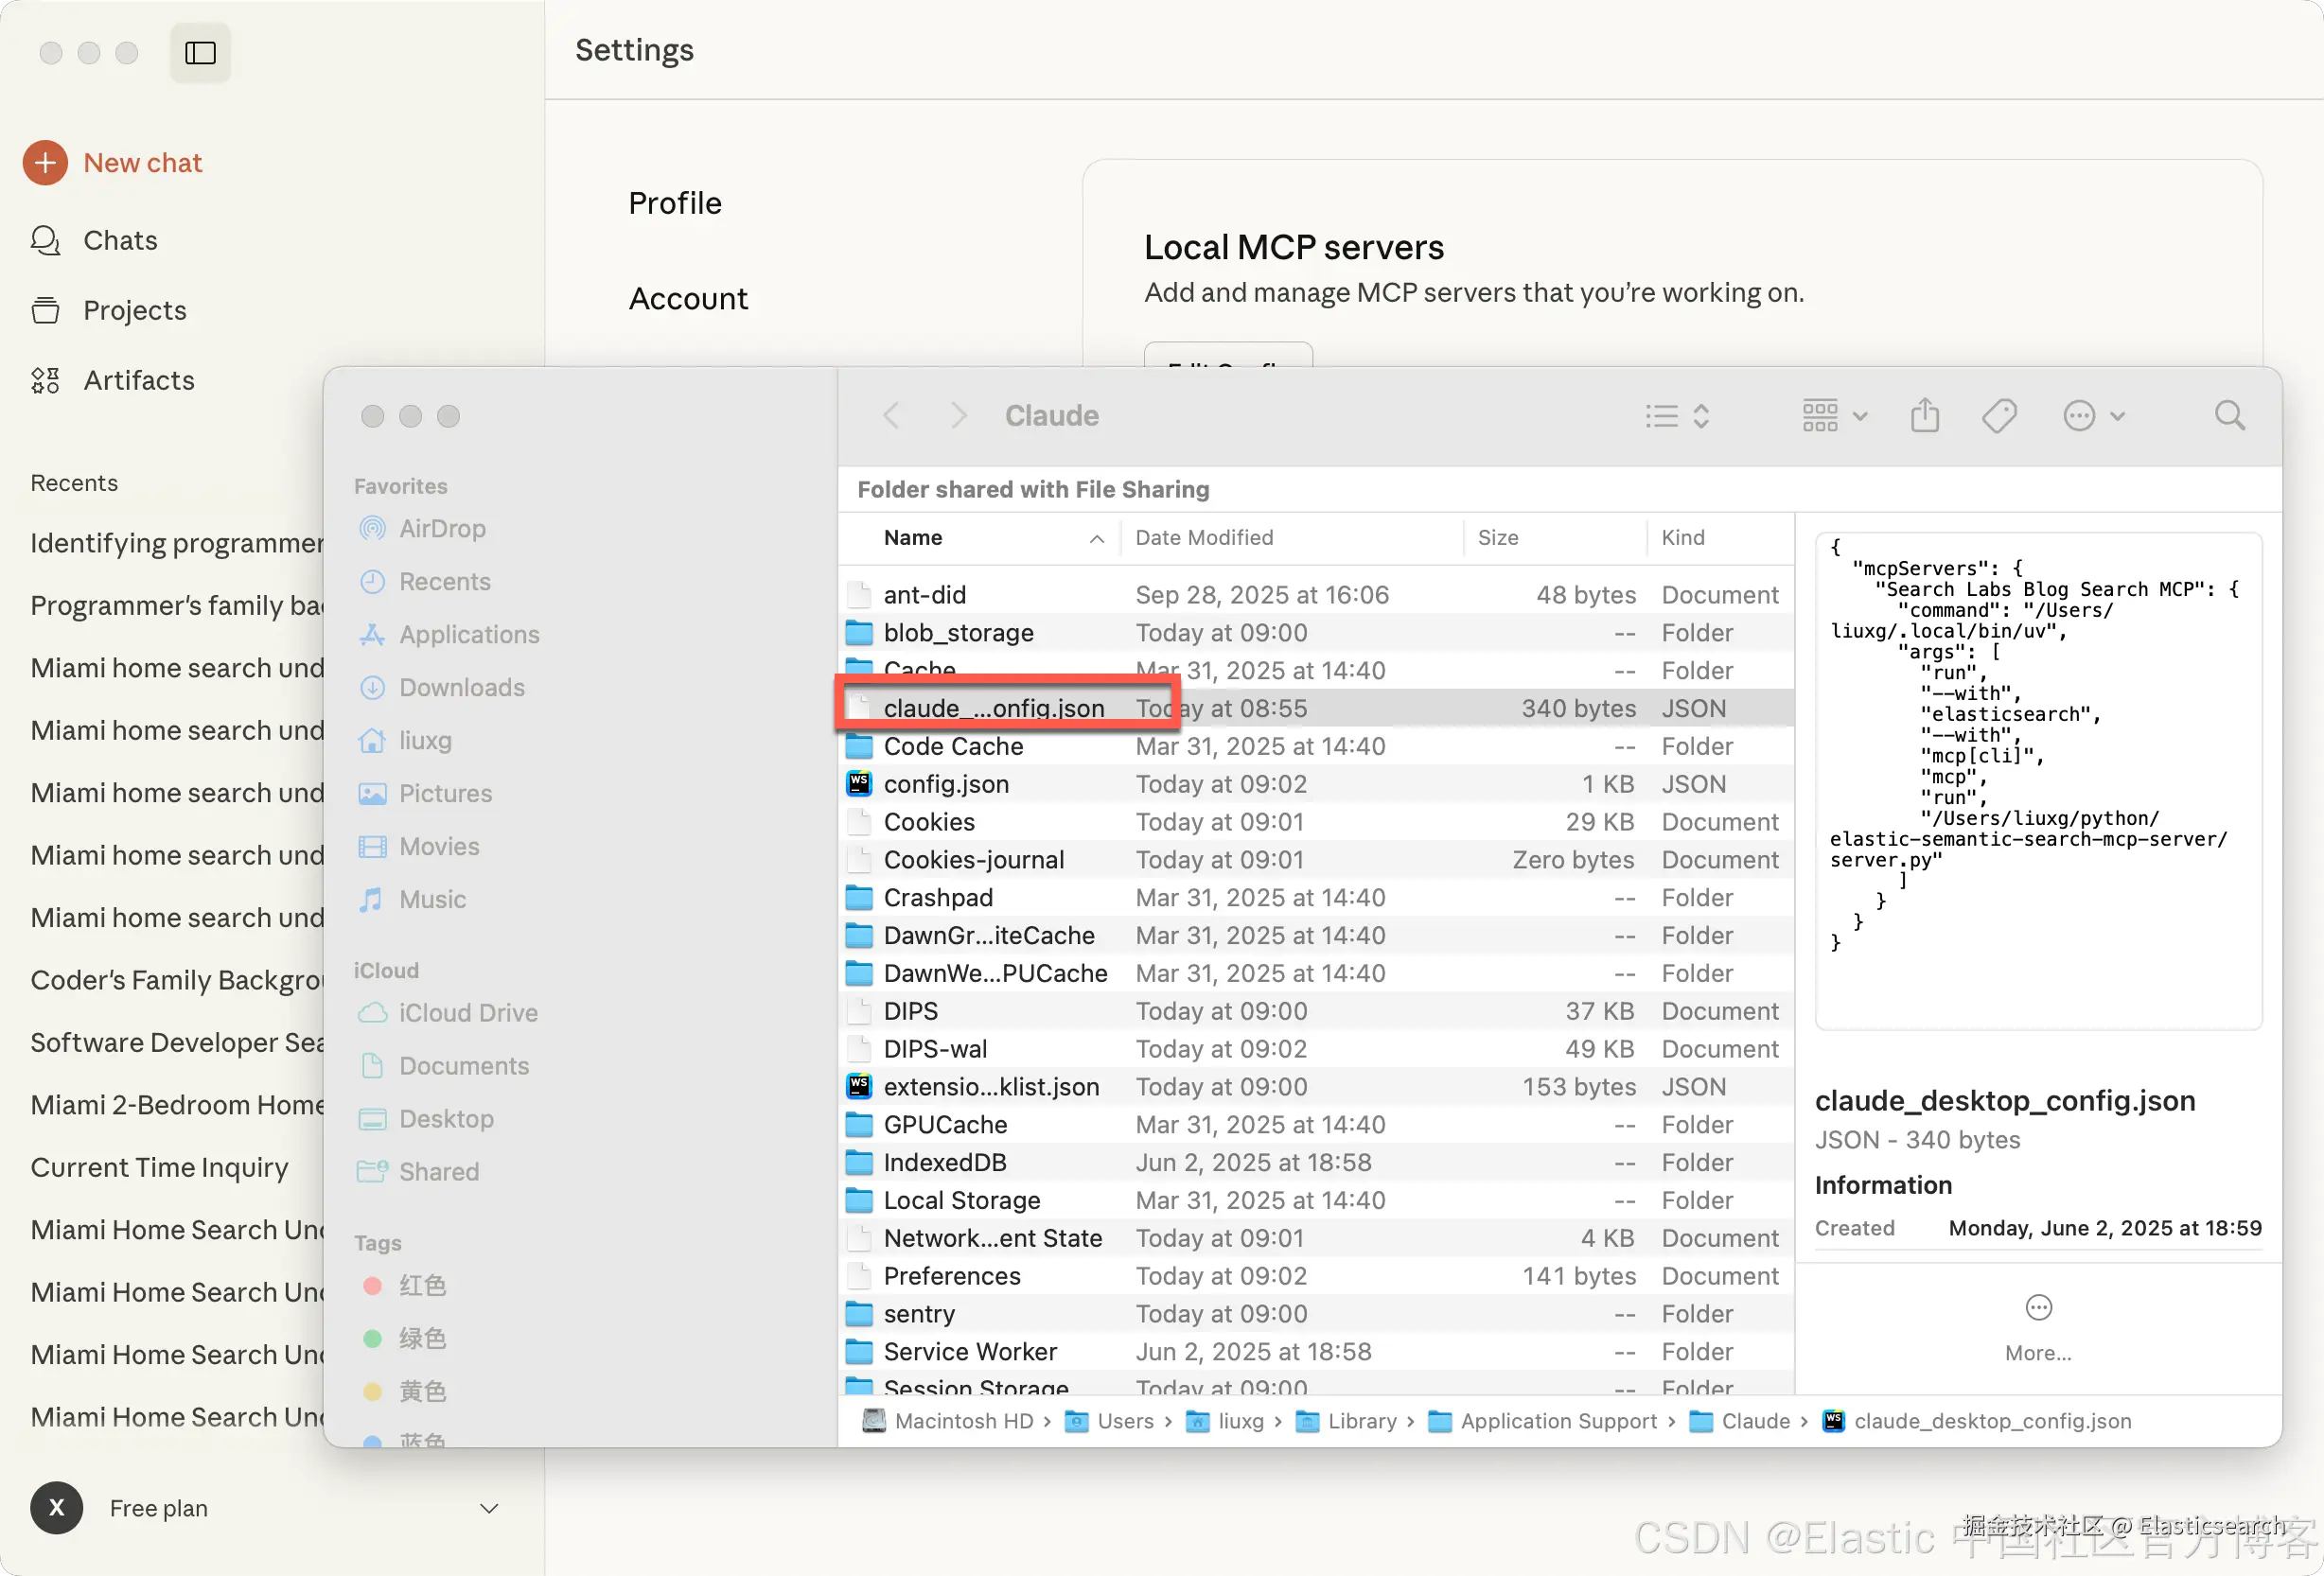
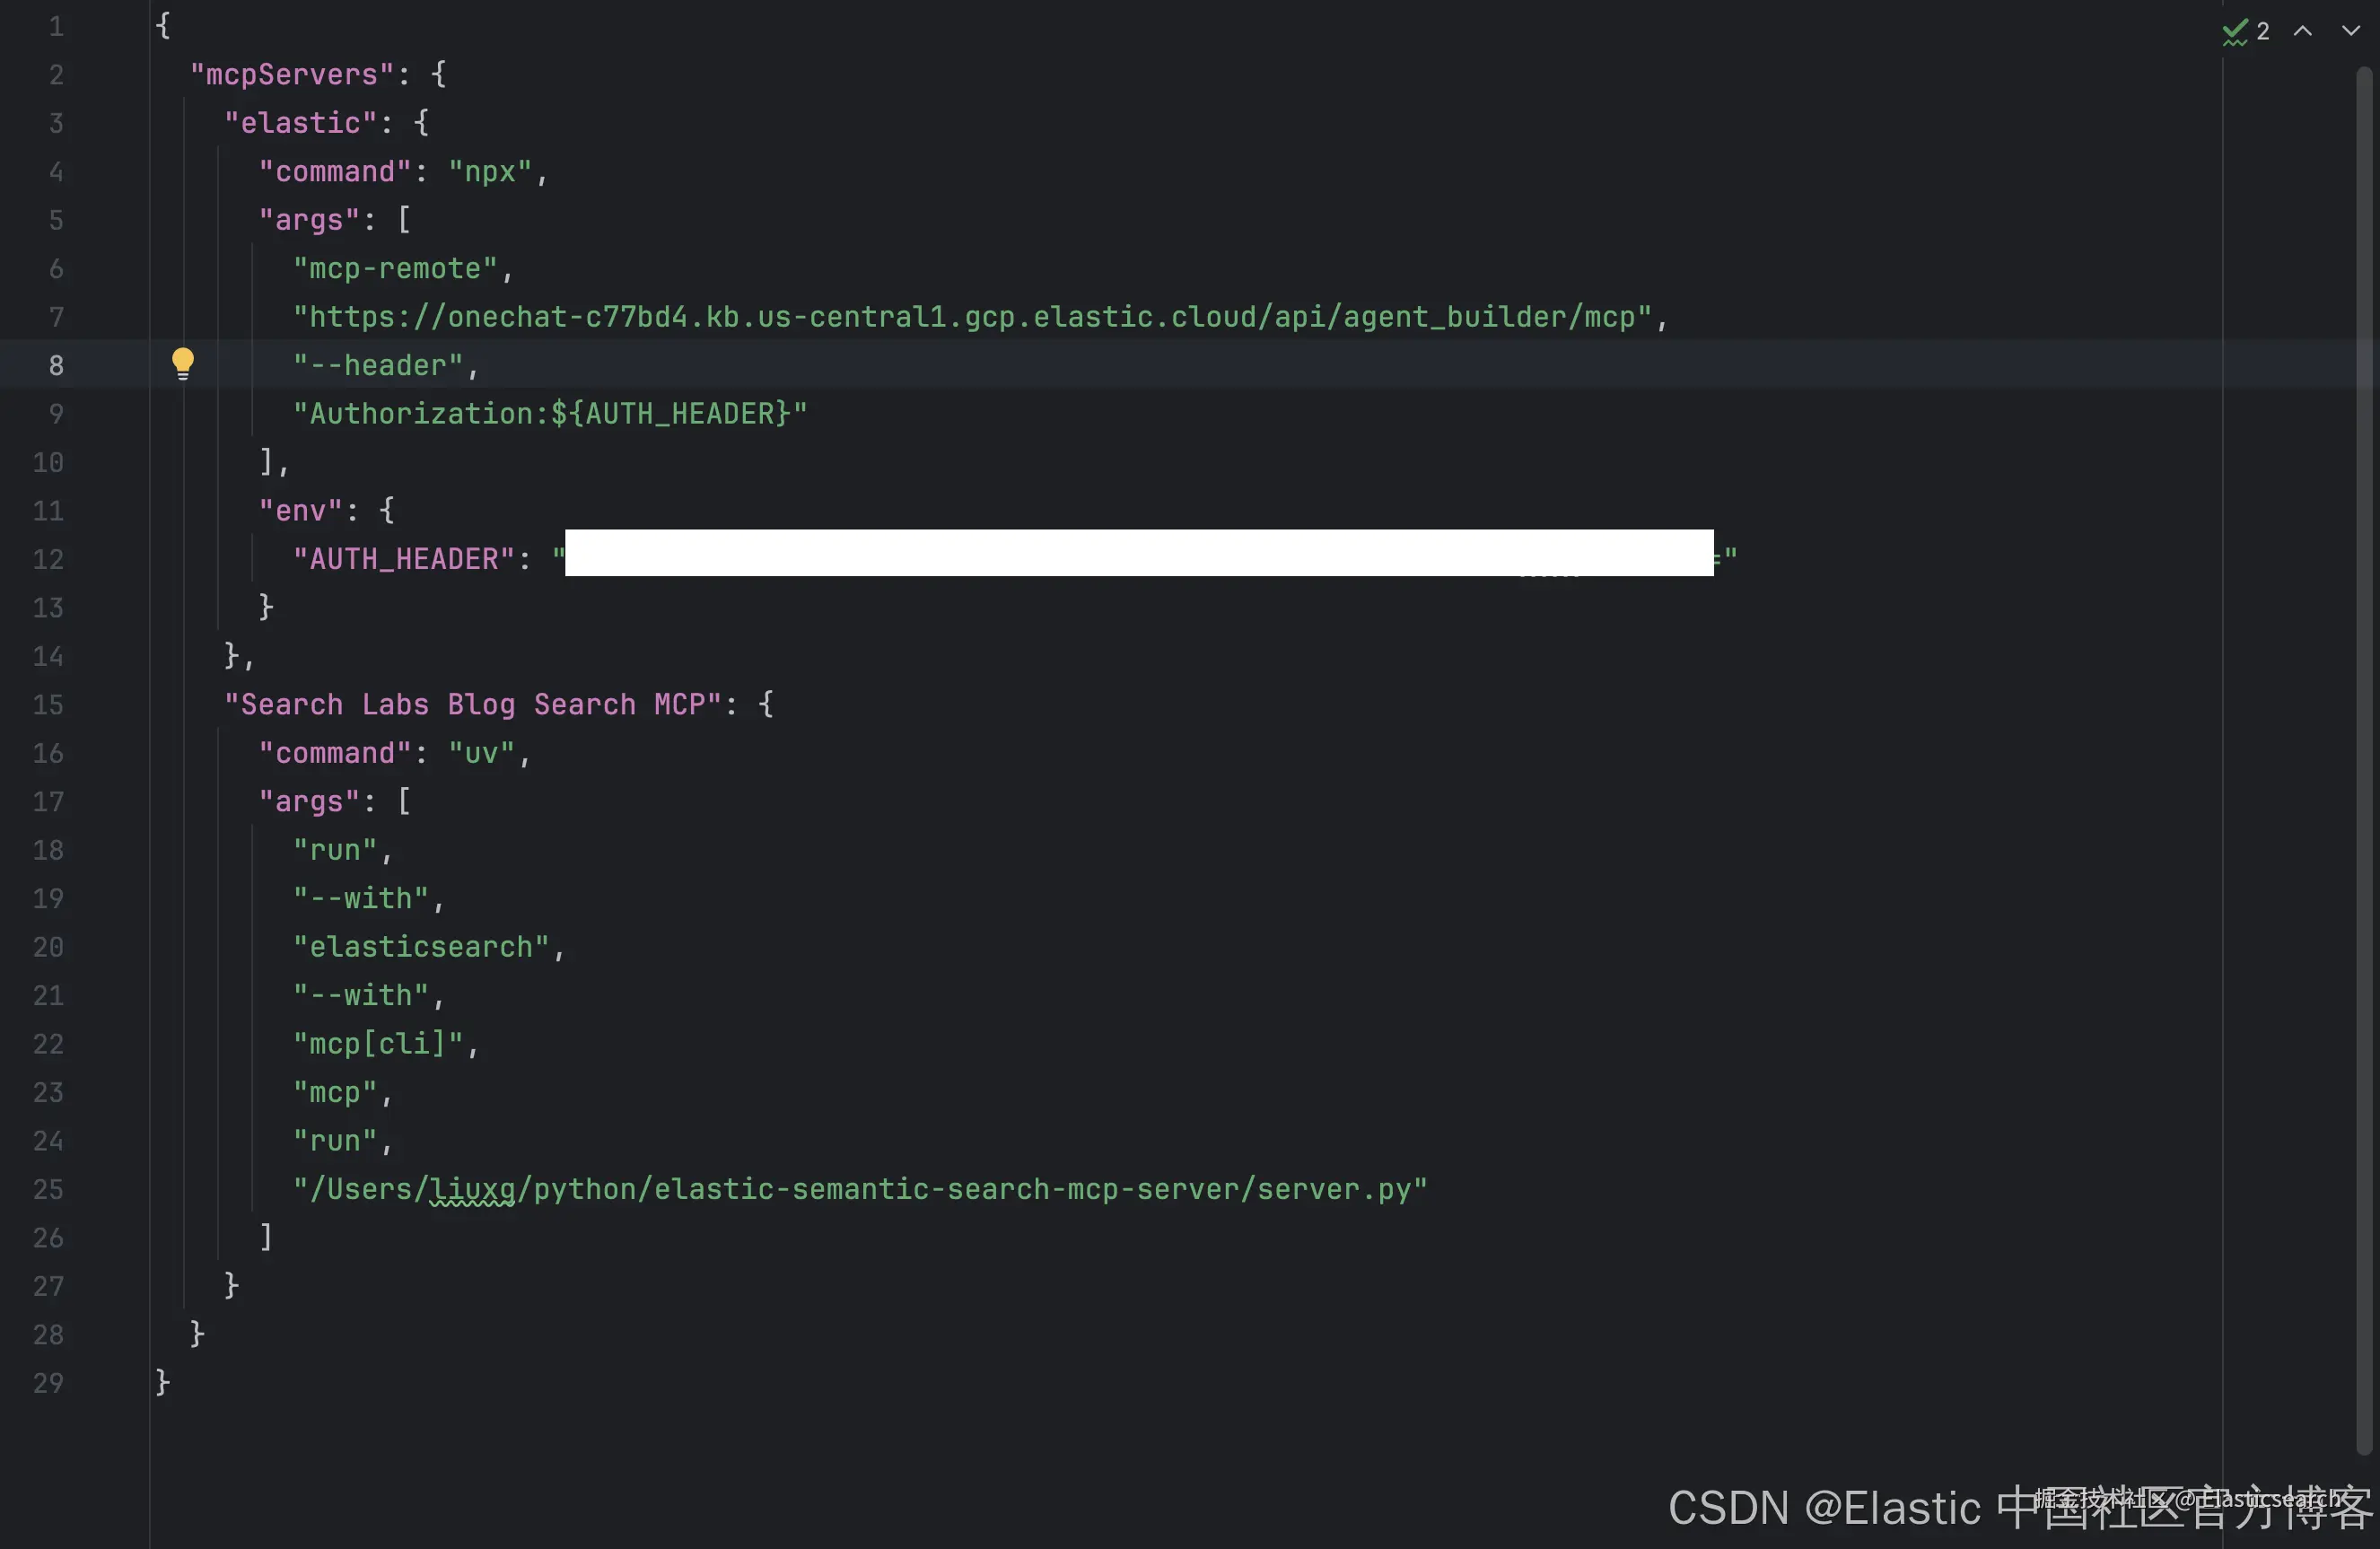
在配置文件里,我们可以看到 Search Labs Blog Search MCP 的配置。由于一些原因,我们需要修改上面的 command 字段为:
bash
`

1.  $ which uv
2.  /Users/liuxg/.local/bin/uv

`AI写代码
markdown
`
1. {
2. "mcpServers": {
3. "Search Labs Blog Search MCP": {
4. "command": "/Users/liuxg/.local/bin/uv",
5. "args": [
6. "run",
7. "--with",
8. "elasticsearch",
9. "--with",
10. "mcp[cli]",
11. "mcp",
12. "run",
13. "/Users/liuxg/python/elastic-semantic-search-mcp-server/server.py"
14. ]
15. }
16. }
17. }
`AI写代码否则,我们会出现如下的错误信息:
markdown
``
1. 2025-10-02T00:50:22.532Z [Search Labs Blog Search MCP] [error] spawn uv ENOENT {
2. metadata: {
3. stack: 'Error: spawn uv ENOENT\n' +
4. ' at ChildProcess._handle.onexit (node:internal/child_process:285:19)\n' +
5. ' at onErrorNT (node:internal/child_process:483:16)\n' +
6. ' at process.processTicksAndRejections (node:internal/process/task_queues:90:21)'
7. }
8. }
9. 2025-10-02T00:50:22.534Z [Search Labs Blog Search MCP] [info] Server transport closed { metadata: undefined }
10. 2025-10-02T00:50:22.534Z [Search Labs Blog Search MCP] [info] Client transport closed { metadata: undefined }
11. 2025-10-02T00:50:22.534Z [Search Labs Blog Search MCP] [info] Server transport closed unexpectedly, this is likely due to the process exiting early. If you are developing this MCP server you can add output to stderr (i.e. `console.error('...')` in JavaScript, `print('...', file=sys.stderr)` in python) and it will appear in this log. { metadata: undefined }
12. 2025-10-02T00:50:22.534Z [Search Labs Blog Search MCP] [error] Server disconnected. For troubleshooting guidance, please visit our [debugging documentation](https://modelcontextprotocol.io/docs/tools/debugging) { metadata: { context: 'connection', stack: undefined } }
13. 2025-10-02T00:55:18.336Z [Search Labs Blog Search MCP] [info] Initializing server... { metadata: undefined }
14. 2025-10-02T00:55:18.343Z [Search Labs Blog Search MCP] [info] Using MCP server command: /Users/liuxg/.local/bin/uv with args and path: {
15. metadata: {
16. args: [
17. 'run',
18. '--with',
19. 'elasticsearch',
20. '--with',
21. 'mcp[cli]',
22. 'mcp',
23. 'run',
24. '/Users/liuxg/python/elastic-semantic-search-mcp-server/server.py',
25. [length]: 8
26. ],
27. paths: [
28. '/Users/liuxg/.nvm/versions/node/v22.14.0/bin',
29. '/usr/local/bin',
30. '/opt/homebrew/bin',
31. '/opt/local/bin',
32. '/usr/bin',
33. '/usr/bin',
34. '/bin',
35. '/usr/sbin',
36. '/sbin',
37. [length]: 9
38. ]
39. }
40. } %o
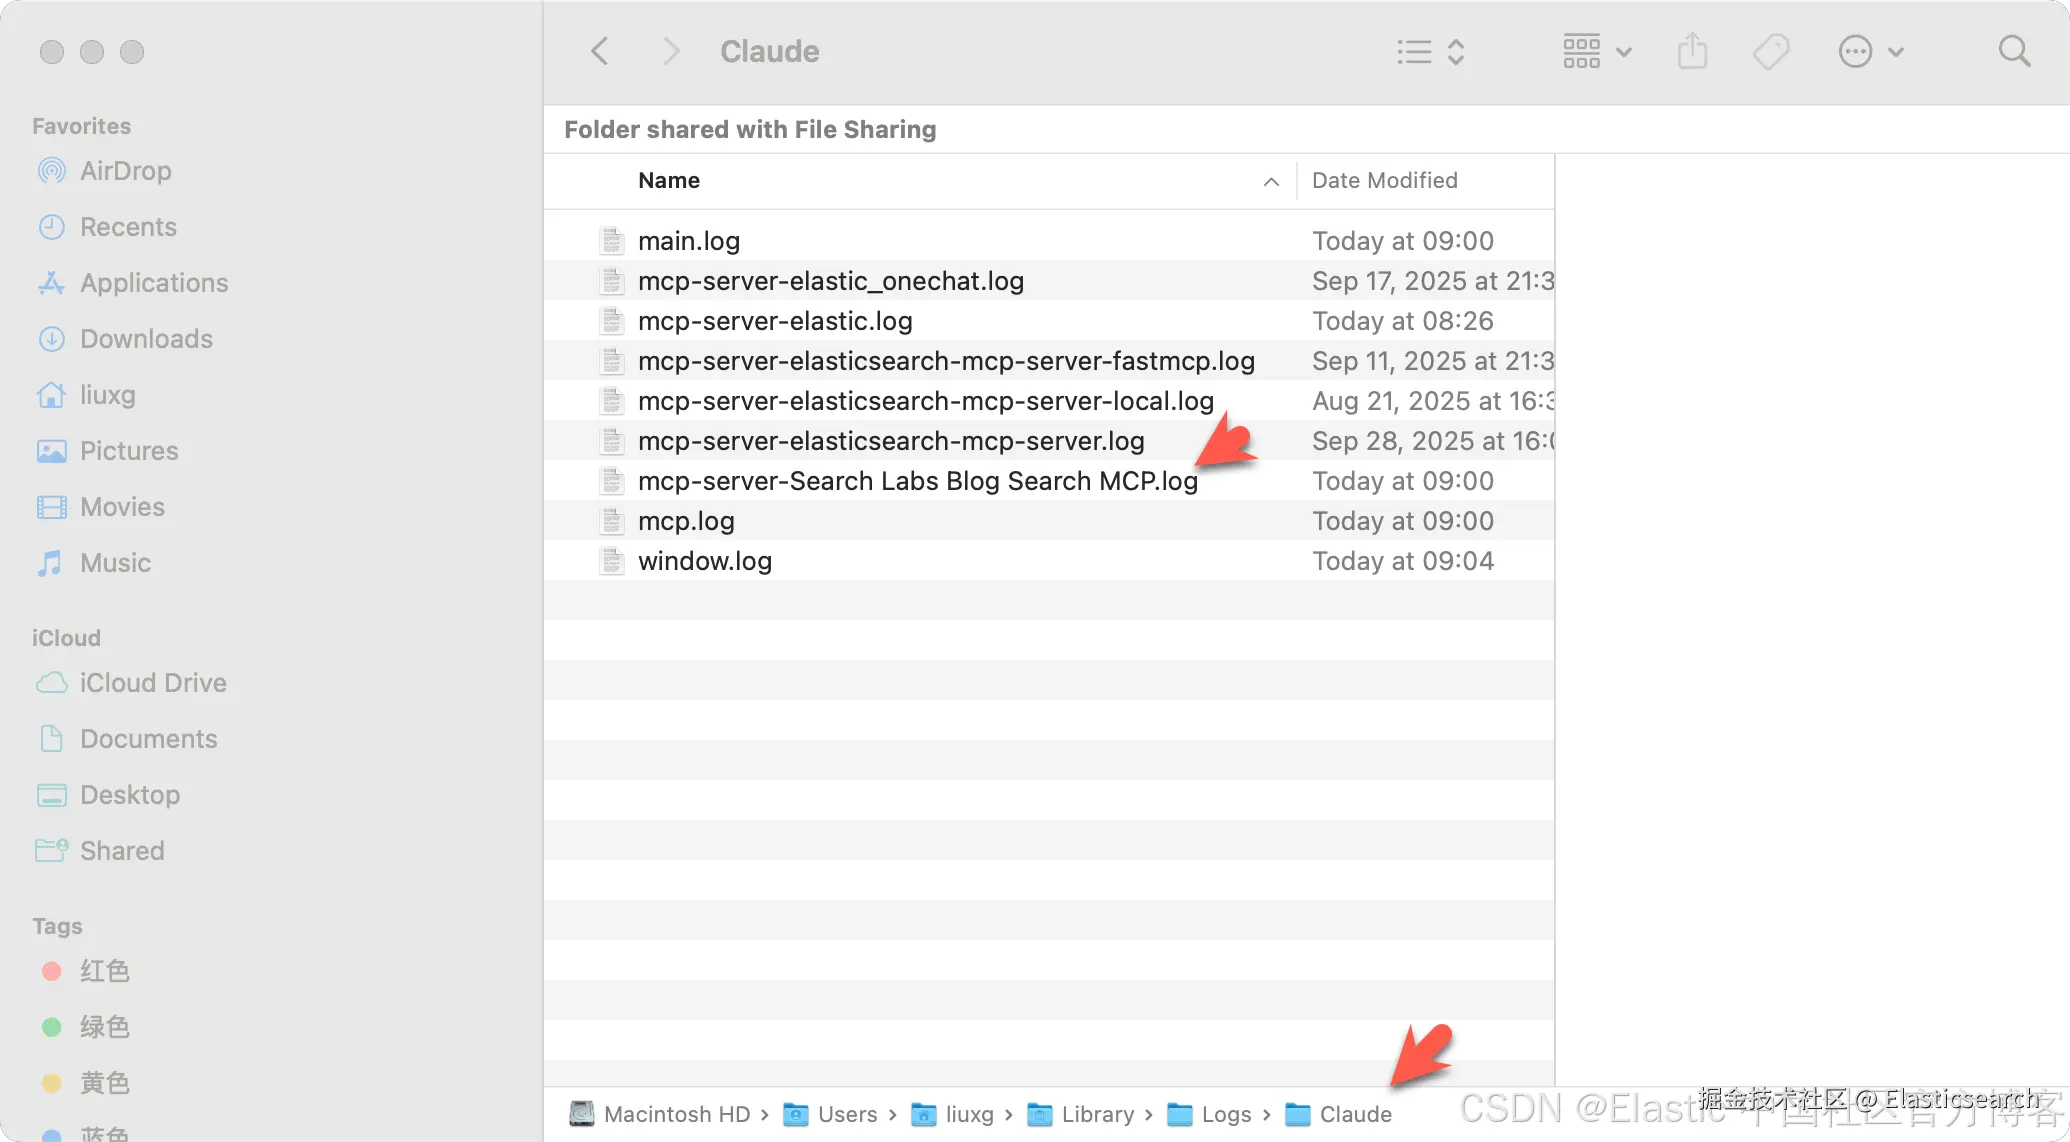
``AI写代码我们可以在如下的位置找到 Claude Desktop 的运行信息:
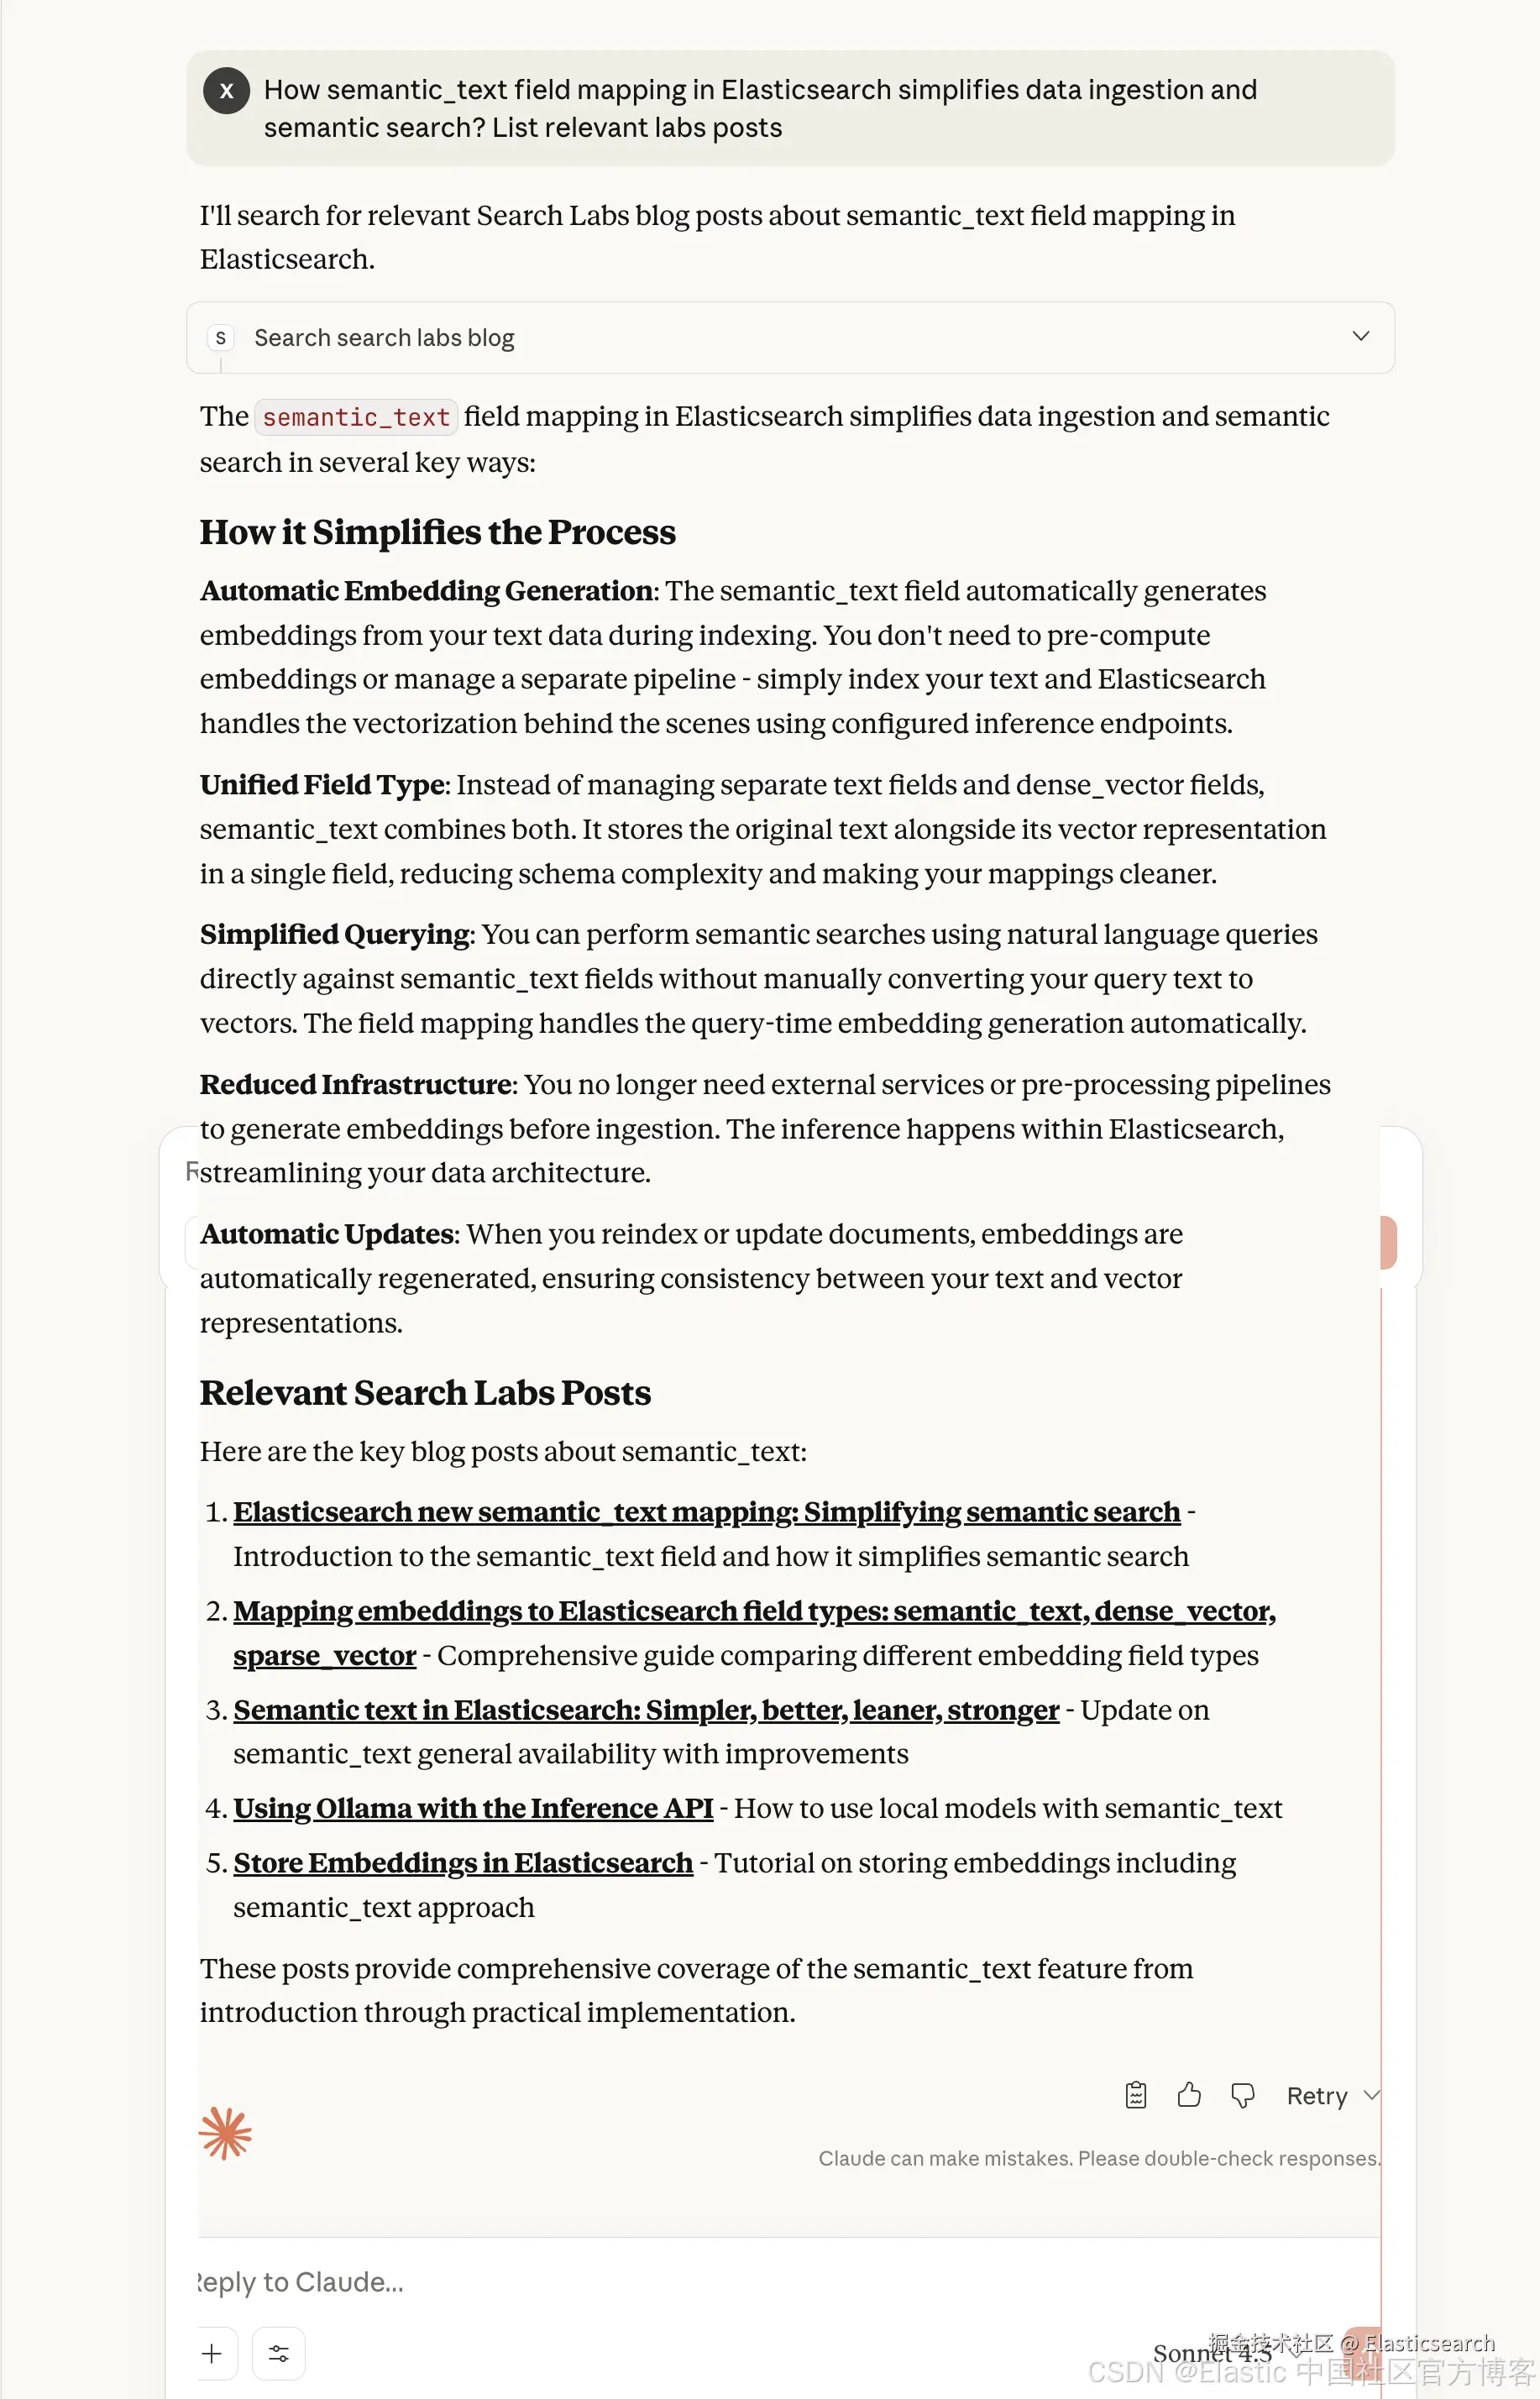
下面是 Claude 动态查找关于 semantic_text 博客文章的示例:
c
`How semantic_text field mapping in Elasticsearch simplifies data ingestion and semantic search? List relevant labs posts`AI写代码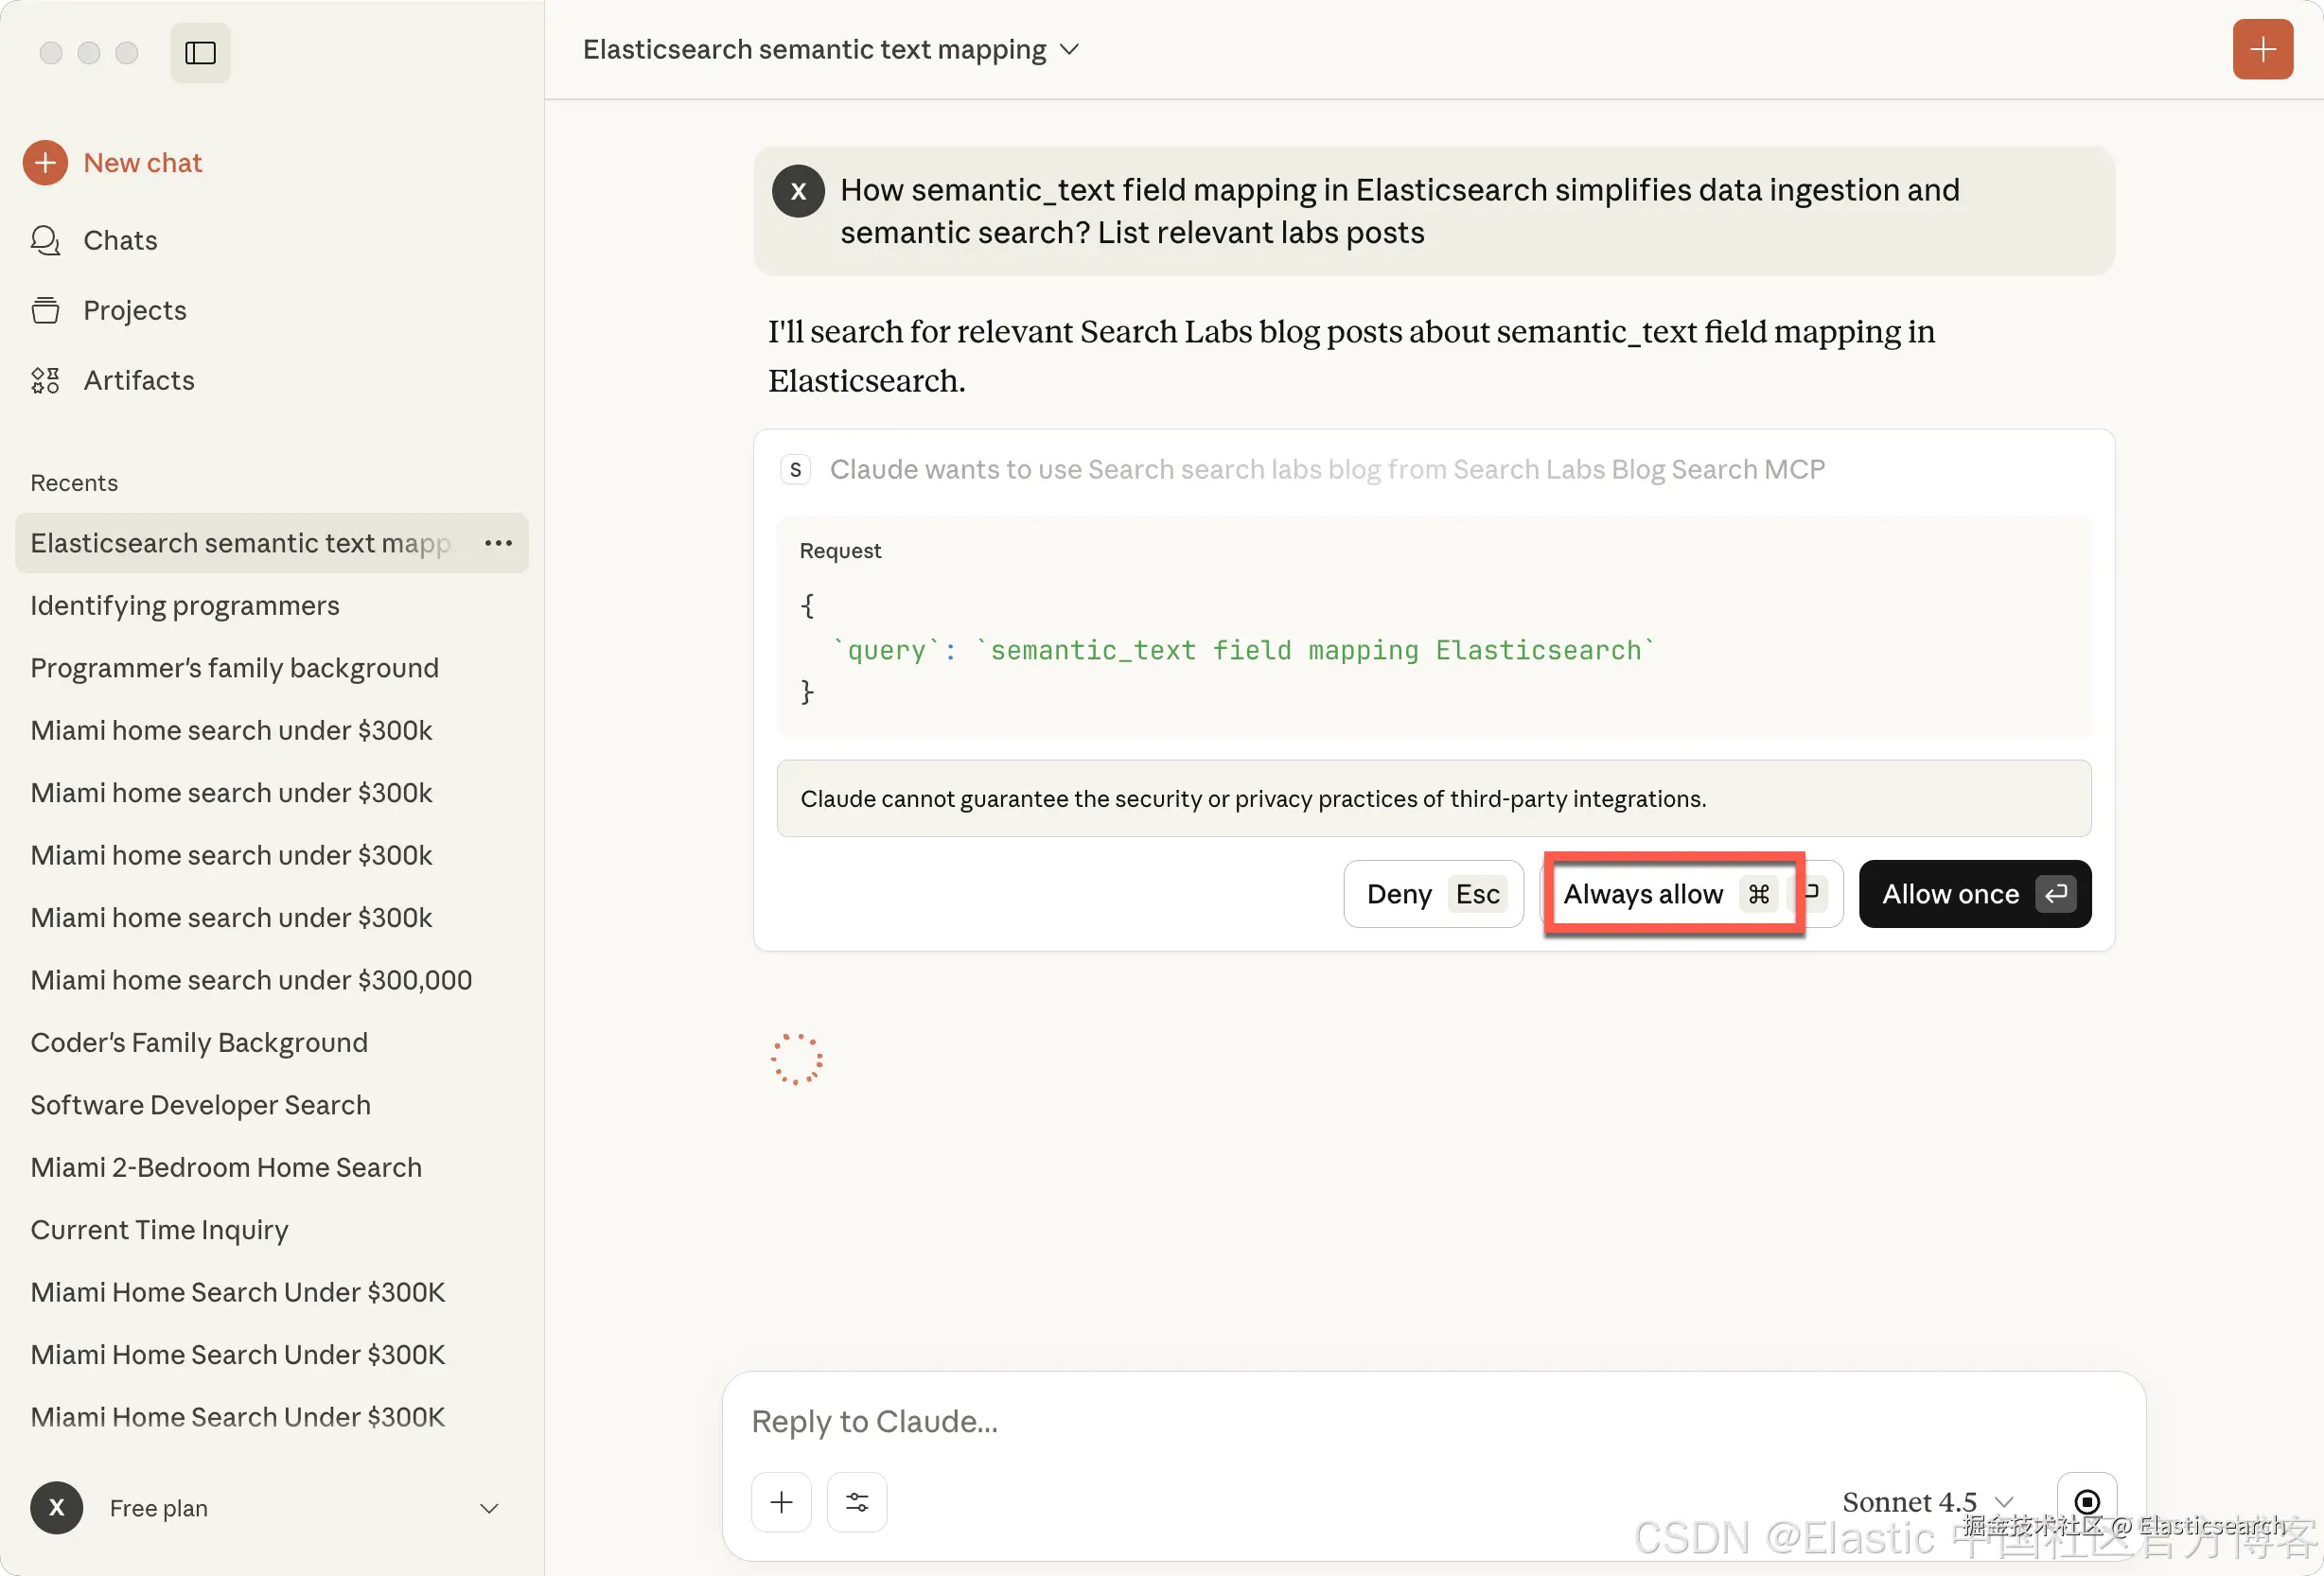
这只是一个起点。我们可以添加更多工具,比如一个通用的 Elasticsearch 查询工具,甚至启动更多 MCP 服务器来暴露额外的功能。真正的力量来自于把它们编排在一起。