简单模式的三个参数
哔哩哔哩
【消息队列rabbitmq】https://www.bilibili.com/video/BV12A411q7dE?p=7\&vd_source=a4afc316a0a5fd4aa85dd927345f10a4
1.持久化参数
1.1 队列持久化
channel.queue_declare(queue='hello_queue', durable=True)- 队列一旦声明,是否持久化就确定了,不能更改了。
- 如果想把非持久化的队列改为持久化队列,会报错。
- 若声明过,则换一个队列名字。
1.2 消息持久化
properties=pika.BasicProperties(
    delivery_mode=pika.spec.PERSISTENT_DELIVERY_MODE
)
properties = pika.BasicProperties(delivery_mode=2)
两者是等价写法
# 这本质上是 pika/spec.py 中定义的内容
PERSISTENT_DELIVERY_MODE = 2pika.spec.PERSISTENT_DELIVERY_MODE是 Pika 库提供的一个常量。如果查看它的源码,会发现它的定义就是2- 数字
2是 AMQP 协议标准中定义的一个值,明确代表"持久化消息"(persistent message)。这意味着消息会被写入磁盘,以便在 RabbitMQ 服务器重启后仍然存在(前提是它所在的队列也是持久化的)。 - 代码一眼就能看出意图是设置"持久化投递模式",而不需要去记忆或查找协议文档中的数字含义。
1.3 问题
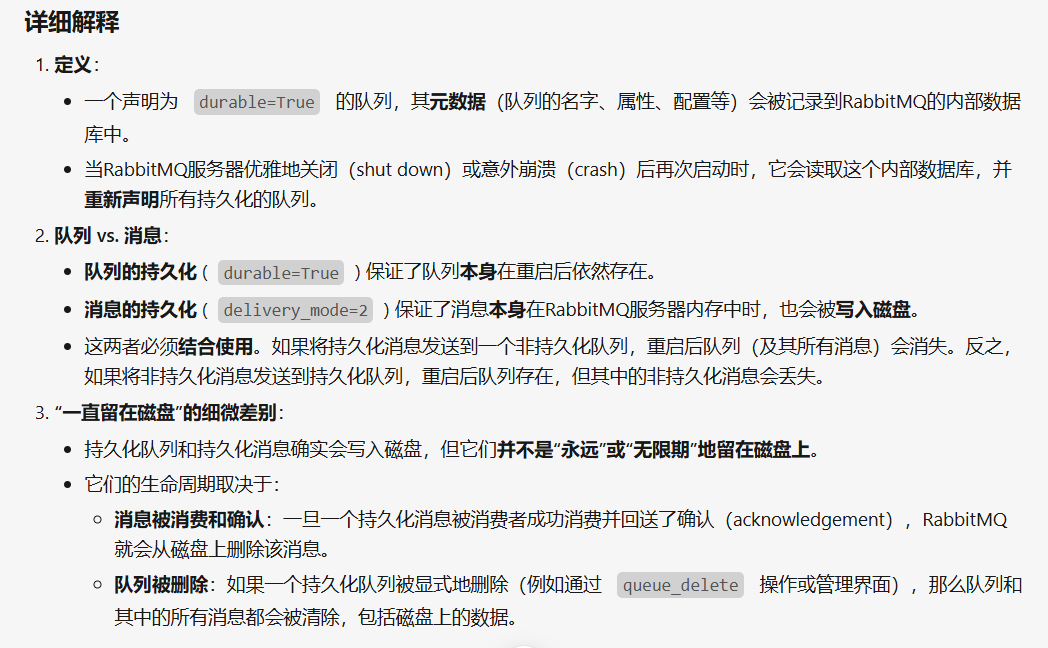
1.3.1 持久化的队列就会一直留在磁盘么,无论MQ是否重启?
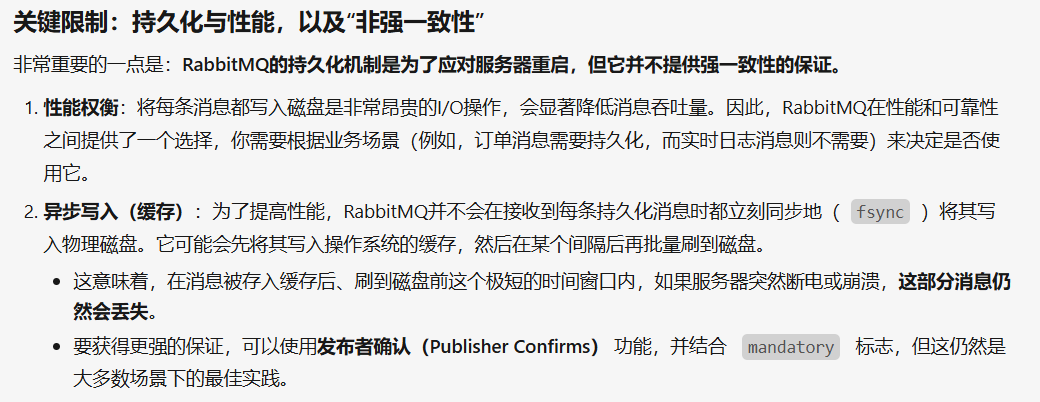
1.3.2 它可能会先将其写入操作系统的缓存,然后在某个间隔后再批量刷到磁盘。 那么消费者是需要等待消息写入磁盘之后,才能监听到这条新消息吗
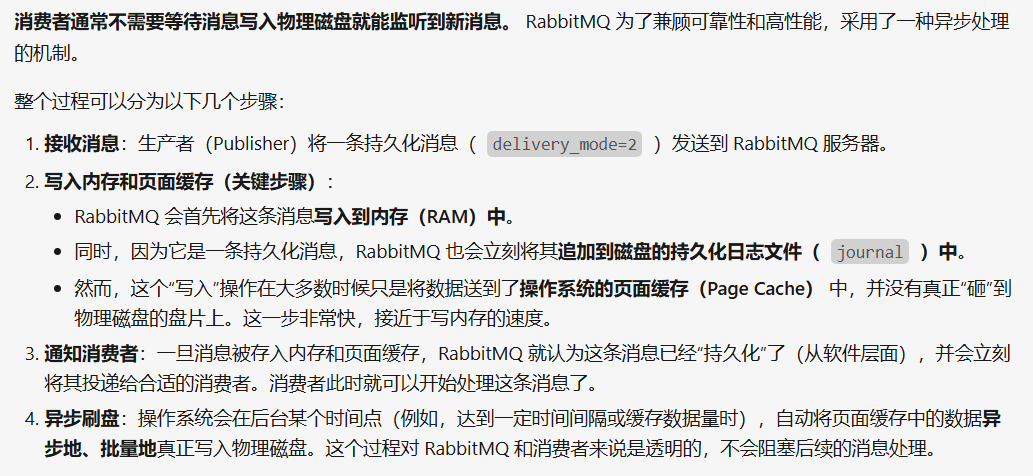
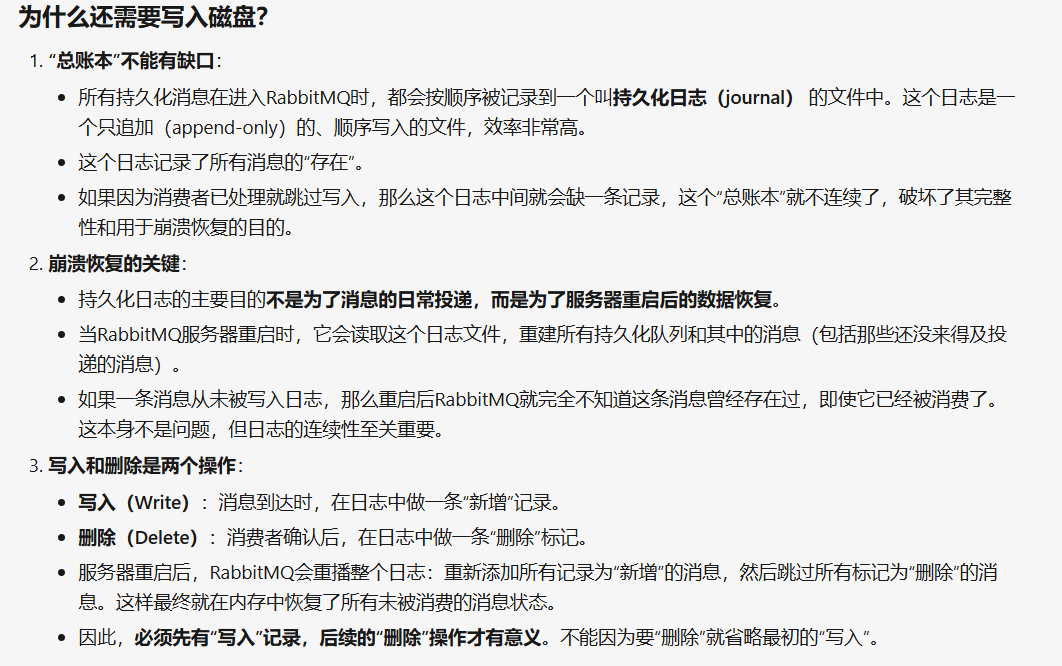
1.3.3 通知消费者:一旦消息被存入内存和页面缓存,RabbitMQ 就认为这条消息已经"持久化"了(从软件层面),并会立刻将其投递给合适的消费者。消费者此时就可以开始处理这条消息了。 可是消费者已经处理完了 还需要再批量写入磁盘么
是的,即使消费者已经处理完并返回了确认(ACK),只要这条消息最初是持久化的,RabbitMQ仍然需要完成将它写入磁盘这个过程。
2.应答参数
channel.basic_consume(queue='hello_queue',
auto_ack=True, # 应答参数
on_message_callback=callback)
2.1 auto_ack=True 默认应答 (效率)
队列有数据,取走,取走就出队,队列里就没有了。
如果消费者进程出bug了,callback没有成功执行,但是已经出队了,没办法重新处理
2.2 auto_ack=False 手动应答 (安全)
在callback中加入 ch.basic_ack(delivery_tag=method.delivery_tag)
python
def callback(ch, method, properties, body):
    ........... # 自己要处理的逻辑
    ch.basic_ack(delivery_tag=method.delivery_tag)

# 确定监听队列参数
channel.basic_consume(queue='hello_queue',
                      auto_ack=False, # 手动应答
                      on_message_callback=callback)
要处理的操作成功执行,出队
3.分发参数
- 用于多个消费者监听同一个队列
- 默认:轮询分发模式
- 有两个消费者同时监听一个的队列。其中一个线程sleep2秒,另一个消费者线程sleep1秒,但是处理的消息是一样多。这种方式叫轮询分发(round-robin)不管谁忙,都不会多给消息,总是你一个我一个。
- 想要做到公平分发(fair dispatch),必须关闭自动应答ack,改成手动应答。使用basicQos(perfetch=1)限制每次只发送不超过1条消息到同一个消费者,消费者必须手动反馈告知队列,才会发送下一个。
python
def callback(ch, method, properties, body):
    ........... # 自己要处理的逻辑
    ch.basic_ack(delivery_tag=method.delivery_tag)

# 公平分发
channel.basic_qos(prefetch_count=1)

# 确定监听队列参数
channel.basic_consume(queue='hello_queue',
                      auto_ack=False, # 手动应答
                      on_message_callback=callback)
这样处理速度快的消费者进程就可以多得到一些消息,不用一直等待