基于mapreduce的资金流入流出任务计算
项目概况
**👇👇👇👇👇👇👇👇**
**👆👆👆👆👆👆👆👆**
数据类型
阿里天池流⼊流出资金数据
开发环境
centos7
软件版本
python3.8.18、hadoop3.2.0、mysql5.7.38、jdk8、sqoop1.4.7
开发语言
python、Java
开发流程
数据上传(hdfs)->数据分析(mapreduce)->数据存储(mysql)->后端(flask)->前端(html+js+css)
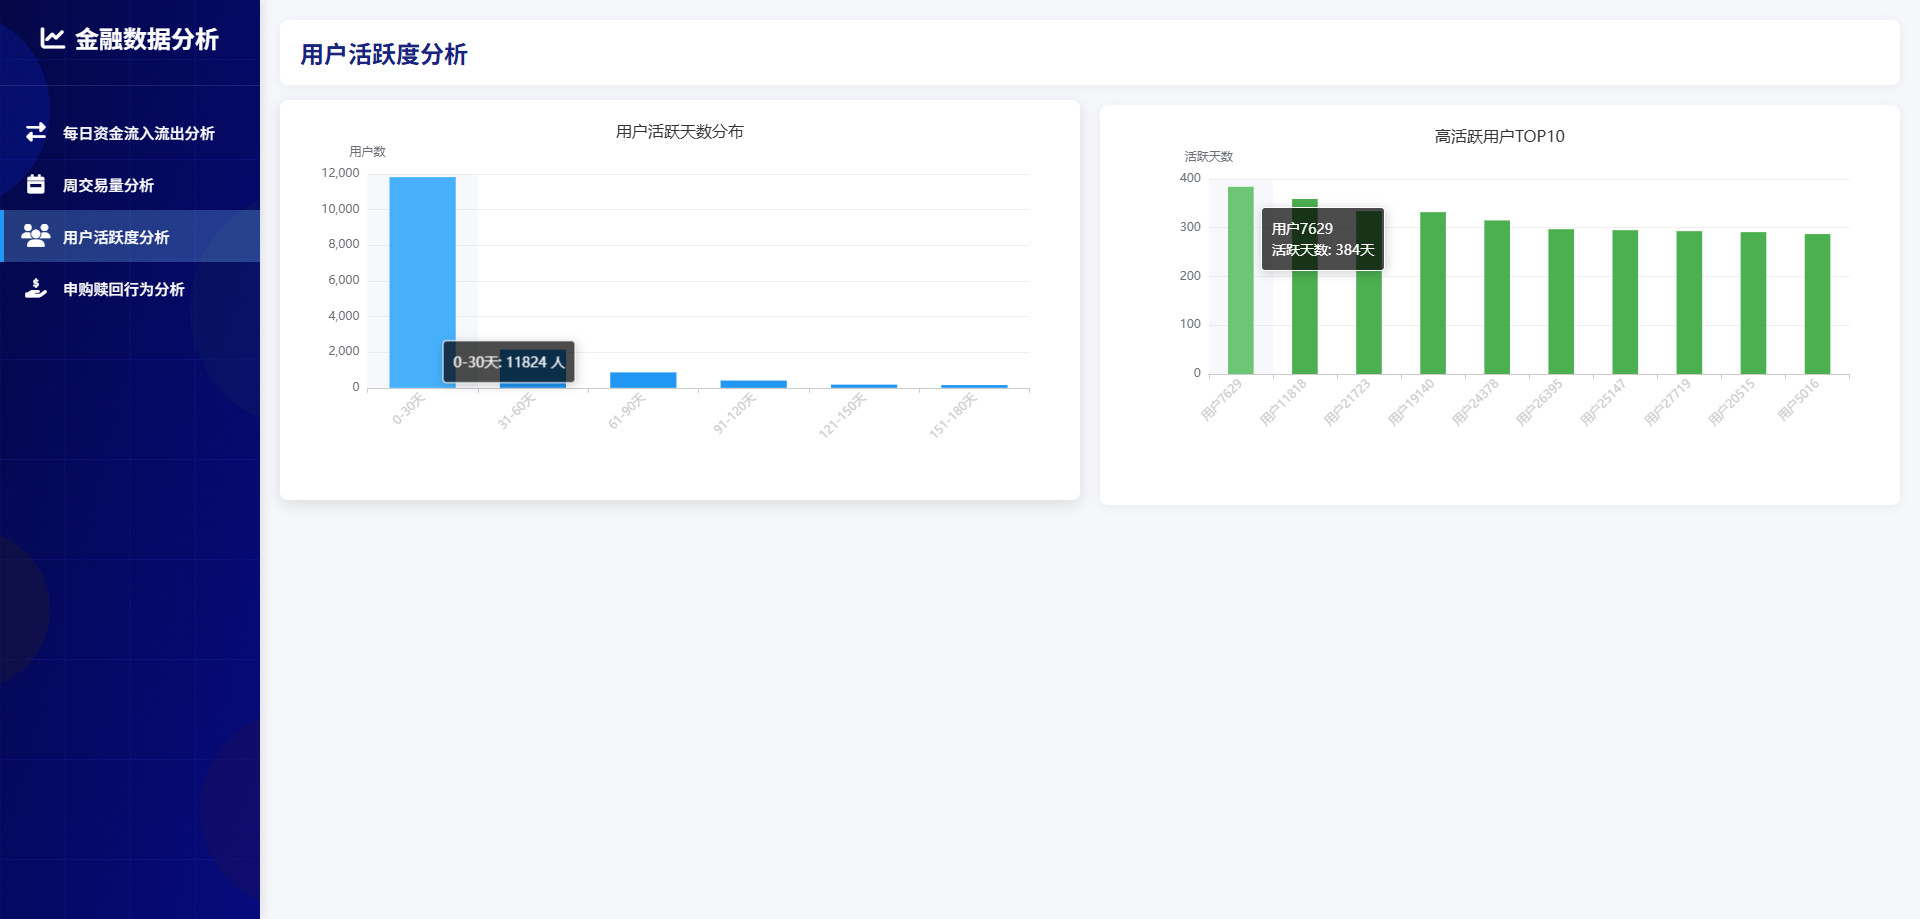
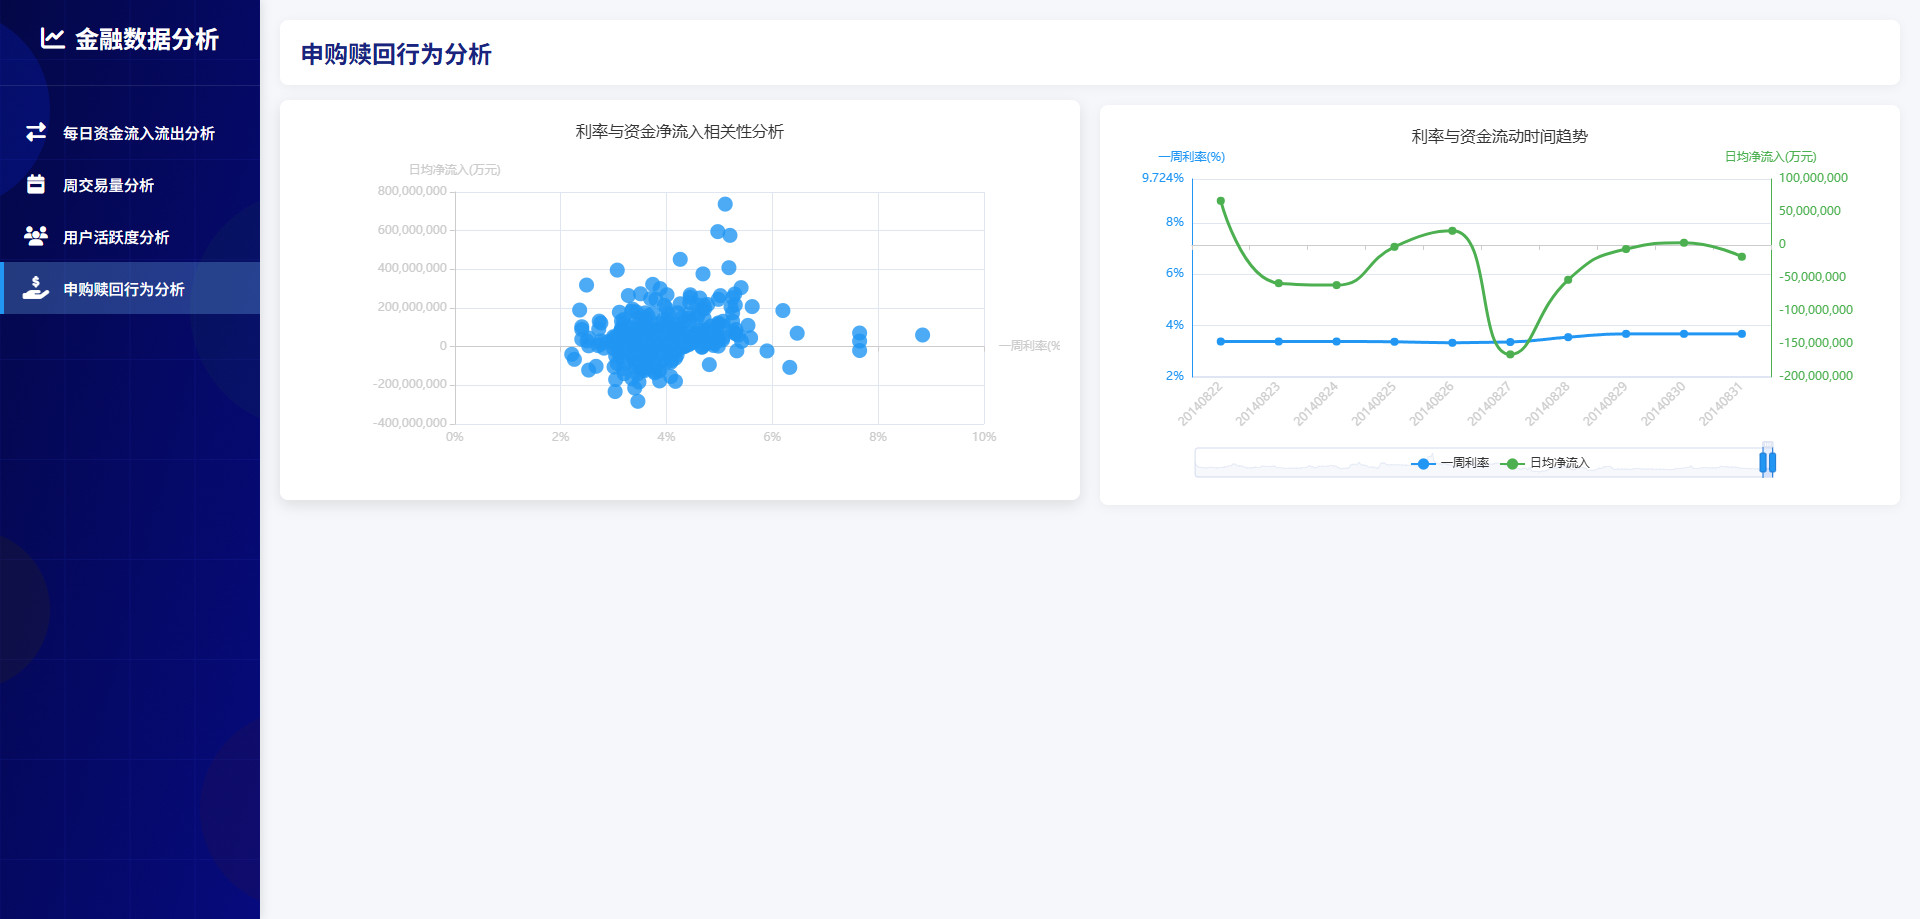
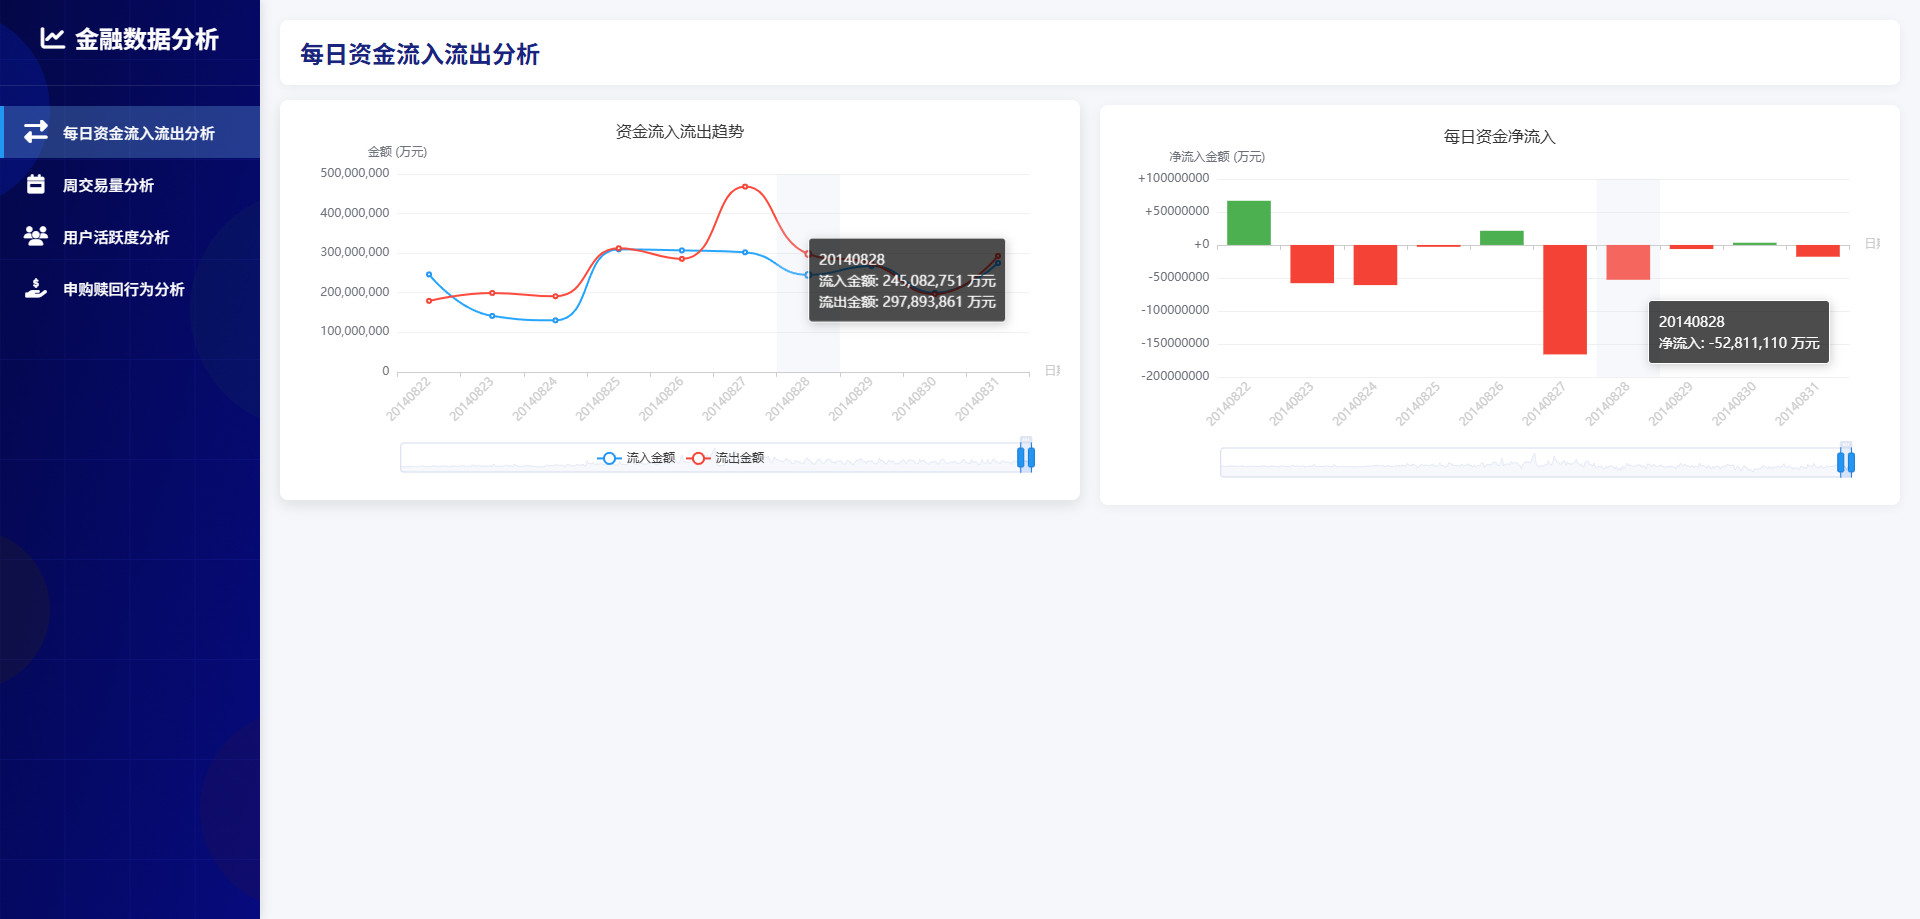
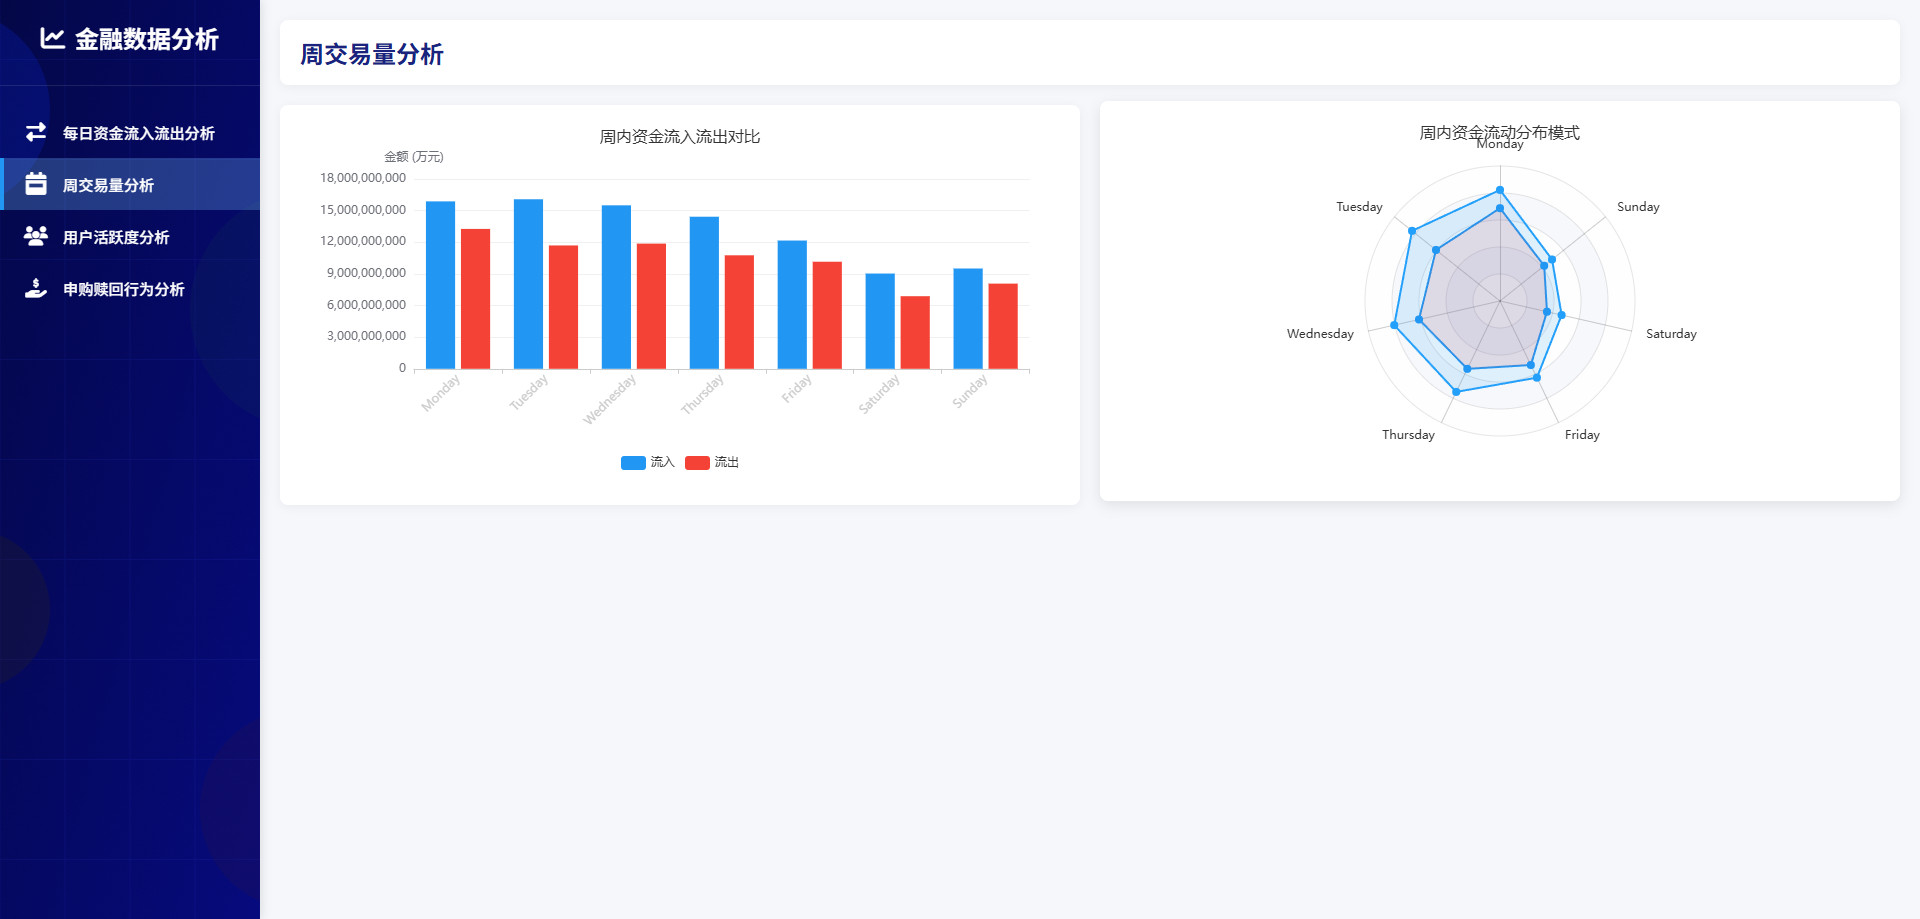
可视化图表
操作步骤
python安装包
shell
pip3 install pandas==2.0.3 -i https://mirrors.aliyun.com/pypi/simple/
pip3 install flask==3.0.0 -i https://mirrors.aliyun.com/pypi/simple/
pip3 install flask-cors==4.0.1 -i https://mirrors.aliyun.com/pypi/simple/
pip3 install pymysql==1.1.0 -i https://mirrors.aliyun.com/pypi/simple/
pip3 install pyecharts==2.0.4 -i https://pypi.tuna.tsinghua.edu.cn/simple
启动MySQL
shell
# 查看mysql是否启动 启动命令: systemctl start mysqld.service
systemctl status mysqld.service
# 进入mysql终端
# MySQL的用户名:root 密码:123456
# MySQL的用户名:root 密码:123456
# MySQL的用户名:root 密码:123456
mysql -uroot -p123456
启动Hadoop
shell
# 离开安全模式: hdfs dfsadmin -safemode leave
# 启动hadoop
bash /export/software/hadoop-3.2.0/sbin/start-hadoop.sh
准备目录
shell
mkdir -p /data/jobs/project/
cd /data/jobs/project/

# 解压 "data" 目录下的 "Purchase Redemption Data.7z" 文件
# 上传 "Purchase Redemption Data" 目录下的 "所有CSV" 文件/文件夹 到 "/data/jobs/project/" 目录

# mfd_bank_shibor.csv
# mfd_day_share_interest.csv
# user_balance_table.csv
# user_profile_table.csv
上传文件到hdfs
shell
cd /data/jobs/project/

hdfs dfs -mkdir -p /data/input/
hdfs dfs -rm -r /data/input/*
hdfs dfs -put -f mfd_bank_shibor.csv /data/input/
hdfs dfs -put -f mfd_day_share_interest.csv /data/input/
hdfs dfs -put -f user_balance_table.csv /data/input/
hdfs dfs -put -f user_profile_table.csv /data/input/
hdfs dfs -ls /data/input/
程序打包
shell
cd /data/jobs/project/

# 对 "project-mapreduce-capital-task-calc" 目录下的项目 "project-mapreduce-capital-task-calc" 进行打包
# 打包命令: mvn clean package -Dmaven.test.skip=true

# 上传 "project-mapreduce-capital-task-calc/target/" 目录下的 "project-mapreduce-capital-task-calc-jar-with-dependencies.jar" 文件 到 "/data/jobs/project/" 目录
mapreduce数据分析
shell
cd /data/jobs/project/

# 每日资金流入流出统计
hadoop jar project-mapreduce-capital-task-calc-jar-with-dependencies.jar 1 /data/input/user_balance_table.csv /data/output/capital_daily_flow/

hdfs dfs -ls /data/output/capital_daily_flow/
hdfs dfs -cat /data/output/capital_daily_flow/part-r-00000|head -10

# 星期交易量统计
hadoop jar project-mapreduce-capital-task-calc-jar-with-dependencies.jar 2 /data/output/capital_daily_flow/ /data/output/transaction_weekly/

hdfs dfs -ls /data/output/transaction_weekly/
hdfs dfs -cat /data/output/transaction_weekly/part-r-00000|head -10

# 用户活跃度分析
hadoop jar project-mapreduce-capital-task-calc-jar-with-dependencies.jar 3 /data/input/user_balance_table.csv /data/output/user_activity/

hdfs dfs -ls /data/output/user_activity/
hdfs dfs -cat /data/output/user_activity/part-r-00000|head -10

# 申购赎回行为分析
hadoop jar project-mapreduce-capital-task-calc-jar-with-dependencies.jar 4 /data/input/mfd_bank_shibor.csv /data/output/capital_daily_flow/ /data/output/transaction_factors/

hdfs dfs -ls /data/output/transaction_factors/
hdfs dfs -cat /data/output/transaction_factors/part-r-00000|head -10
创建MySQL表
shell
cd /data/jobs/project/

# 上传 "mysql" 目录下的 "mysql.sql" 文件 到 "/data/jobs/project/" 目录

# 请确认mysql服务已经启动了
# 快速执行.sql文件内的sql语句
mysql -u root -p < mysql.sql
数据导入MySQL
shell
cd /data/jobs/project/

# 上传 "mysql" 目录下的 "sqoop.sh" 文件 到 "/data/jobs/project/" 目录

sed -i 's/\r//g' sqoop.sh
bash sqoop.sh
启动可视化
shell
mkdir -p /data/jobs/project/myapp/
cd /data/jobs/project/myapp/

# 上传 "可视化" 目录下的 "所有" 文件和文件夹 到 "/data/jobs/project/" 目录

# windows本地运行: python app.py
python3 app.py pro