从数据中学习
深度学习有时也称为端到端机器学习
为了正确评价模型的泛化能力 ,就必须划分训练数据和测试数据。另外,训练数据也可以称为监督数据
泛化能力 是指处理未被观察过的数据(不包含在训练数据中的数据)的能力
损失函数是表示神经网络性能的"恶劣程度"的指标,即当前的神经网络对监督数据在多大程度上不拟合,在多大程度上不一致。
损失函数
均方误差
python
def mean_squared_error(y, t):
return 0.5 * np.sum((y-t)**2)均方误差会计算神经网络的输出和正确解监督数据的各个元素之差 的平方,再求总和,由所有标签的输出结果决定。
交叉熵误差
交叉熵误差的值是由正确解标签所对应的输出结果决定的。
python
def cross_entropy_error(y, t):
    delta = 1e-7
    return -np.sum(t * np.log(y + delta))
在进行神经网络的学习时,不能将识别精度作为指标。因为如果以识别精度为指标,则参数的导数在绝大多数地方都会变为0。
识别精度对微小的参数变化基本上没有什么反应,即便有反应,它的值也是不连续地、突然地变化。
因此引入损失函数
利用数值微分求导得到损失函数关于权重参数的梯度
利用微小的差分求导数的过程称为数值微分。
由全部变量的偏导数汇总而成的向量称为梯度
重要性质:梯度指示的方向是各点处的函数值减小最多的方向
学习率决定在一次学习中,应该学习多少,以及在多大程度上更新参数
像学习率这样的参数称为超参数。这是一种和神经网络的参数(权重和偏置)性质不同的参数。
神经网络中,参数由算法训练获得而超参数则由人工设定。
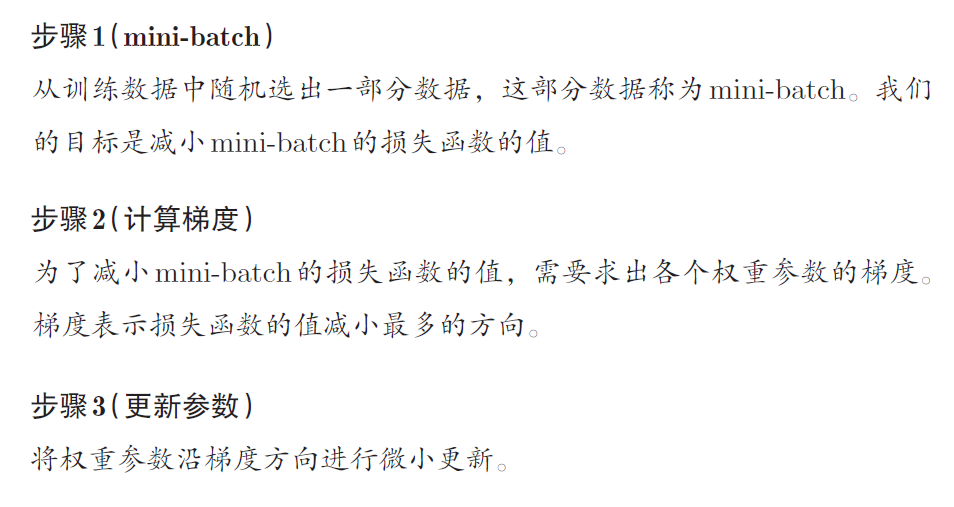
随机梯度下降(SGD)
过拟合是指,虽然训练数据中的数字图像能被正确辨别,但是不在训练数据中的数字图像却无法被识别的现象。
一个epoch 表示学习中所有训练数据均被使用过一次时的更新次数
总结
神经网络用训练数据进行学习,并用测试数据评价学习到的模型的泛化能力。
神经网络的学习以损失函数为指标 ,更新权重参数,以使损失函数的值减小。