K-means 聚类算法的损失函数推导与收敛性证明的核心过程,通过数学推导解释了 K-means "迭代更新聚类中心" 的合理性
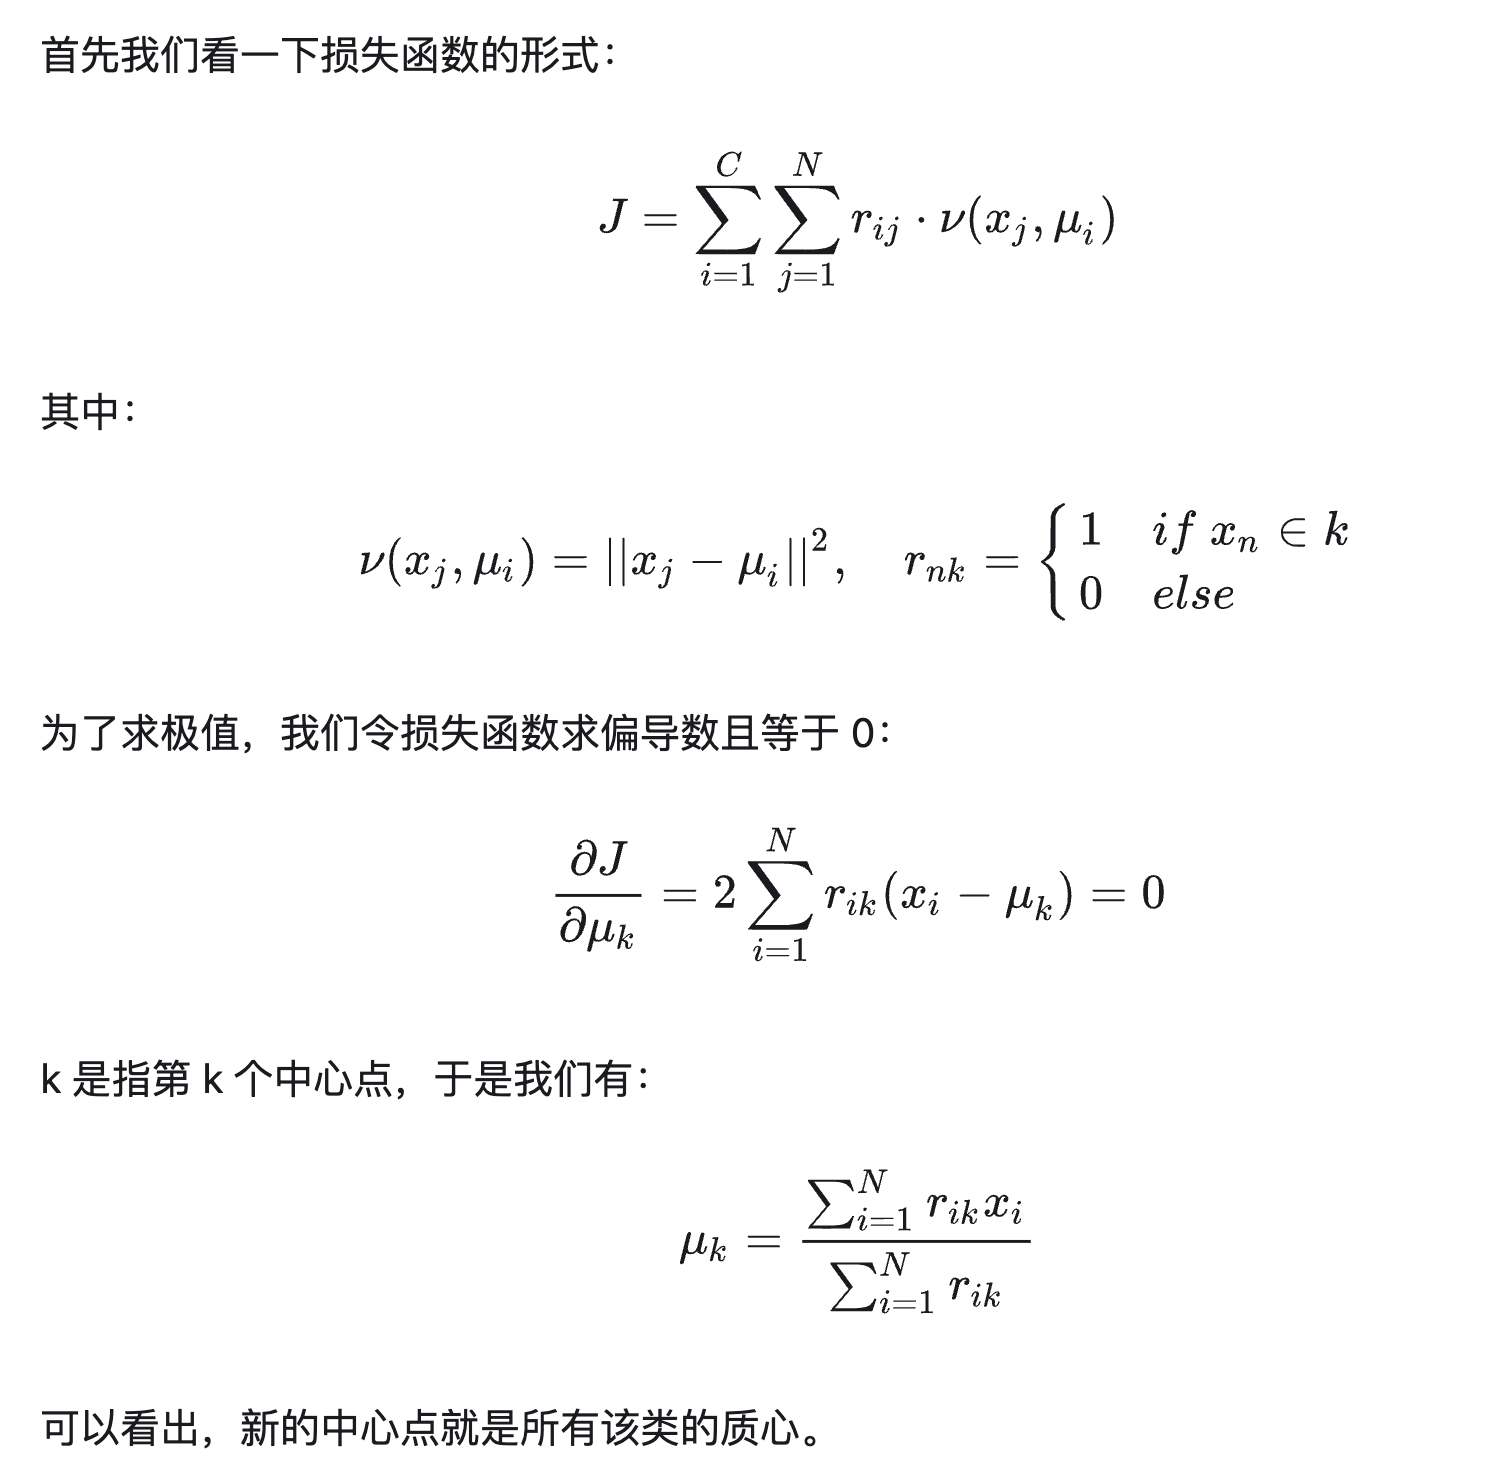
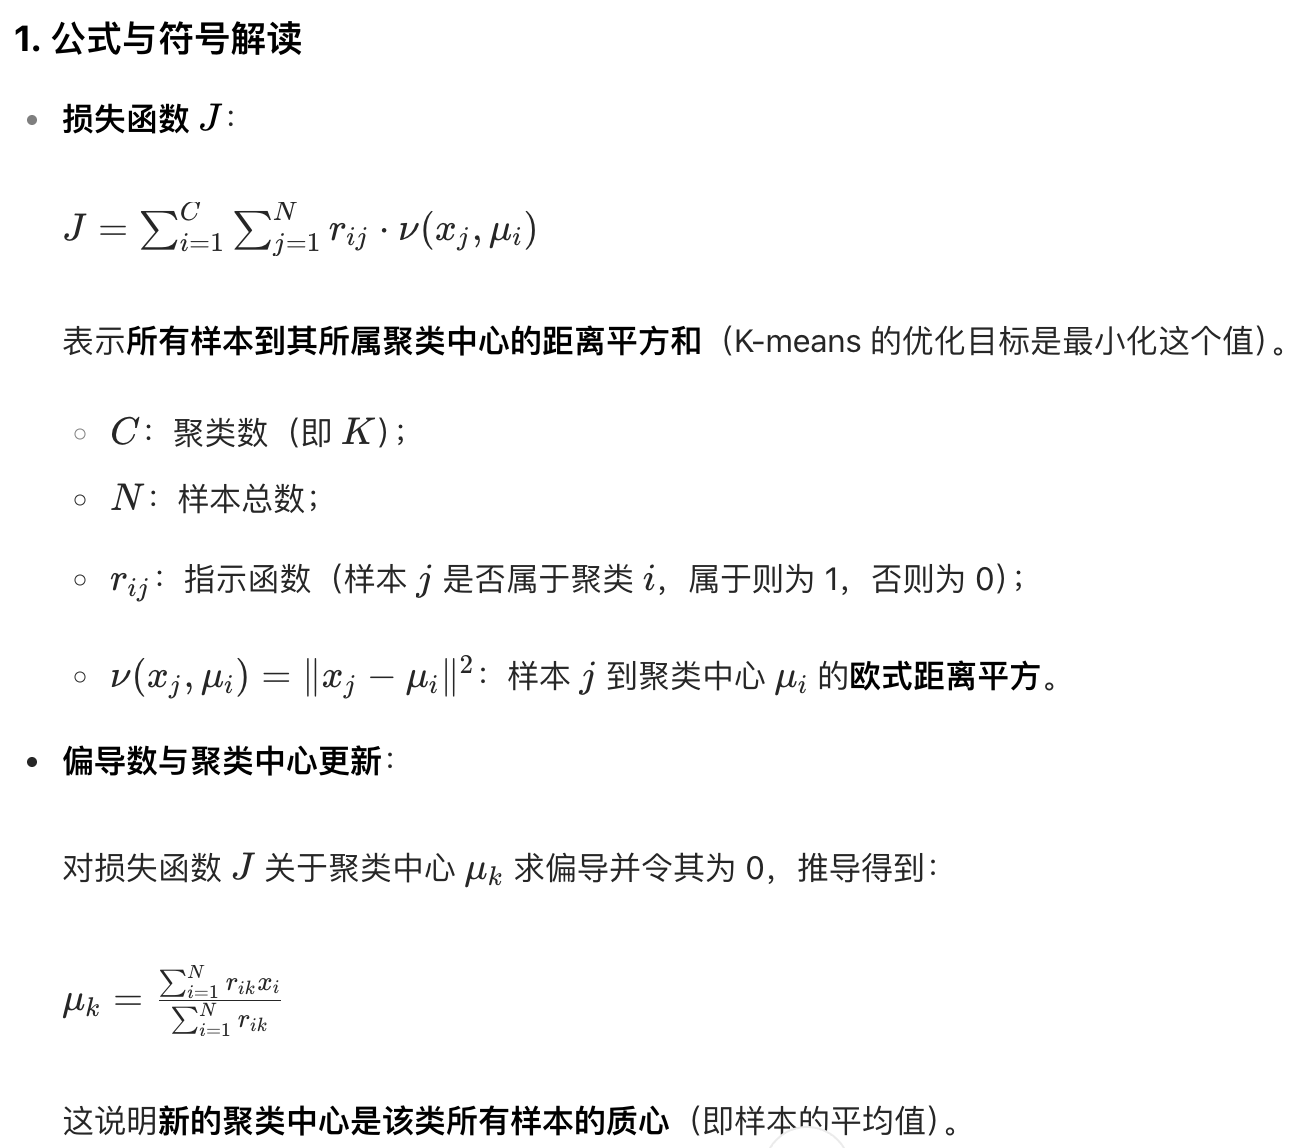
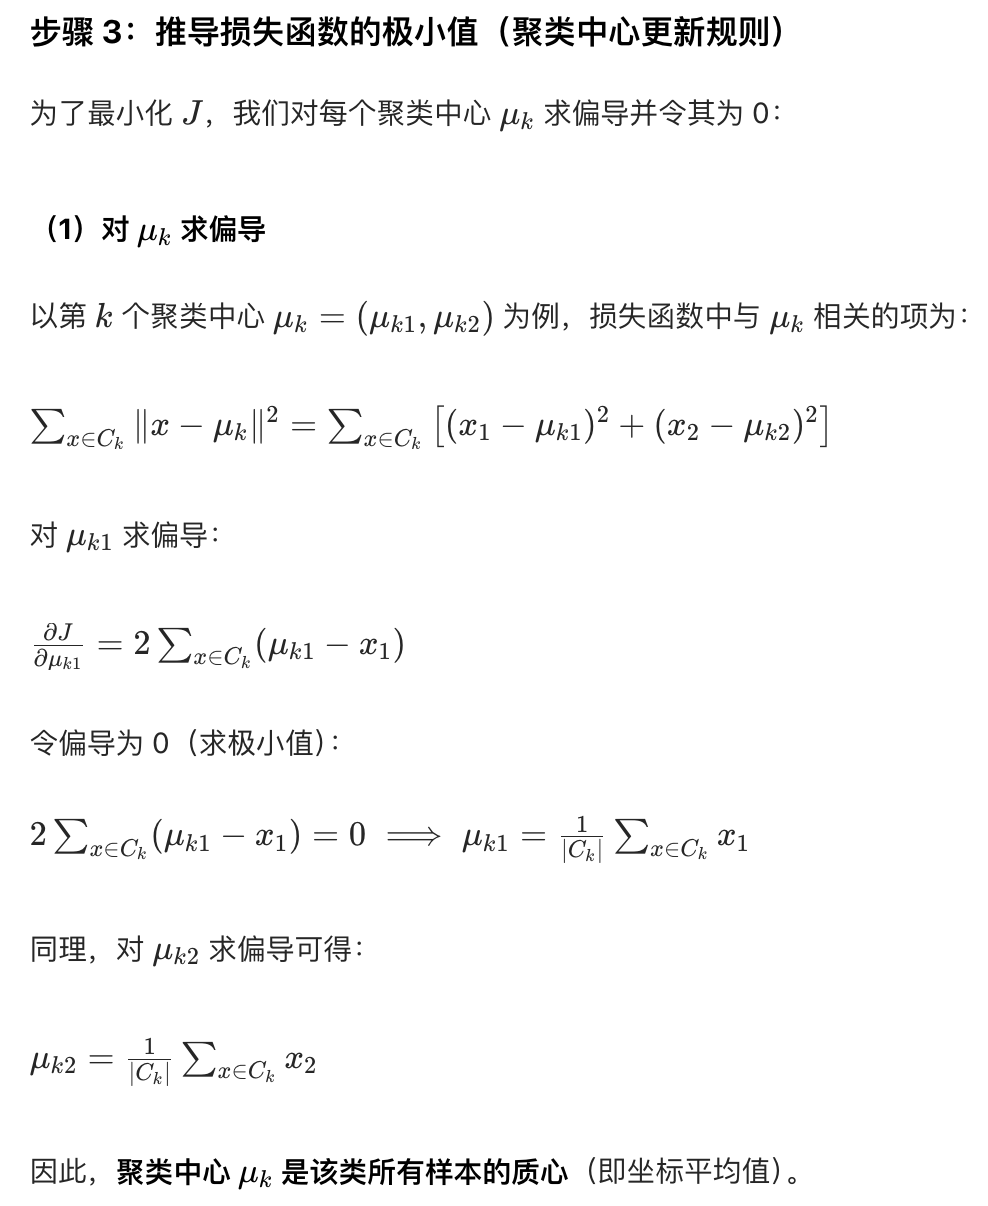
K-means 的迭代过程是 "分配样本到最近中心→更新中心为类内质心" 的循环。
上述推导从数学上保证了:
每次更新聚类中心 μk 时,损失函数 J 都会严格减小或保持不变(因为是通过求导找极小值点);
由于损失函数 J 是 "距离平方和",其取值下界为 0(不可能无限减小)
因此迭代过程必然收敛(即 J 最终会稳定在某个最小值,聚类中心不再变化)
示例
通过一个二维数据集的具体案例,完整演示 K-means 损失函数的推导和收敛性证明逻辑
(从结果反向推到)
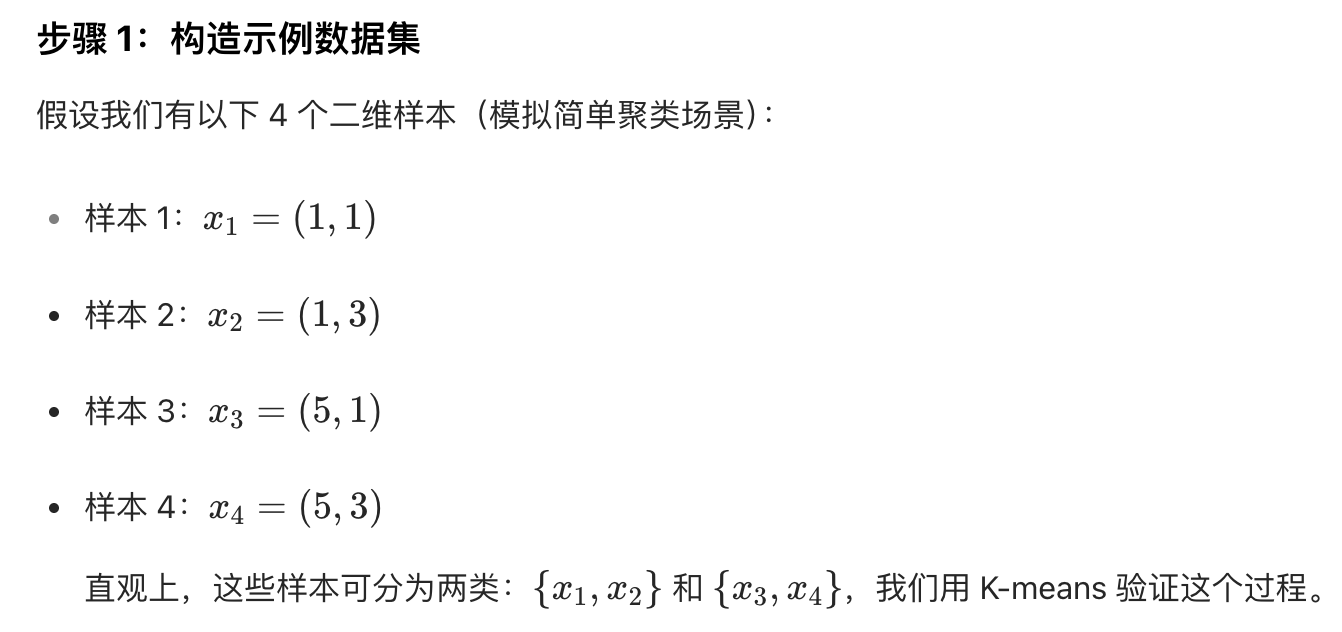
注意:步骤2中的x是个二维坐标
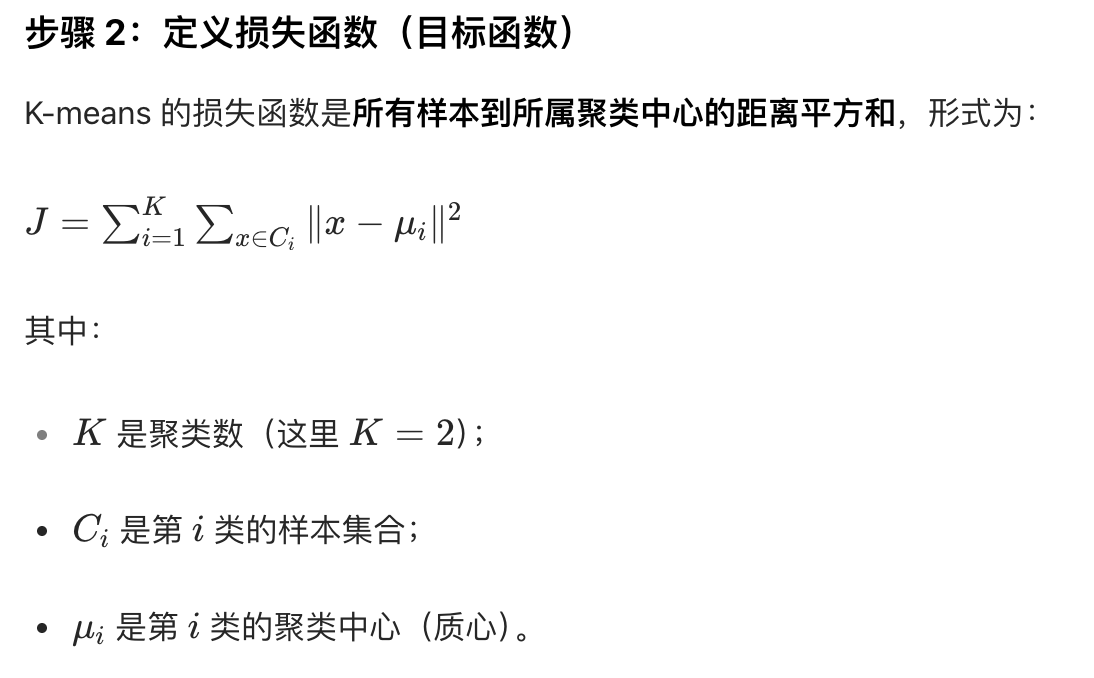
注意:下文的 x1 和 x2 指的是 x 的横坐标和纵坐标;uk1 和 uk2 指的是 uk 的横坐标和纵坐标
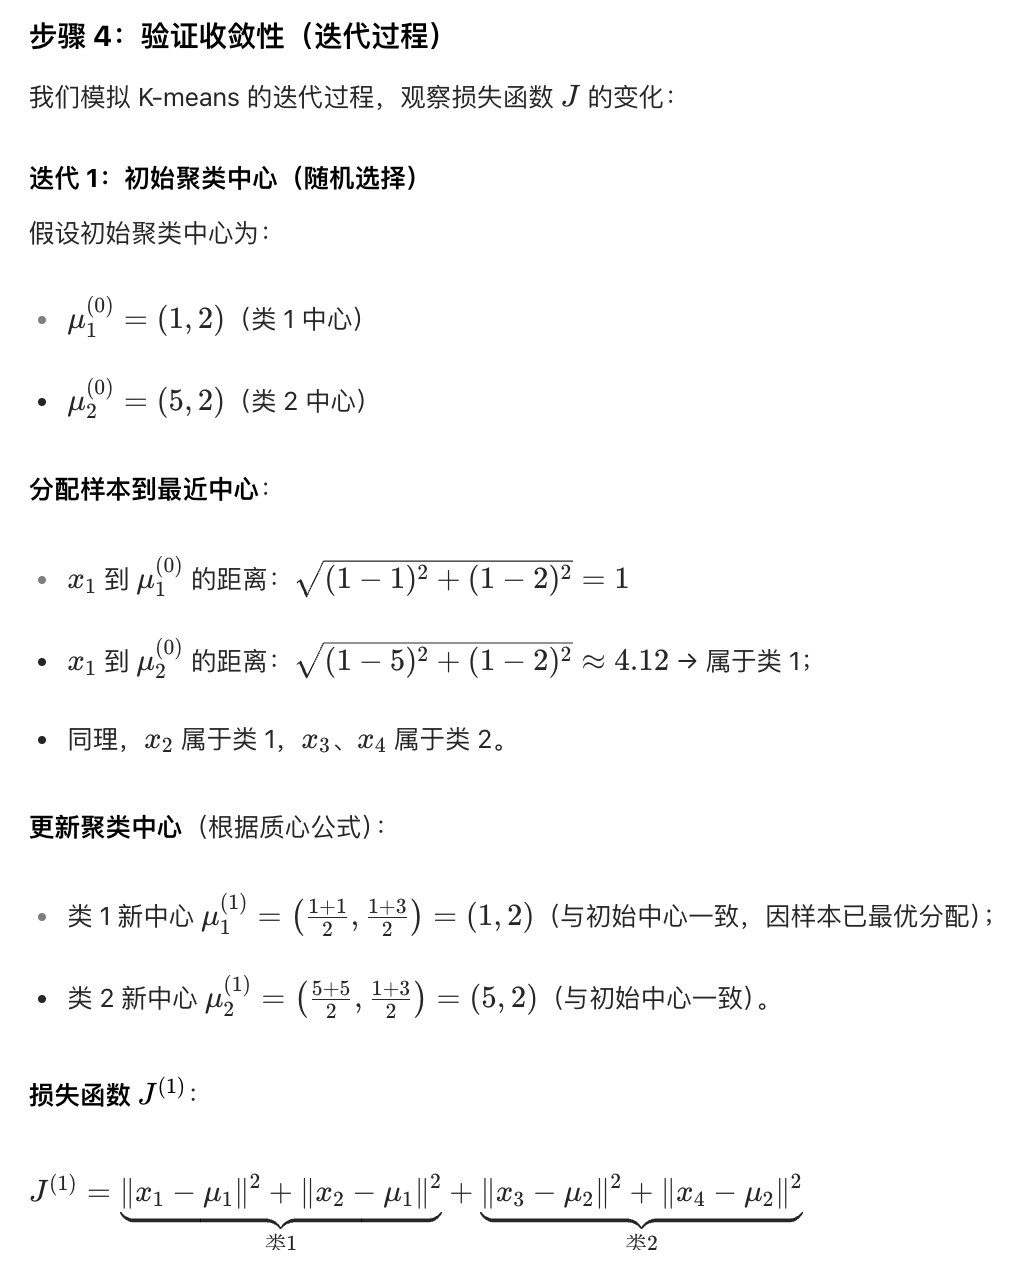
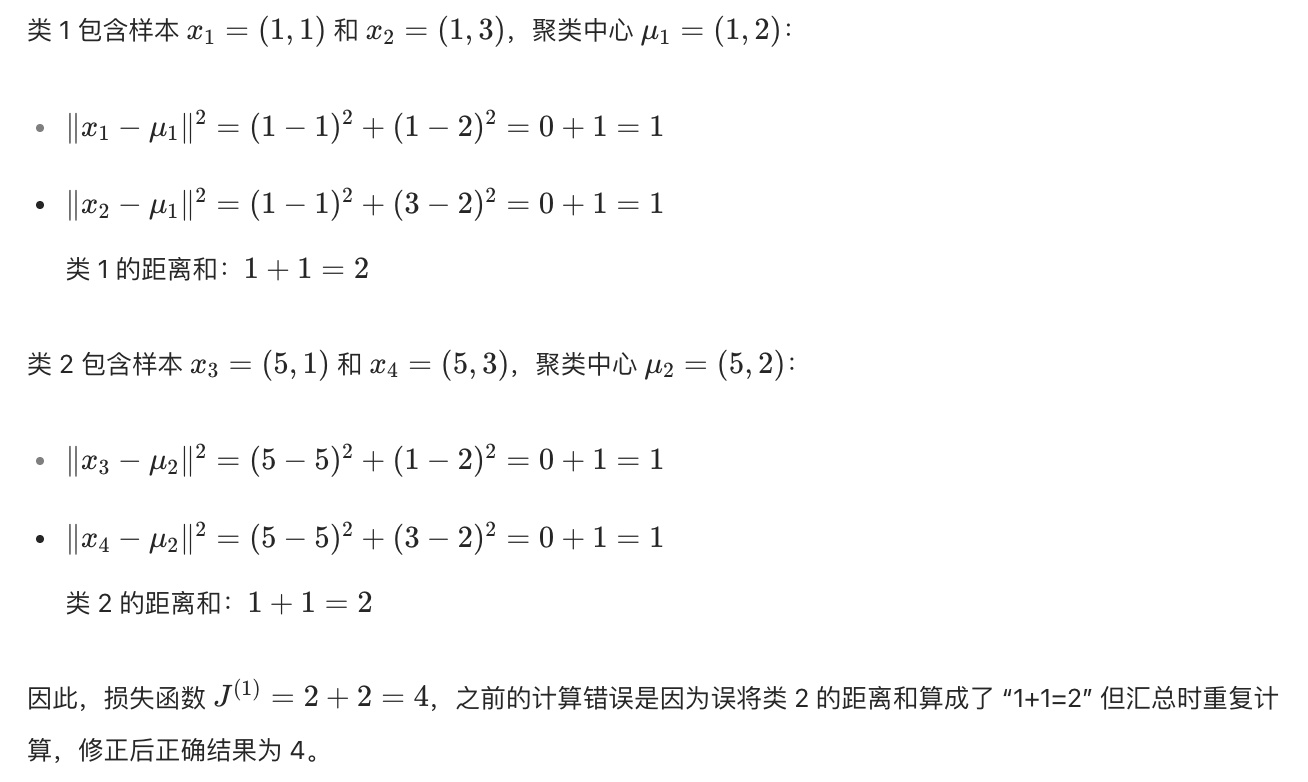
计算出来的结果为 4
迭代 2:聚类中心无变化,损失函数稳定
由于迭代 1 后聚类中心已无变化,样本分配也不再改变,损失函数 J 保持为 4,迭代终止
损失函数 J 从初始随机状态(若初始中心选得差,J 会更大)逐渐减小到 4 后稳定
每次更新聚类中心时,J 单调递减(或不变),且因下界为 0,迭代必然收敛
附录
什么是损失函数
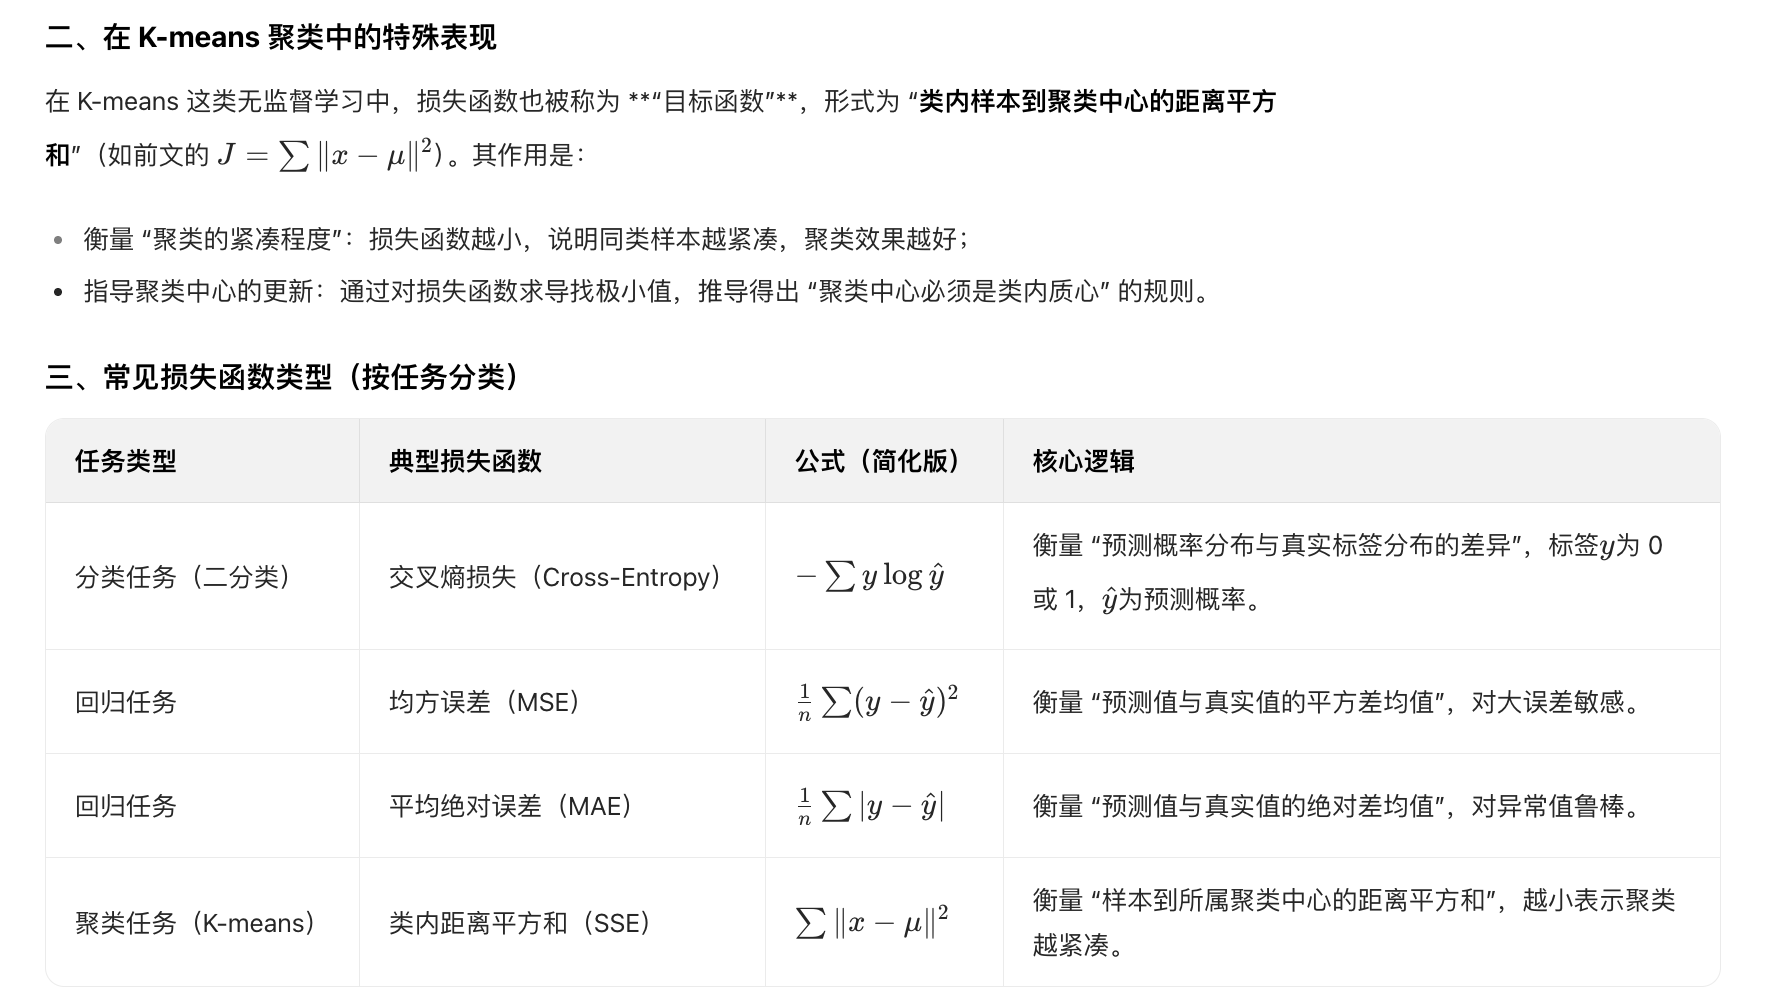
损失函数(Loss Function) 是机器学习和优化领域的核心工具,用于量化模型预测结果与真实结果的 "差异程度",是指导模型迭代优化的 "指南针"。
定义:损失函数是一个数学函数,输入为 "模型预测值" 和 "真实标签(或目标值)",输出为一个标量数值,该数值越大表示 "预测与真实的差异越大",模型性能越差。
核心作用:为模型优化提供方向------ 通过最小化损失函数,让模型的预测尽可能接近真实结果,从而提升泛化能力。
关键特性总结
单调性:预测与真实的差异越大,损失函数值越大
可导性:多数损失函数是可导的,这是 "梯度下降" 等优化算法能生效的前提
任务特异性:不同任务(分类、回归、聚类)需选择适配的损失函数,否则会导致优化方向错误
简言之,损失函数是 "模型性能的量化标尺",它将 "模型好不好" 转化为数学上的 "数值大小",让模型的优化过程可计算、可迭代。