一、环境准备
1.安装Jdk1.8
(1)Jdk1.8下载地址:https://www.oracle.com/java/technologies/downloads/archive/
将压缩包解压到/opt/目录
shell
tar zxf jdk-8u212-linux-x64.tar.gz -C /opt/(2)配置环境变量
编辑配置文件,vi /etc/profile,添加以下内容
shell
#jdk1.8.0_121
export JAVA_HOME=/opt/jdk1.8.0_212
export CLASSPATH=.:$JAVA_HOME/jre/lib/rt.jar:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar
export PATH=$PATH:$JAVA_HOME/bin
使环境变量生效
shell
source /etc/profile(3)添加jdk安全认证
引入如下三个包
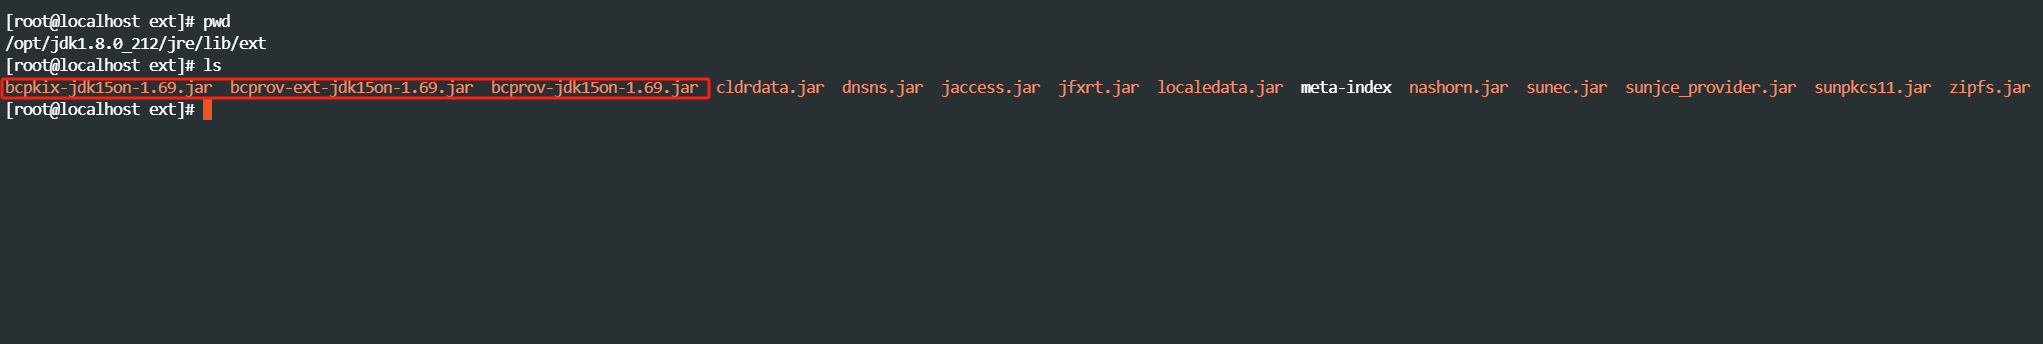
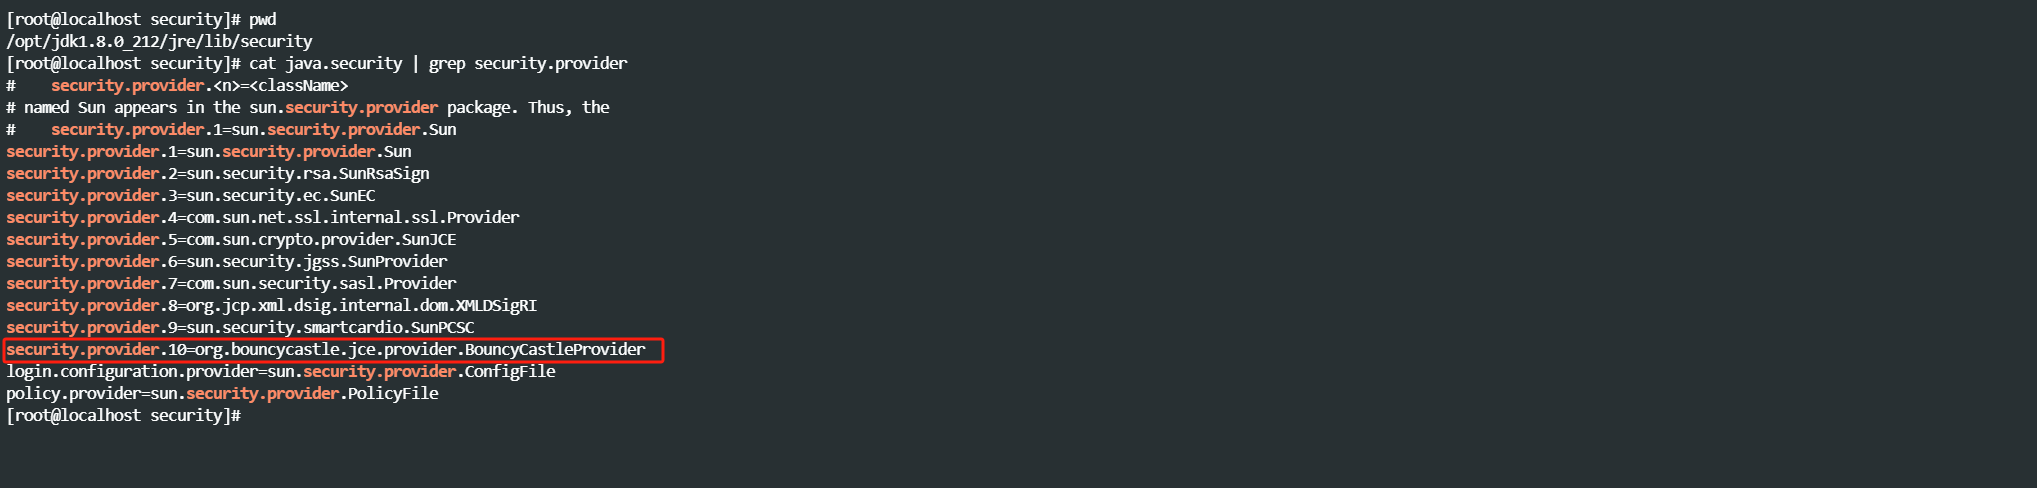
并在java.security文件中添加配置 security.provider.10=org.bouncycastle.jce.provider.BouncyCastleProvider
2、获取Spark安装包文件
(1)使用wget命令下载Spark v3.2.3安装包文件。
shell
wget https://archive.apache.org/dist/spark/spark-3.2.3/spark-3.2.3-bin-hadoop3.2.tgz(2)解压并重命名
shell
tar -zxvf spark-3.2.3-bin-hadoop3.2.tgz -C /opt/module
mv spark-3.2.3-bin-hadoop3.2 spark-3.2.3
3、初始化K8s环境
(1)创建metaSphere Namespace
编写metaSphere-namespace.yaml
shell
vi metaSphere-namespace.yaml
shell
apiVersion: v1
kind: Namespace
metadata:
  name: metasphere
  labels:
    app.kubernetes.io/name: metasphere
    app.kubernetes.io/instance: metasphere
提交yaml创建namespace
shell
kubectl apply -f metaSphere-namespace.yaml查看namespace
shell
kubectl get ns(2)创建ServiceAccount
编写spark-service-account.yaml
shell
vi spark-service-account.yaml
shell
apiVersion: v1
kind: ServiceAccount
metadata:
  namespace: metasphere
  name: spark-service-account
  labels:
    app.kubernetes.io/name: metasphere
    app.kubernetes.io/instance: metasphere
    app.kubernetes.io/version: v3.2.3
提交yaml创建ServiceAccount
shell
kubectl apply -f spark-service-account.yaml查看ServiceAccount
shell
kubectl get sa -n metasphere(3)创建Role和RoleBinding
编写spark-role.yaml
shell
vi spark-role.yaml
shell
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  labels:
    app.kubernetes.io/name: metasphere
    app.kubernetes.io/instance: metasphere
    app.kubernetes.io/version: v3.2.3
  namespace: metasphere
  name: spark-role
rules:
  - apiGroups: [""]
    resources: ["pods"]
    verbs: ["get", "watch", "list", "create", "delete"]
  - apiGroups: ["extensions", "apps"]
    resources: ["deployments"]
    verbs: ["get", "watch", "list", "create", "delete"]
  - apiGroups: [""]
    resources: ["configmaps"]
    verbs: ["get", "create", "update", "delete"]
  - apiGroups: [""]
    resources: ["secrets"]
    verbs: ["get"]
  - apiGroups: [""]
    resources: ["services"]
    verbs: ["get", "list", "create", "delete"]
---
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  labels:
    app.kubernetes.io/name: metasphere
    app.kubernetes.io/instance: metasphere
    app.kubernetes.io/version: v3.2.3
  name: spark-role-binding
  namespace: metasphere
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: Role
  name: spark-role
subjects:
  - kind: ServiceAccount
    name: spark-service-account
    namespace: metasphere
提交yaml创建Role和RoleBinding
shell
kubectl apply -f spark-role.yaml查看Role和RoleBinding
shell
kubectl get role -n metasphere
kubectl get rolebinding -n metasphere
(4)创建ClusterRole和ClusterRoleBinding
编写cluster-role.yaml
shell
vi cluster-role.yaml
shell
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
  labels:
    app.kubernetes.io/name: metasphere
    app.kubernetes.io/instance: metasphere
    app.kubernetes.io/version: v3.2.3
  name: apache-spark-clusterrole
rules:
  - apiGroups:
      - ''
    resources:
      - configmaps
      - endpoints
      - nodes
      - pods
      - secrets
      - namespaces
    verbs:
      - list
      - watch
      - get
  - apiGroups:
      - ''
    resources:
      - services
    verbs:
      - get
      - list
      - watch
  - apiGroups:
      - ''
    resources:
      - events
    verbs:
      - create
      - patch
---
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRoleBinding
metadata:
  labels:
    app.kubernetes.io/name: metasphere
    app.kubernetes.io/instance: metasphere
    app.kubernetes.io/version: v3.2.3
  name: apache-spark-clusterrole-binding
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: ClusterRole
  name: apache-spark-clusterrole
subjects:
  - kind: ServiceAccount
    name: spark-service-account
    namespace: metasphere
提交yaml创建ClusterRole和ClusterRoleBinding
shell
kubectl apply -f cluster-role.yaml查看ClusterRole和ClusterRoleBinding
shell
kubectl get ClusterRole | grep spark

kubectl get ClusterRoleBinding | grep spark
二、Spark On K8s基本测试
1、拉取apache spark镜像
到Docker Hub查找apache spark的镜像,并拉取到本地
shell
docker pull apache/spark:v3.2.3如果因为网络原因无法下载镜像,则使用以下镜像
shell
docker pull registry.cn-hangzhou.aliyuncs.com/cm_ns01/apache-spark:v3.2.32、查看k8s master的url
获取Kubernetes control plane URL
shell
kubectl cluster-info3、提交Spark程序到K8s上运行
shell
/opt/module/spark-3.2.3/bin/spark-submit \
 --name SparkPi \
 --verbose \
 --master k8s://https://localhost:6443 \
 --deploy-mode cluster \
 --conf spark.network.timeout=300 \
 --conf spark.executor.instances=3 \
 --conf spark.driver.cores=1 \
 --conf spark.executor.cores=1 \
 --conf spark.driver.memory=1024m \
 --conf spark.executor.memory=1024m \
 --conf spark.kubernetes.namespace=metasphere \
 --conf spark.kubernetes.container.image.pullPolicy=IfNotPresent \
 --conf spark.kubernetes.container.image=registry.cn-hangzhou.aliyuncs.com/cm_ns01/apache-spark:v3.2.3 \
 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark-service-account \
 --conf spark.kubernetes.authenticate.executor.serviceAccountName=spark-service-account \
 --conf spark.driver.extraJavaOptions="-Dio.netty.tryReflectionSetAccessible=true" \
 --conf spark.executor.extraJavaOptions="-Dio.netty.tryReflectionSetAccessible=true" \
 --class org.apache.spark.examples.SparkPi \
 local:///opt/spark/examples/jars/spark-examples_2.12-3.2.3.jar \
 3000
参数说明:
--master为Kubernetes control plane URL
--deploy-mode为cluster,则driver和executor都运行在K8s里
--conf spark.kubernetes.namespace为前面创建的命名空间metasphere
--conf spark.kubernetes.container.image为Spark的镜像地址
--conf spark.kubernetes.authenticate.executor.serviceAccountName为前面创建的spark-service-account
--class为Spark程序的启动类
local:///opt/spark/examples/jars/spark-examples_2.12-3.2.3.jar为Spark程序所在的Jar文件,spark-examples_2.12-3.2.3.jar是Spark镜像自带的,所以使用local schema
3000是传入Spark程序的启动类的参数
4、观察driver pod和executor pod
shell
watch -n 1 kubectl get all -owide -n metasphere5、查看日志输出
shell
kubectl logs sparkpi-b9de1a887b1163f1-driver -n metasphere6、清理Driver Pod
shell
kubectl delete pod sparkpi-b9de1a887b1163f1-driver -n metasphere