论文链接:https://arxiv.org/pdf/2509.26641
亮点直击
Query-Kontext,一种经济型集成多模态模型(UMM),能够将视觉语言模型(VLMs)中的多模态生成推理与扩散模型执行的高保真视觉渲染相分离。
提出了一种三阶段渐进式训练策略,该策略逐步将 VLM 与越来越强大的扩散生成器对齐,同时增强它们在生成推理和视觉合成方面的各自优势。
提出了一种精心策划的数据集收集方案,以收集真实、合成和经过仔细筛选的开源数据集,涵盖多样的多模态参考到图像场景。
总结速览
解决的问题
当前的统一多模态模型在文本生成图像(T2I)和图像编辑(TI2I)中,生成推理和高保真合成的能力往往纠缠在一起,难以在保持身份和忠实重建的同时实现高质量的视觉合成。
提出的方案
引入了 Query-Kontext 方法,通过多模态"kontext"将视觉语言模型(VLM)与扩散模型连接起来。这种设计将多模态生成推理的复杂能力交给 VLM,而扩散模型负责高质量视觉合成。
应用的技术
-
三阶段渐进式训练策略:
-
使用多模态 kontext token 将 VLM 连接到轻量级扩散头,释放 VLM 的生成推理能力。
-
扩展到大型预训练扩散模型,增强视觉细节和真实感。
-
引入低级图像编码器,提高图像保真度,并执行指令调优。
-
-
数据集收集方案:
- 构建综合数据 Pipeline ,整合真实、合成和开源数据集,涵盖多样的多模态参考到图像场景。
达到的效果
实验结果显示,该方法在多个基准测试中与强大的统一基线相匹配,甚至在某些情况下超越了任务特定的最先进方法。
Query-Kontext
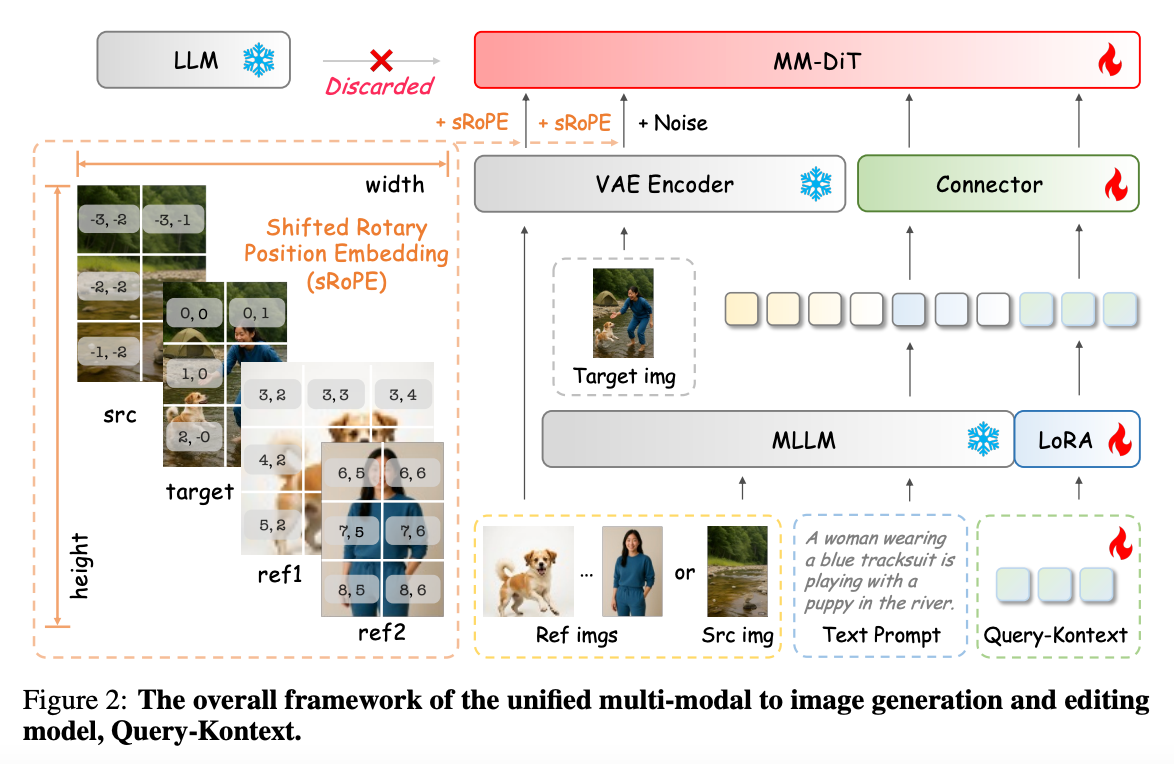
本工作提出了 Query-Kontext,这是一种用于图像生成和编辑的统一多模态模型,它将多模态生成推理委托给 VLM,同时保留扩散模型用于高质量视觉合成的能力。在本节中,首先,展示了 Query-Kontext 模型的架构设计(下图 2)。然后,设计了一个三阶段渐进学习策略,并介绍了训练配方的详细信息(下图 3)。最后,介绍了模型超参数和基础设施的实现细节。
架构
如上图 2 所示,Query-Kontext 由四个主要组件组成:多模态大语言模型(MLLM)、连接模块、多模态扩散transformer (MMDiT)和低级图像编码器(VAE)。MLLM 以 Qwen2.5-VL 模型初始化,该模型编码并融合包括文本提示、输入图像和一组可学习查询 token 在内的多模态输入。输出是一个固定长度的 kontext token 序列 ,它为扩散解码器提供粗粒度的图像级条件,同时提供高级语义线索。直观地,kontext token 编码了输出图像中应该出现的内容(来自文本提示的语义信息)以及输出应该如何结合提供的输入图像中的视觉线索,这由下文中的训练监督所强制执行。kontext 和文本 token 通过一个轻量级连接模块传递,以将它们与扩散模型的潜在空间对齐。在实践中,本文将连接器生成的文本嵌入与 kontext 嵌入连接,从而丰富了扩散模型可用的语义上下文。
本文使用自家的 MMDiT 模型初始化扩散模型,并用 MLLM 替换其原始文本编码器(有关此对齐的训练细节在下文中讨论)。将来自 MLLM 的文本序列 和 kontext token 与以下内容连接:(i) 当前扩散步骤 的噪声图像潜在变量,以及 (ii) 由 VAE 从输入图像中提取的低级视觉特征 token。连接后的序列以上下文方式输入到 MMDiT 模型中,使扩散模型能够关注文本提示和输入图像的视觉线索。
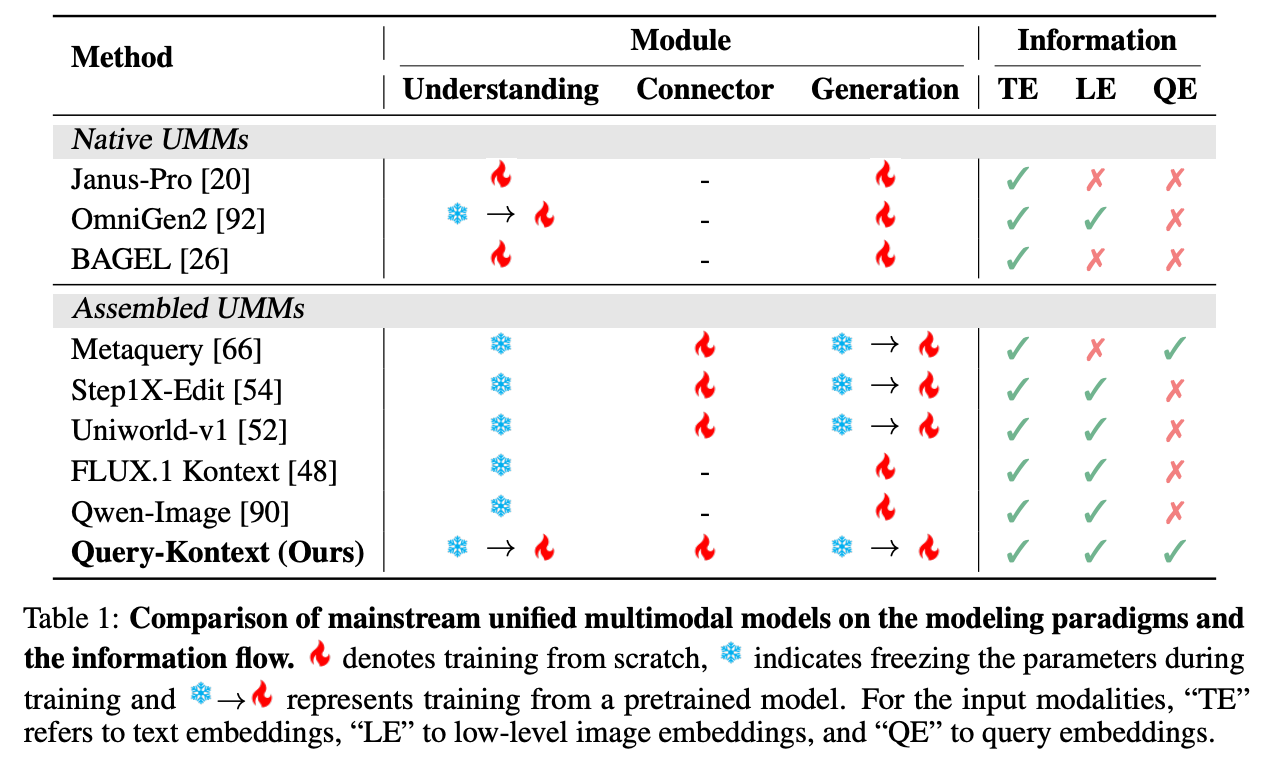
此外,在下表 1 中区分了原生 UMM 和组合 UMM。比较突出了每个模型是从头开始训练、冻结参数还是调整预训练组件,并指定了通过文本嵌入(TE)、低级图像嵌入(LE)和查询嵌入(QE)的信息流动。特别是,查询嵌入自然释放了 VLM 的上下文学习能力,使模型能够对多模态输入进行推理并生成连贯的图像。与之前的方法不同,本文的 Query-Kontext 将查询嵌入与文本和低级图像嵌入集成,同时有效地解耦理解和生成模块,以提高效率和灵活性。
此外,设计了一种偏移的二维旋转位置嵌入(RoPE)方案,以结合多图像位置条件并避免多个参考图像之间的混淆(如上图 2 所示)。在标准扩散架构中,隐空间特征图的每个空间位置(大小为 )由二维索引 标识,其中 和 。本文引入了一个特定任务的先验,以根据输入图像的保真度要求调整这些坐标。对于需要像素级保真度的任务(例如基于指令的编辑),本文将输入图像视为源图像,记为 。对于需要身份保持的任务(例如个性化生成或多图像合成),本文将输入图像视为参考图像,记为 。然后本文相应地调整每种图像类型的 VAE 潜在坐标索引:对于参考图像潜在变量,本文将索引移到正象限,而对于源图像潜在变量,本文将索引移到负象限。本文定义第 个参考潜在变量的坐标为:
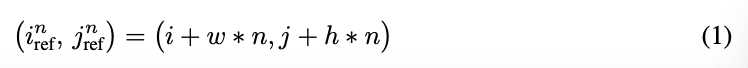
其中 , 且 。同时,对于源图像潜在变量,本文将坐标向负方向偏移。

其中 , 且 。最后,本文在输入图像潜在变量的特征图和噪声潜在变量的各自偏移坐标上添加偏移的 RoPE(即,逐元素添加到每个空间位置)。
个性化教学课程
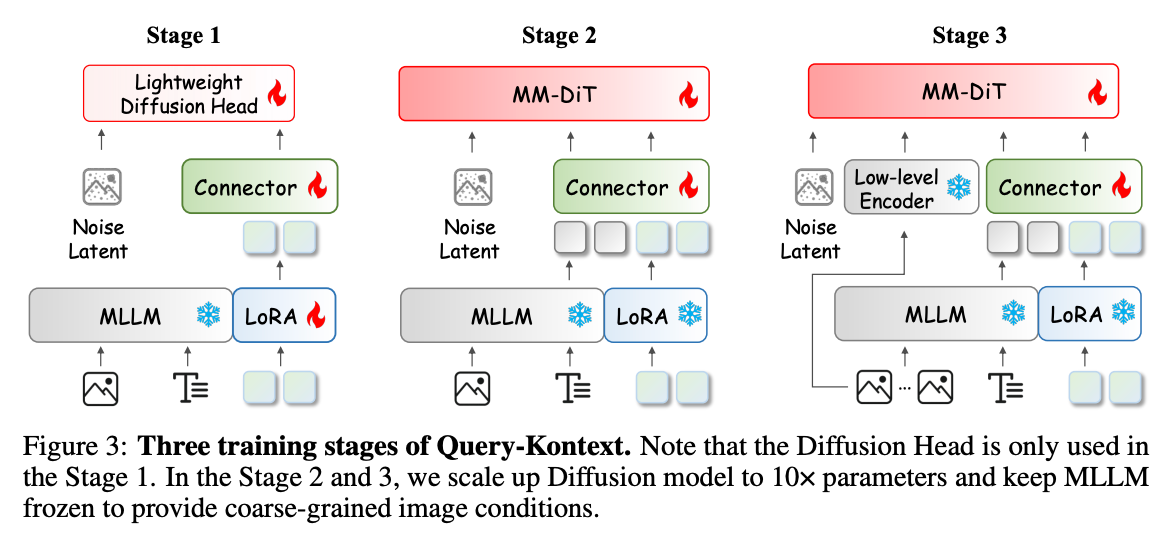
如上图 3 所示,本文提出了一种三阶段渐进训练策略,既解锁了 VLM 的生成推理能力,又逐步将其与日益强大的扩散生成器对齐。因此,由多模态 kontext token 引导的 Query-Kontext,有效地将 VLM 的多模态生成推理与由扩散模型执行的高保真视觉渲染分离开来。
阶段 1:本文通过两个关键的架构设计释放 MLLM 的生成推理潜力:首先使用可学习的查询 token ("kontext")来表示语义线索和粗粒度图像条件的混合,然后将输出的 kontext token 与执行粗粒度噪声预测的轻量级扩散头对齐。本文在三个任务上训练连接器、扩散头和 MLLM 的 LoRA 模块的所有参数:文本生成图像、图像重建和图像转换(见下文)。这种训练方法在保留 MLLM 固有的语言-视觉理解的同时,培养其新兴的多模态生成推理能力。
阶段 2:接下来,本文用基于 MMDiT 架构的自家扩散模型替换轻量级扩散头,以实现高保真生成。在阶段 2 中,MLLM 的所有参数(LoRA 参数合并到 MLLM 中)保持冻结状态,本文优化 kontext token 、连接器和大扩散模型的所有参数。在初步实验中,本文观察到完全冻结扩散模型对较小的头部是可行的,但对较大的扩散模型则不行(实验细节和讨论见后文)。因此,本文允许扩散模型在此阶段进行全参数微调。为了保持训练效率,Query-Kontext 在此阶段仅在文本生成图像和图像重建任务上进行训练,这加速了从 MLLM 到扩散模型的快速对齐,降低了训练成本。
阶段 3:最后,本文引入专用的低级图像编码器用于源或参考图像,以进一步优化扩散模型的高保真图像引用。在阶段 3 中,MLLM 保持完全冻结,本文仅优化 Query-Kontext token 和连接器。此外,本文对扩散模型本身应用基于 LoRA 的微调,以在扩展到本文所有任务的同时保持其高质量图像合成能力。这不仅包括标准的文本生成图像,还包括指令引导的图像编辑、用户定制的图像生成和多主体组合任务。
实现
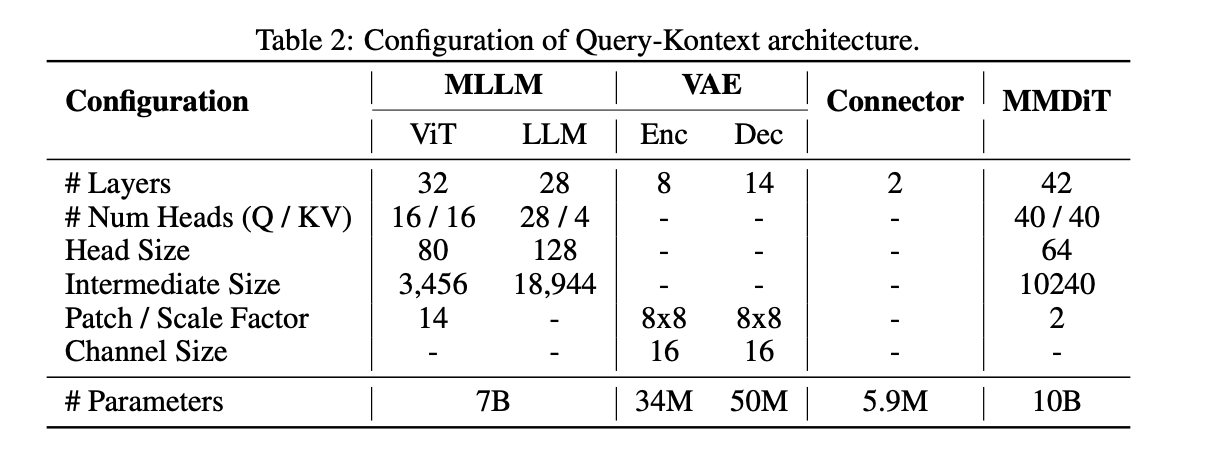
架构。本文从 Qwen2.5-VL-7B 初始化 MLLM,并将连接器实现为一个两层的 MLP。(架构配置的详细信息在下表 2 中提供。)连接器将文本和 kontext token 映射到扩散潜在空间;输出在输入到扩散 transformer 之前进行拼接。此外,本文在阶段 a 中使用轻量级 MMDiT 架构(约 870M 参数)实现扩散头。本文在 Query-kontext 中设置最大参考图像 和 ,即 。本文在扩散模型中设置秩 ,,在 MLLM 的 LoRA 中设置秩 ,。
训练方案。分辨率为 的默认配置在表 3 中提供。在阶段 3 之后,本文引入一个分辨率升级阶段,使用相同的混合多任务数据集在更高分辨率下进行。在此阶段,训练分辨率增加到 ,学习率进一步降低到 ,并在全局批量大小为 256 的情况下继续训练 3,000 步。
基础设施。在训练期间,本文采用混合并行优化策略。在 VLM 端启用张量并行。对于扩散模型,本文使用参数分片(ZeRO Stage-2)以及 bfloat16(BF16)混合精度训练。为了在小批量内保持序列长度一致,本文根据图像长宽比(支持 1:1, 1:2, 2:3, 3:4, 3:5, 4:5 和 9:16)和参考图像数量维护两个独立的分桶器,以便同一批次中的样本产生相同数量的潜在 token ,减少填充并提高吞吐量。本文构建了一个多模态参考到图像的数据集(如下表 4 所总结),由真实、合成和精心策划的开源数据集混合而成。该数据集涵盖五类任务:文本生成图像、图像转换、指令编辑、定制生成和多主体组合。
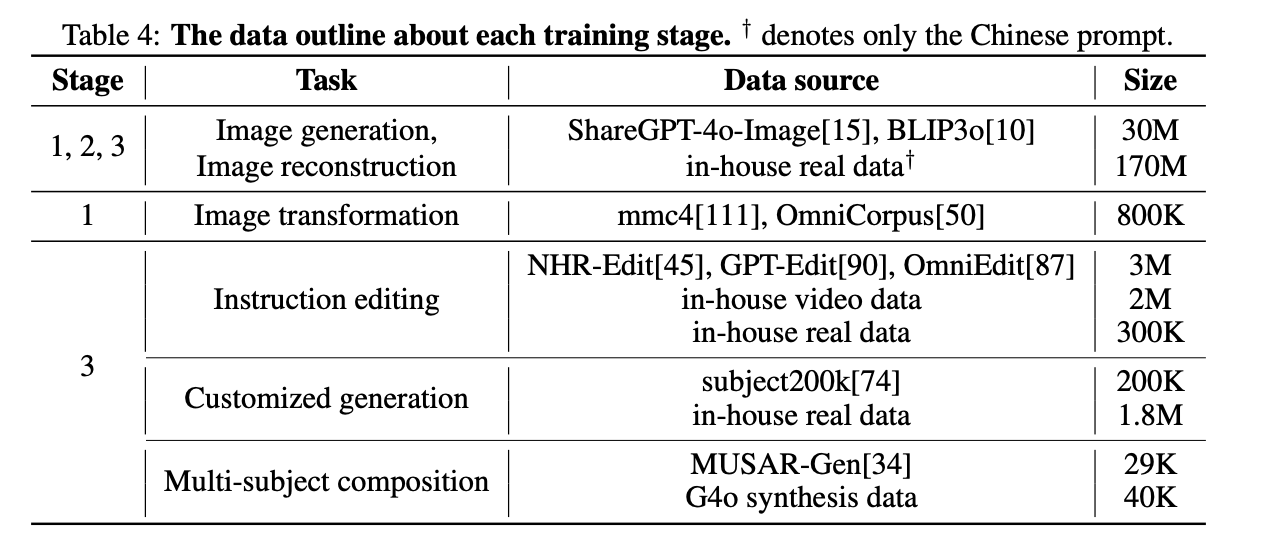
文本生成图像和图像重建。 本文收集了3000万对开源的英文图像-文本对(包括ShareGPT-4o-Image、BLIP-3o等)以及1.7亿对内部生成的中文图像-文本对,用于文本生成图像和图像重建任务。内部数据经过广泛的质量过滤,基于图像分辨率、清晰度、美学评分、水印检测和安全合规性。在这些中文数据中,1.5亿属于一般类别(在不同领域之间平衡),2000万来自特定的垂直领域(例如,艺术风格、标志、汽车、包含文本的图像、名人、海报等)。
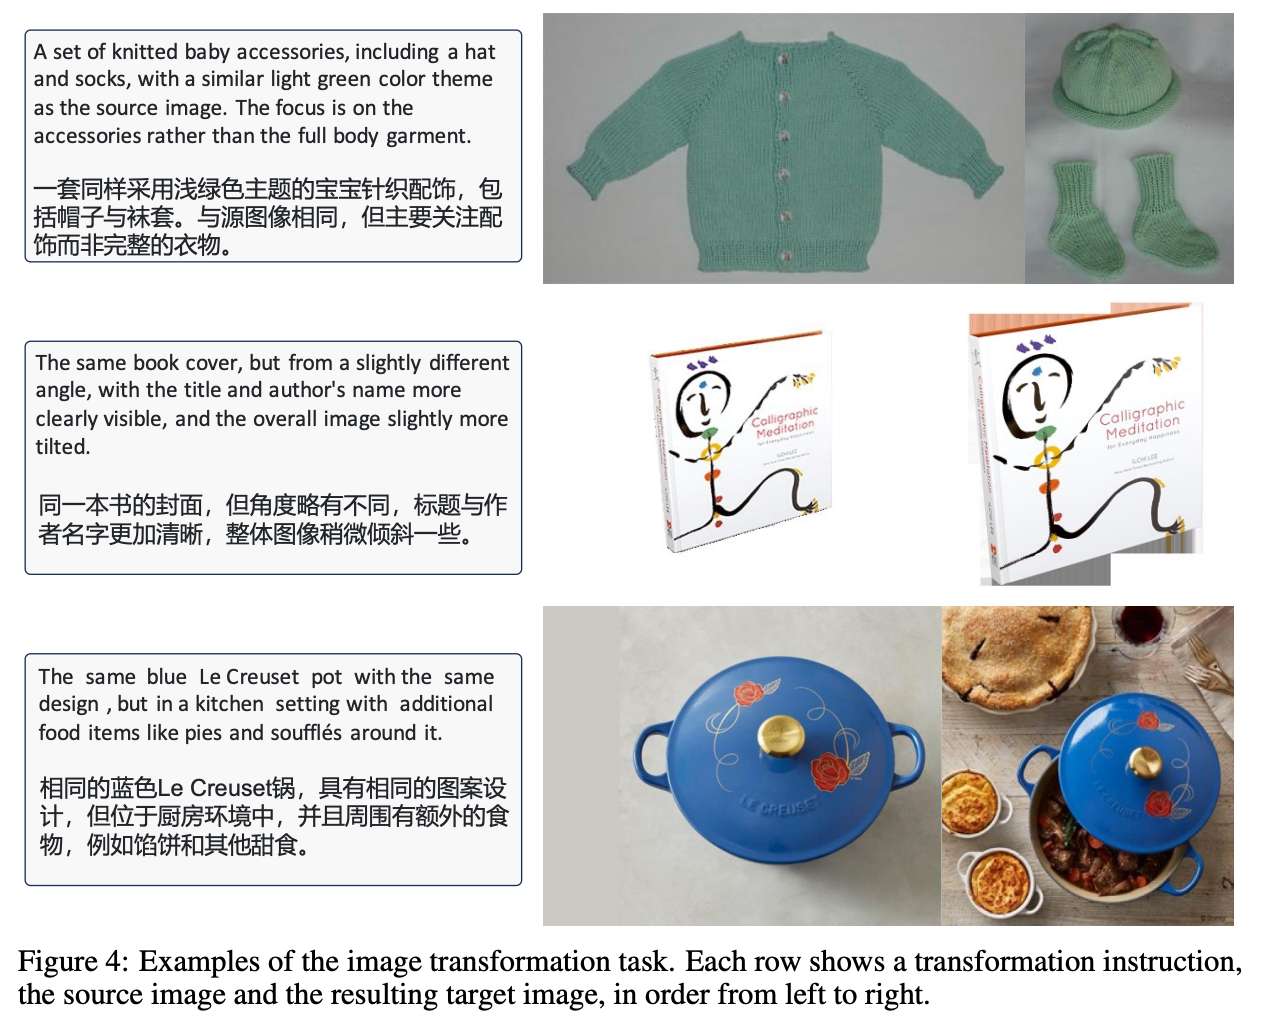
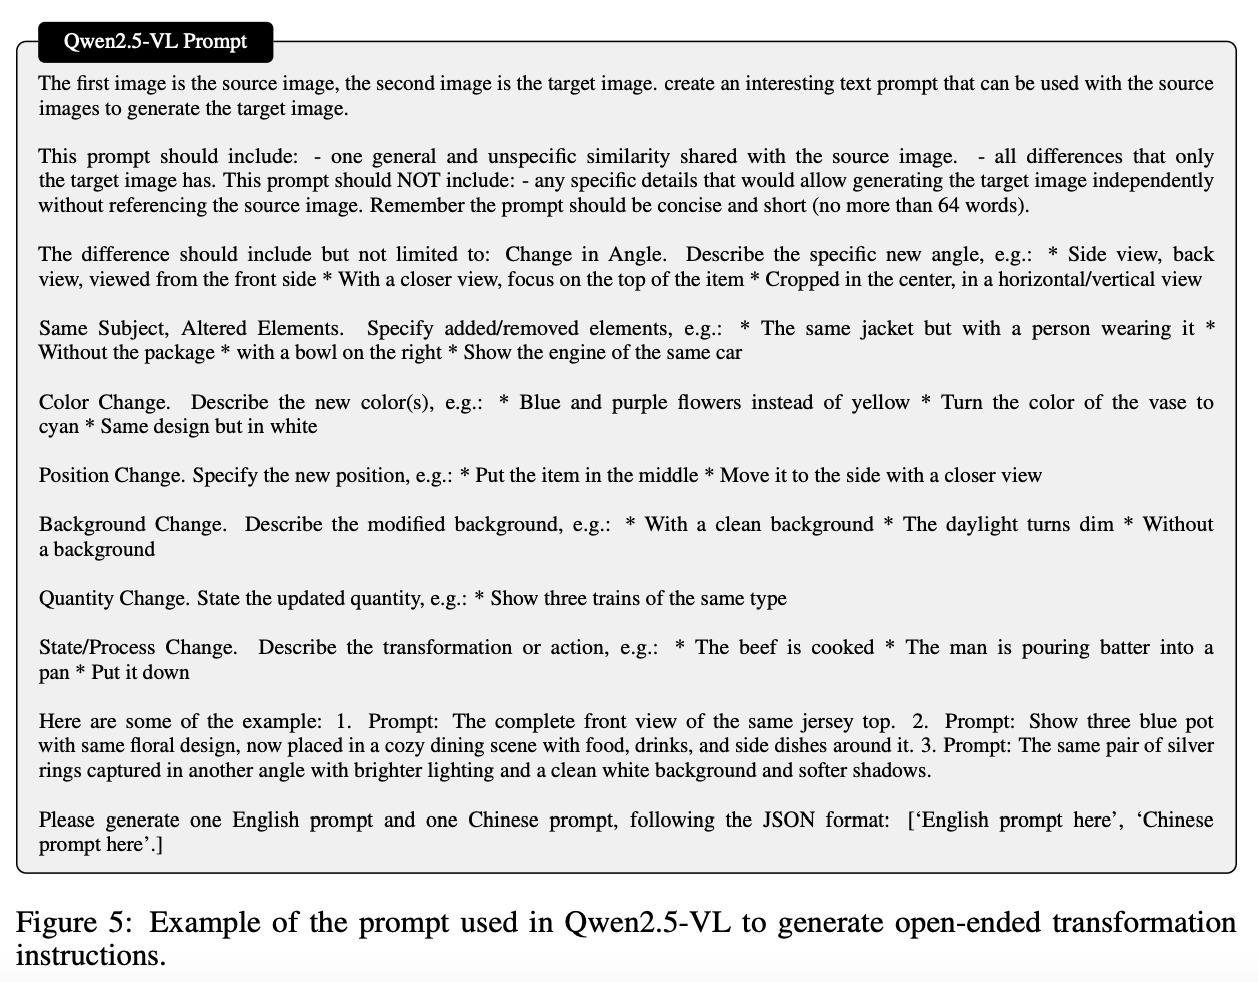
图像转换。 遵循MetaQuery的方法,本文从网络语料库中构建了自然发生的图像对,并利用多模态大语言模型(MLLMs)生成相应的开放式转换指令。具体而言,本文使用SigLIP图像特征对来自MMC4-core、OmniCorpus-CC和OmniCorpus-CW等来源的共享相同说明的图像进行聚类,然后通过相似性阈值过滤这些聚类,获得80万图像转换三元组。如下图4所示,每个三元组包含一个源图像、一个由Qwen2.5-VL生成的开放式转换指令(如下图5所示)和一个目标图像。指令涵盖视角变化(例如,放大/缩小、旋转)、外观修改(例如,颜色/材料替换)和结构调整(例如,添加/移除物体)。
指令编辑。 对于图像编辑指令任务,本文首先从开源数据集中收集了大约300万图像-指令-图像三元组,包括NHR-Edit(358k样本)、GPT-Image-Edit(1.5M样本)、MagicBrush(10k样本)和OmniEdit(1.2M样本)。本文进一步使用基于CLIP的图像和文本相似性评分过滤MagicBrush子集,并使用大语言模型将所有数据集的指令翻译成中文。
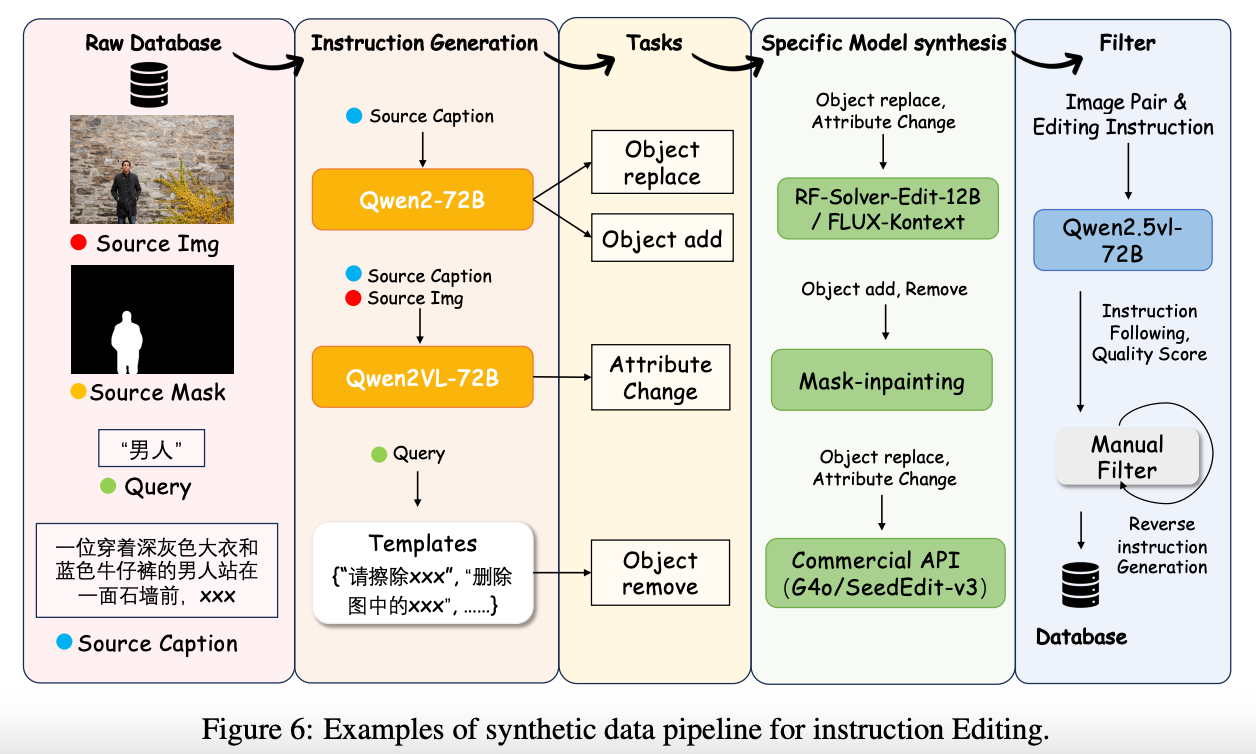
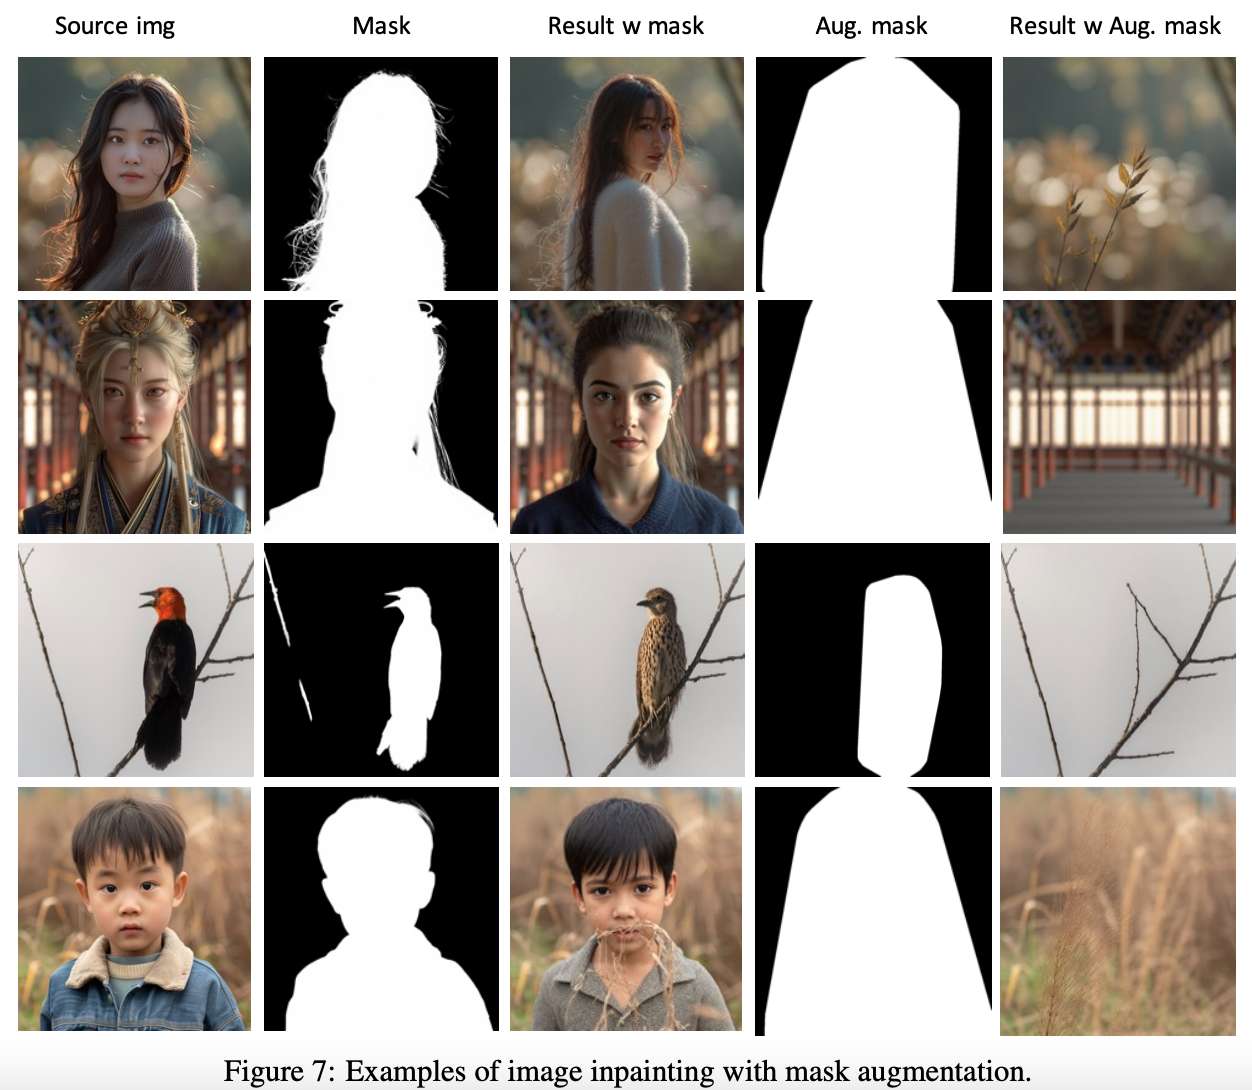
基于现有方法,构建了一个合成数据 Pipeline,专门用于本地中文指令编辑,生成了额外的30万高质量三元组。如下图6所示。给定一个源图像、其分割掩码和一个说明,本文首先提取对象级查询(例如,"人")并生成多样化的编辑指令。具体而言,大语言模型(Qwen2-72B)从说明中生成文本编辑提示,而多模态模型(Qwen2VL-72B)利用说明和图像生成更细粒度的属性修改指令。此外,本文引入基于模板的指令(例如,"从图像中移除xxx")来进一步处理对象移除任务。生成的指令被分类为四种任务类型:对象替换、对象添加、对象移除和属性修改。每个任务由专门的合成模型处理:RF-Solver-Edit-12B或FLUX-Kontext用于替换和属性编辑,基于掩码的修复模型用于添加和移除,以及商业API(例如,G4o/SeedEdit-v3)用于更复杂的操作。最后,生成的三元组通过自动评估阶段进行过滤,使用Qwen2.5VL-72B对指令的保真度和图像质量进行评分,然后进行人工验证以确保可靠性。最后,通过将源图像作为目标应用手动反向指令生成,确保来自真实图像的监督而无模型引起的伪影。此外,在应用掩码修复模型移除大型物体时,本文采用掩码增强策略以减轻形状引导掩码的影响。下图7展示了有无掩码增强的结果比较。
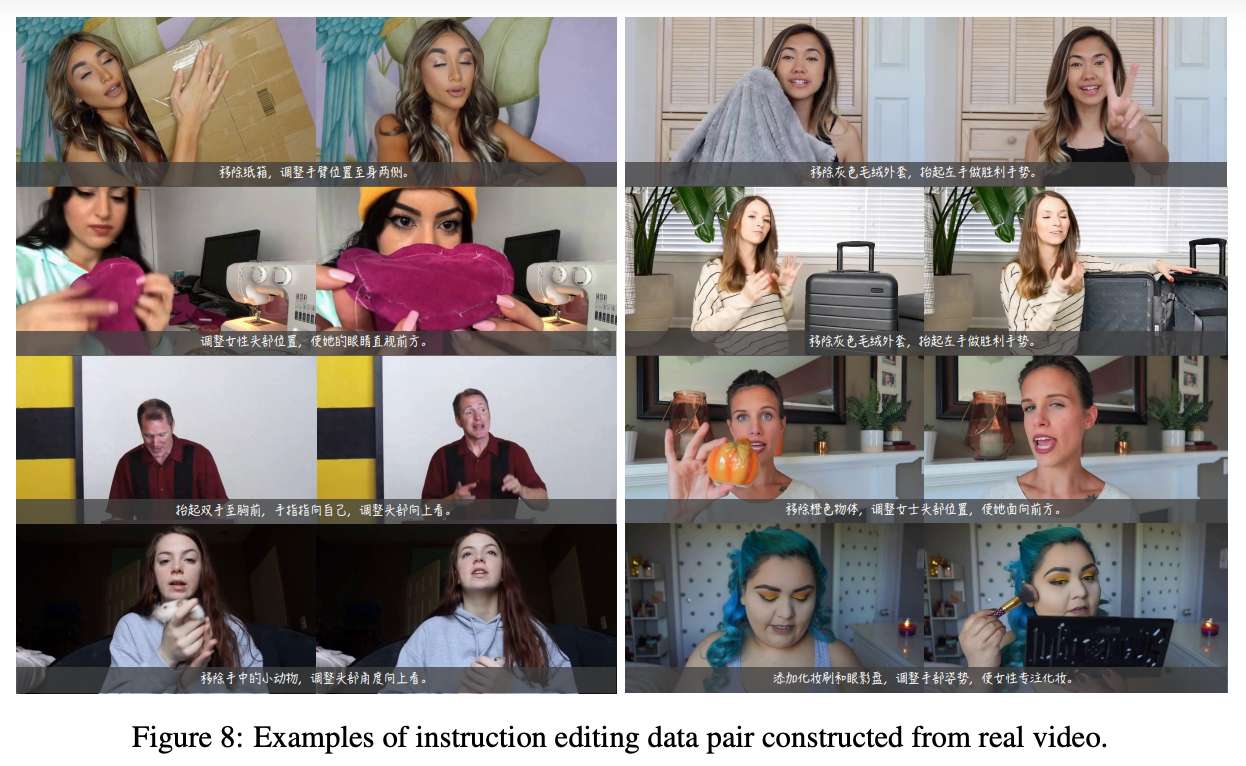
最后,受UniReal的启发,本文扩展了数据集,使用从原始视频中提取的视频集群,以涵盖更多非刚性编辑任务(例如,运动变化、视角转换,如放大和缩小)。代表性数据示例见下图8。
定制化生成。 本文利用开源的Subject-200K和UNO-1M数据集进行定制化(主体驱动)图像生成。此外,本文使用专用模型合成的肖像参考三元组来增强数据,该模型生成特定个体的参考图像。通过这种方法,本文累积了大约30万张肖像参考样本,这些样本在保持与源主体高度面部相似的同时,在姿势、服装和其他属性上展示了相当大的多样性。
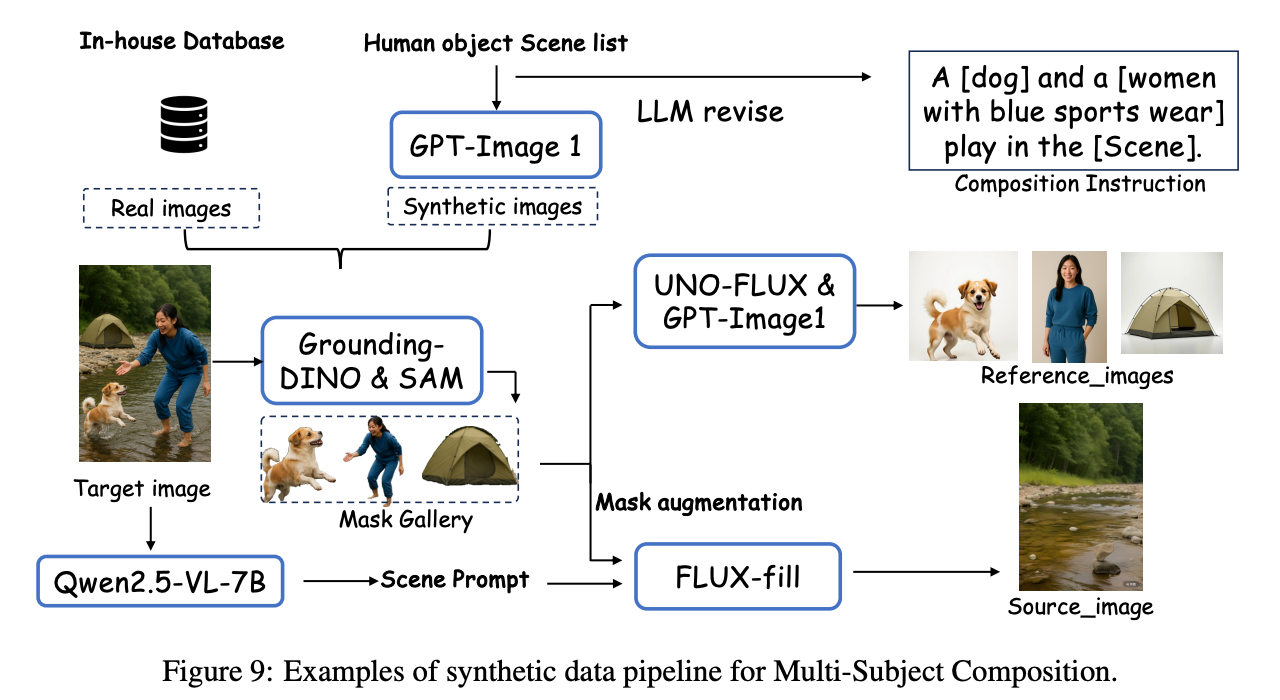
多主体合成。 最后,本文使用开源的MUSAR-Gen数据集和一个新的合成数据 Pipeline 解决多主体图像合成问题。如下图9所示,本文设计了一个合成 Pipeline 来构建高质量的多主体合成数据。从内部数据库开始,本文结合真实和合成图像,并生成由大语言模型进一步优化的人物-物体-场景列表,以产生自然的合成指令。Grounding-DINO和SAM用于提取对象级掩码并构建掩码库,为后续合成提供结构指导。主体和物体的参考图像由UNO-FLUX和GPT-Image1合成,而场景背景由掩码修复模型生成。生成的目标图像与相应的合成指令和场景提示一起,形成多样化的训练三元组,增强了多主体场景的覆盖。这产生了4万个多主体参考示例,每个示例都包含多个人物、物体和复杂场景的合成,从而丰富了数据集对现实多实体交互的覆盖。
实验
定量结果
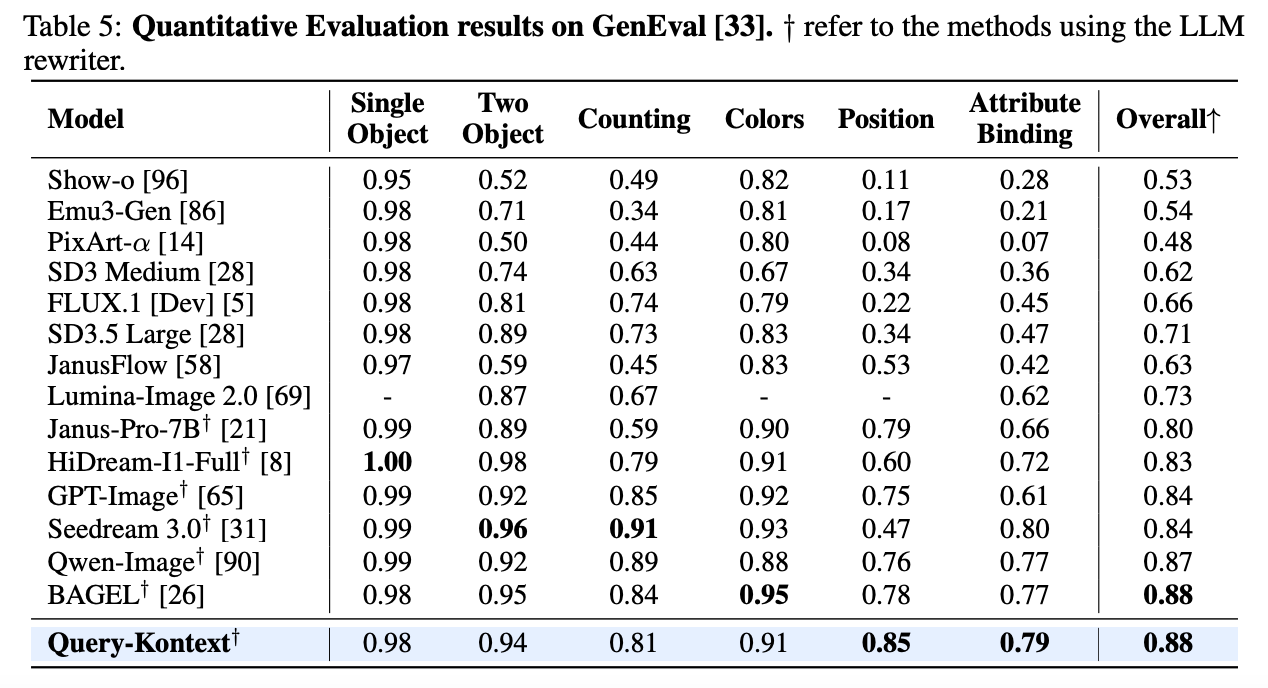
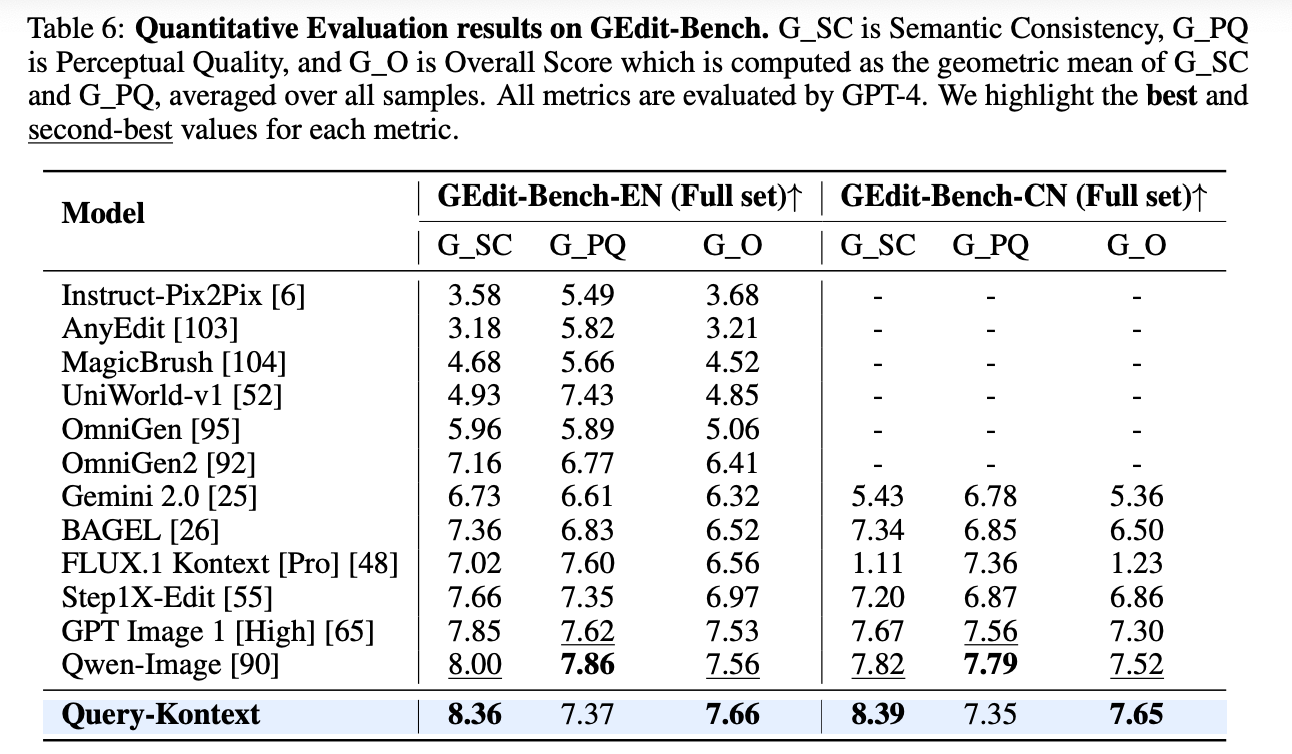
本文在一套全面的基准测试中评估了Query-Kontext,涵盖文本生成图像、指令引导编辑、主体驱动定制和多主体合成。具体而言,本文报告了在GenEval、GEdit-Bench、DreamBooth和DreamBench上的结果。在GenEval上,Query-Kontext取得了0.88的总分,与统一UMM(BAGEL)达到的SOTA结果相匹配,如下表5所示。本文的结果基于由DeepSeek重写的中文提示。在GEdit-Bench上,Query-Kontext在指令引导编辑中取得了最高的整体表现,英文部分得分为7.66,中文部分得分为7.65。这些结果超过了Qwen-Image(7.56 / 7.52)和GPT-Image(7.53 / 7.30),如下表6所示。
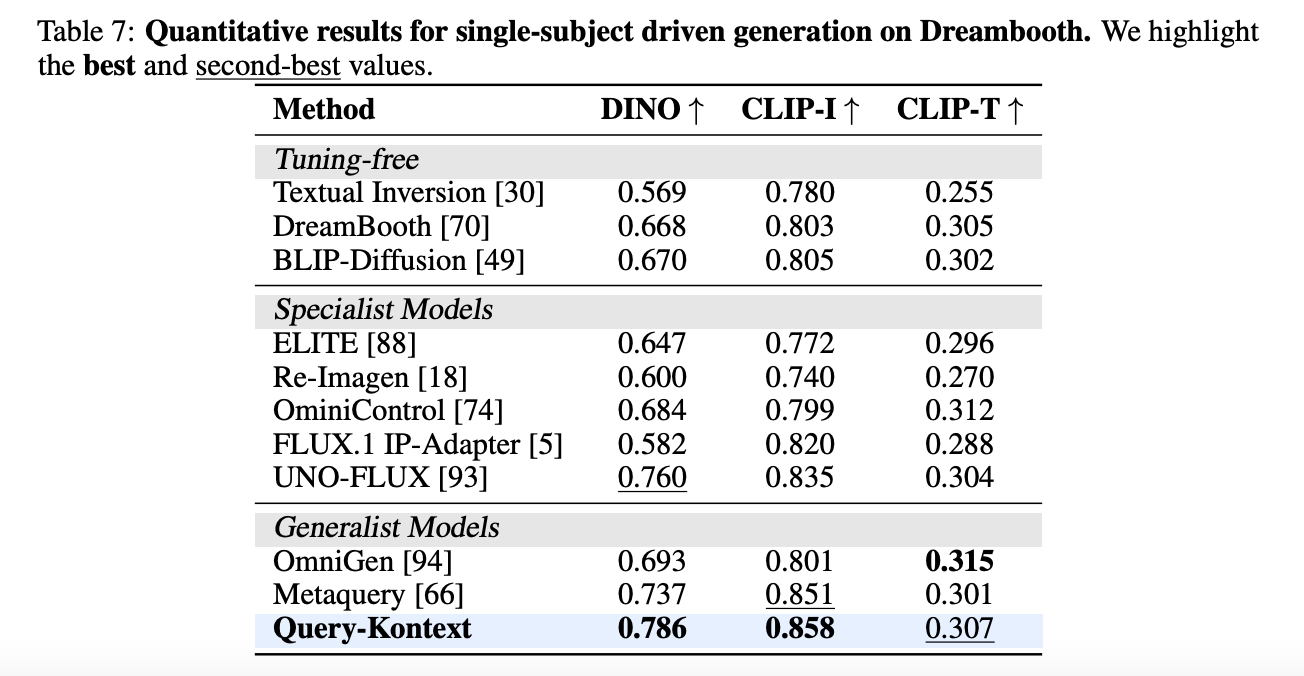
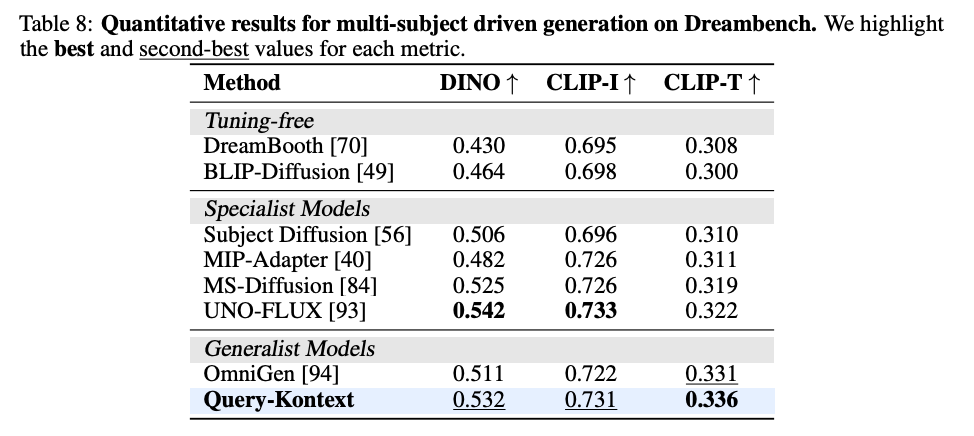
此外,注意到感知质量得分存在一些缺陷,主要是因为缺乏旨在增强生成质量或真实感的强化学习或监督微调阶段。本文将在未来的工作中进行这方面的探索。在DreamBooth上的主体驱动生成中,Query-Kontext以DINO 0.786和CLIP-I 0.858建立了新的最先进结果,显著超过了Metaquery(0.737 / 0.851)和UNO-FLUX(0.760 / 0.835),尽管CLIP-T略低(0.307对比OmniGen的0.315),如下表7所示。在下表8中,Query-Kontext在多主体合成基准DreamBench上取得了最佳CLIP-T得分(0.336),以及具有竞争力的DINO(0.532)和CLIP-I(0.731)结果。
定性结果
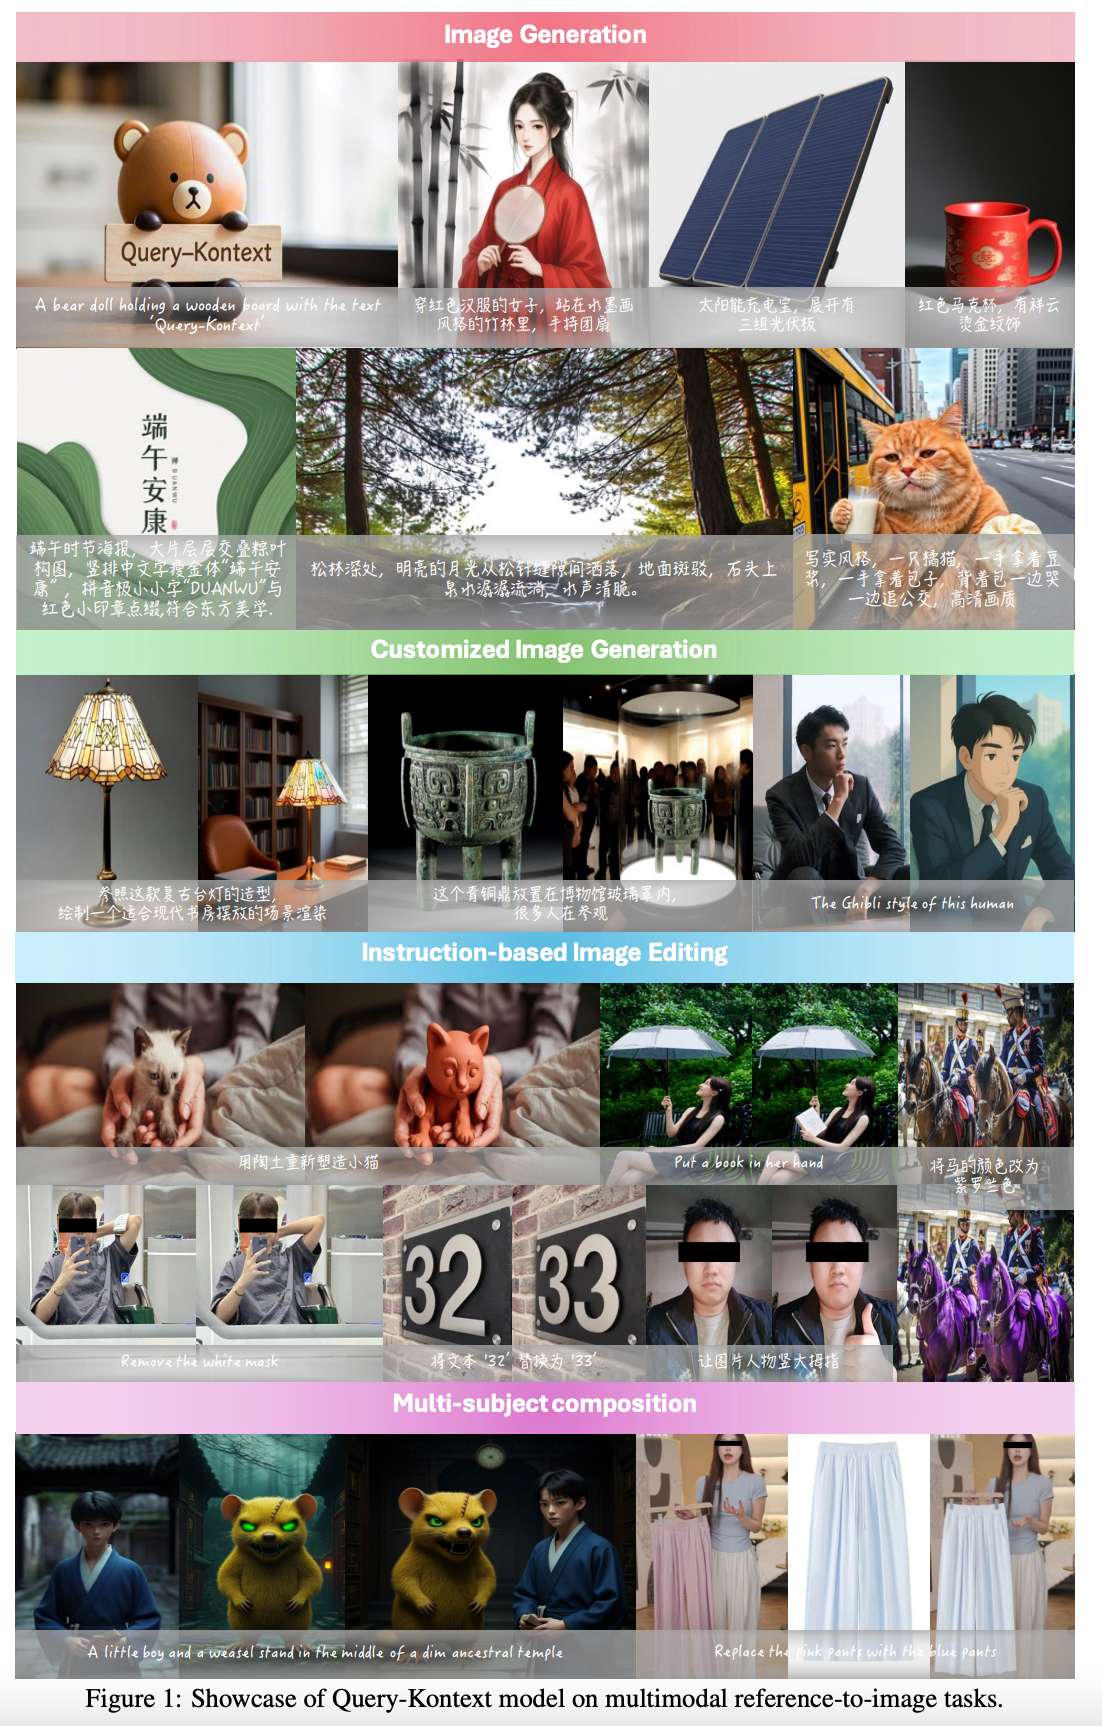
本文还提供了所有任务类别的定性比较,包括文本生成图像、指令编辑和定制生成,涵盖中文和英文提示。代表性示例如上图1所示。
偏移RoPE
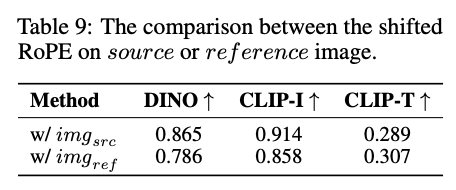
进一步检查了所提出的偏移2D-RoPE机制在处理参考图像时的效果。对于源输入图像,模型倾向于保持输入的像素级保真度,生成忠实的重建。相比之下,对于参考输入图像,模型强调指令遵循和泛化,在保持主体身份的同时生成更为多样化的输出。使用源图像与参考图像在DreamBooth基准上的比较结果如下表9所示。
Query-Kontext 收敛
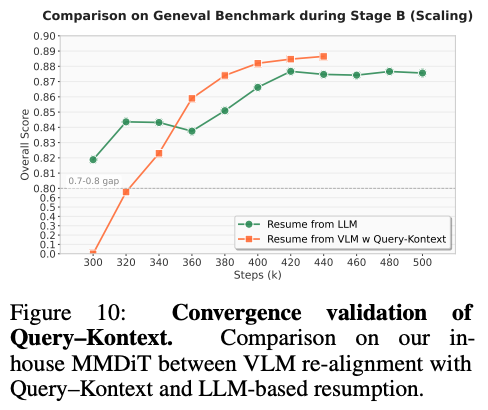
在阶段2中,分析了扩散模型在两种设置下的收敛行为:(i)来自LLM的仅文本嵌入和(ii)来自文本标记和本文微调的VLM生成的Query-Kontext标记的混合条件。观察到,用本文的VLM替换LLM可以更快地使扩散模型对齐,并且与LLM条件基线相比,产生更优越的视觉结果,如下图10所示。这表明,通过Query-Kontext将多模态推理与视觉生成解耦,不仅加速了收敛,还释放了VLM和扩散模型的全部潜力。
LoRA 排名
本文在扩散模型和MLLM适配器上评估了LoRA排名,观察到在更高排名时收敛更快,但在以上的质量提升有限。
讨论
VLM和扩散模型之间的经济对齐。Query-Kontext基于强大的VLM和基于MMDiT的扩散模型,利用各自的优势构建了一个统一的多模态到图像生成系统。训练过程在192个NVIDIA H100 GPU(80GB)上进行,这大约占通常从头开始训练大规模扩散模型(例如Qwen-Image)或集成多模态变换器(例如BAGEL)所需计算资源的10%。这种经济的对齐使本文能够更有效地分配资源,专注于更高层次和未充分探索的训练后任务,如多主体合成、多图像生成和交错文本-图像生成。
扩散模型的扩展。通过将VLM中的多模态生成推理与扩散模型中的高保真视觉合成解耦,本文的框架使每个组件的扩展法则能够独立探索。这种分离是关键的,因为VLM和扩散模型通常表现出竞争的容量需求,并从不同的参数预算中受益。在阶段2中,本文尝试与不同规模的内部扩散骨干(0.9B、4B和10B参数)进行对齐。然而,特别是在使用轻量级连接器连接一个庞大且冻结的扩散模型(例如10B参数)时,对齐并不总是成功的。为了解决这个问题,本文在阶段2训练期间解冻了扩散模型参数,从而避免了对连接器超参数的密集网格搜索。研究控制连接器的扩展法则仍然是未来工作的重要方向。
结论
Query-Kontext,一个经济的统一多模态到图像框架,将多模态生成推理(由VLM处理)与高保真渲染(由扩散模型处理)解耦。为了充分利用这两个组件的潜力,本文提出了一种三阶段渐进训练策略,逐步将VLM与日益强大的扩散生成器对齐,同时增强它们的互补优势。此外,本文策划了一个多模态参考到图像的数据集混合,涵盖真实、合成和经过精心筛选的开源数据。大量实验表明,本文的框架在各种任务中实现了有竞争力的性能,包括图像生成、指令编辑、定制主体合成和多主体合成。
参考文献
1 Query-Kontext: An Unified Multimodal Model for Image Generation and Editing