目录
[1. 添加元素](#1. 添加元素)
[2. 查询元素](#2. 查询元素)
[Redis 的 SETNX 命令](#Redis 的 SETNX 命令)
[三、SETNX 的核心特性](#三、SETNX 的核心特性)
[1. 原子性](#1. 原子性)
[2. 简单性](#2. 简单性)
[3. 无过期时间](#3. 无过期时间)
[1. 分布式锁(最经典的应用)](#1. 分布式锁(最经典的应用))
[五、SETNX 的局限性及改进方案](#五、SETNX 的局限性及改进方案)
[解决方案:使用 SET 命令的 NX 和 EX 参数](#解决方案:使用 SET 命令的 NX 和 EX 参数)
[解决方案:使用 Lua 脚本确保原子性](#解决方案:使用 Lua 脚本确保原子性)
[六、SETNX vs 新的 SET 语法](#六、SETNX vs 新的 SET 语法)
[Canal 的工作原理:](#Canal 的工作原理:)
[缓存和 MySQL 数据同步方案对比](#缓存和 MySQL 数据同步方案对比)
[方案2:基于 Canal + binlog 的同步(解耦方案)](#方案2:基于 Canal + binlog 的同步(解耦方案))
[多路复用IO(I/O Multiplexing)](#多路复用IO(I/O Multiplexing))
[SpringMVC SpringBoot](#SpringMVC SpringBoot)
布隆过滤器
布隆过滤器是一种空间效率极高的概率型数据结构 ,用于判断一个元素是否一定不在一个集合中 或可能在集合中 。它的核心特点是:高效、省空间,但有一定程度的误判率。
一、核心思想
布隆过滤器的执行逻辑基于两个基本操作:添加 和查询 。它背后是一个巨大的位数组 和一组哈希函数。
-
位数组:初始时,所有位都设置为0。
-
哈希函数:多个相互独立、均匀分布的哈希函数。
二、执行逻辑详解
1. 添加元素
当一个元素被加入到布隆过滤器时,会执行以下步骤:
-
哈希计算 :将此元素分别通过
k个不同的哈希函数进行计算,得到k个哈希值。 -
取模定位 :将每个哈希值对位数组的长度
m取模,得到k个在数组范围内的位置索引。 -
置位 :将位数组中这
k个位置上的位都设置为1。
2. 查询元素
当需要查询一个元素是否存在于布隆过滤器中时,执行以下步骤:
-
哈希计算 :同样,将此元素通过那
k个哈希函数进行计算,得到k个哈希值。 -
取模定位 :同样,对每个哈希值取模,得到
k个位置索引。 -
检查位 :检查位数组中这
k个位置上的位。
-
如果其中任何一个位的值为
0:那么可以肯定地得出结论------"该元素一定不在集合中"。 -
如果所有位的值都是
1:那么可以得出结论------"该元素可能在集合中"。
三、为什么会有误判?
根本原因:哈希冲突。
-
你添加了元素 A,它将位置
1, 3, 5设置成了1。 -
你添加了元素 B,它将位置
2, 4, 6设置成了1。 -
现在查询一个从未添加过的元素 C。
-
经过哈希计算,元素 C 对应的位置恰好是
1, 4, 6。 -
你检查位数组,发现位置
1, 4, 6都已经被其他元素(A和B)设置成了1。
这时,布隆过滤器就会错误地认为元素 C 是存在的。这就是假阳性。
总结:
-
肯定不存在" 是100%准确的。因为只要有一个位是0,就证明这个元素从未被添加过。
-
"可能存在" 是不确定的。可能是因为元素真的存在,也可能是由其他元素设置的位偶然组合而成的。
四、关键参数与性能权衡
布隆过滤器的行为由三个参数决定:
-
n:预期要添加的元素数量。 -
m:位数组的大小(位数)。 -
k:哈希函数的数量。
它们之间的关系决定了误判率:
-
位数组
m越大,误判率越低(因为有更多的位来分散信息,冲突可能性降低),但占用空间越大。 -
哈希函数
k数量 需要一个最优值。太少的哈希函数容易冲突,太多的哈希函数会很快将位数组"填满",反而增加冲突。 -
对于给定的
n和m,可以计算出一个使误判率最小的最佳哈希函数数量k。
经验公式:
当哈希函数数量 𝑘=𝑚𝑛ln2k=nmln2 时,误判率最小。其中,为了达到指定的误判率 𝑝p,位数组大小 𝑚m 应满足 𝑚=−𝑛ln𝑝(ln2)2m=−(ln2)2nlnp。
五、执行逻辑总结与特点
| 特性 | 描述 |
|---|---|
| 空间效率 | 非常高,只需要一个位数组和几个哈希函数。 |
| 时间效率 | 添加和查询操作都是 O(k),常数时间,非常快。 |
| 确定性 | 回答"不存在"是100%正确的;回答"存在"是有概率正确的。 |
| 缺点 | 1. 误判率 :存在假阳性。 2. 无法删除:由于多位共享,传统布隆过滤器无法安全删除元素(删除一个元素可能会影响其他元素)。(注:有变种如计数布隆过滤器支持删除) |
六、典型应用场景
利用其"不存在则一定不存,存在则可能存在"的逻辑,布隆过滤器常用于前置快速判断,以减轻核心系统的压力。
-
缓存系统:
- 逻辑 :先查询布隆过滤器,如果"肯定不存在",则无需查询后端数据库,直接返回空。这可以防止缓存穿透攻击。
-
网页爬虫:
- 逻辑:判断一个URL是否已经被爬取过。如果布隆过滤器说"可能存在",则大概率已经爬过,可以跳过,节省资源。
-
数据库:
- 逻辑:在查询数据库前,先用布隆过滤器判断数据是否存在,避免对不存在的键进行昂贵的磁盘IO操作。
-
恶意网站检测:
- 逻辑:浏览器本地维护一个布隆过滤器,快速判断一个网站是否在恶意网站黑名单中。如果"可能存在",再发起一次精确查询。
Redis 的 SETNX 命令
SETNX 是 SET if Not eXists 的缩写,意思是"如果不存在则设置"。
一、基本语法和语义
SETNX key value执行逻辑:
-
Redis 会检查指定的
key是否存在。 -
如果 key 不存在:
-
将 key 设置为指定的
value -
返回 1(表示设置成功)
-
-
如果 key 已经存在:
-
不进行任何操作,保持原有的 key-value 不变
-
返回 0(表示设置失败)
-
二、简单示例
# 第一次设置,key "mykey" 不存在
127.0.0.1:6379> SETNX mykey "Hello"
(integer) 1  # 返回 1,设置成功

# 尝试再次设置相同的 key
127.0.0.1:6379> SETNX mykey "World"
(integer) 0  # 返回 0,设置失败

# 检查值,仍然是 "Hello"
127.0.0.1:6379> GET mykey
"Hello"三、SETNX 的核心特性
1. 原子性
这是 SETNX 最重要的特性!检查和设置这两个操作是在一个原子操作中完成的,不存在竞态条件。
2. 简单性
命令非常简单,只有成功(1)或失败(0)两种结果。
3. 无过期时间
传统的 SETNX 命令本身不能设置过期时间 ,如果需要过期时间,需要配合 EXPIRE 命令使用。
四、经典应用场景
1. 分布式锁(最经典的应用)
SETNX 是实现 Redis 分布式锁最简单的方式:
# 客户端1获取锁
127.0.0.1:6379> SETNX lock:order123 "client1"
(integer) 1  # 获取锁成功

# 客户端2尝试获取同一个锁(此时锁还被client1持有)
127.0.0.1:6379> SETNX lock:order123 "client2"
(integer) 0  # 获取锁失败,合理

# 客户端1释放锁
127.0.0.1:6379> DEL lock:order123
(integer) 1

# 客户端2再次尝试获取锁(此时锁已释放)
127.0.0.1:6379> SETNX lock:order123 "client2"
(integer) 1  # 获取锁成功,合理
Redis 通过单线程模型保证了:
-
命令执行的原子性:每个命令执行期间不会被中断
-
自然的互斥访问:SETNX 在同一时刻只能有一个客户端成功
-
顺序一致性:所有客户端看到相同的命令执行顺序
这正是为什么 Redis 的 SETNX 能够作为分布式锁的基础,而不需要额外的锁机制来协调客户端之间的竞争。
五、SETNX 的局限性及改进方案
问题1:非原子性的设置过期时间
# 这种写法有风险!
if redis.setnx("lock", "value") == 1:
    redis.expire("lock", 10)  # 如果在这条命令执行前程序崩溃,锁将永远不会释放!
解决方案:使用 SET 命令的 NX 和 EX 参数
Redis 2.6.12 之后,推荐使用 SET 命令的扩展语法:
# 原子性的设置值和过期时间
SET key value NX EX 10-
NX:等同于 SETNX,只在 key 不存在时设置 -
EX:设置过期时间(秒)
问题2:可能误删其他客户端的锁
简单的 DEL 操作可能删除其他客户端持有的锁。
解决方案:使用 Lua 脚本确保原子性
Lua脚本更像是"存储过程",而MySQL的事务提供了ACID特性
Lua脚本为什么能解决这个问题?
Lua脚本的原子性解决方案
-- Lua脚本:检查值匹配再删除
if redis.call("GET", KEYS[1]) == ARGV[1] then
    return redis.call("DEL", KEYS[1])
else
    return 0
end
在Redis中执行:
127.0.0.1:6379> EVAL "if redis.call('GET', KEYS[1]) == ARGV[1] then return redis.call('DEL', KEYS[1]) else return 0 end" 1 lock:order123 "client1"-
原子性执行:Redis保证Lua脚本在执行期间不会被其他命令打断
-
检查+删除的原子组合:GET和DEL操作在脚本中是一个不可分割的整体
-
值验证:只有锁的值与预期值匹配时才执行删除
非原子操作的问题
# 错误的做法:分两步操作
127.0.0.1:6379> GET lock:order123
"client1"
# 在这两步之间,锁可能被其他客户端修改!

127.0.0.1:6379> DEL lock:order123 # 如果锁已经被修改,这里就会误删六、SETNX vs 新的 SET 语法
| 特性 | SETNX + EXPIRE |
SET with NX & EX |
|---|---|---|
| 原子性 | 非原子(两条命令) | 原子操作 |
| 过期时间 | 需要额外命令 | 内置支持 |
| 推荐度 | 不推荐 | 推荐 |
| Redis版本 | 所有版本 | 2.6.12+ |
Redis的持久化
| 特性 | RDB | AOF |
|---|---|---|
| 存储内容 | 数据快照 | 操作命令 |
| 文件格式 | 二进制(紧凑) | 文本(Redis协议) |
| 文件大小 | 较小 | 较大 |
| 恢复速度 | 快(直接加载数据) | 慢(需要重放所有命令) |
| 数据安全性 | 可能丢失最后一次快照后的数据 | 根据配置,最多丢失1秒数据 |
| 性能影响 | 保存时对性能影响大 | 写入时对性能影响小 |
Canal
-
Canal是阿里巴巴开源的一个基于MySQL数据库Binlog的增量订阅和消费组件。它模拟MySQL Slave的交互协议,伪装自己为MySQL Slave,向MySQL Master发送dump请求,MySQL Master收到请求后,开始推送Binlog给Canal。
-
Canal解析Binlog,并将其转换成更容易处理的结构化数据,供下游系统(如缓存、消息队列等)使用。
-
常见用途:数据库同步、缓存更新、搜索索引更新等。
Binlog(二进制日志)是什么?
-
Binlog是MySQL的一种日志,它记录了对数据库执行的所有更改操作(如INSERT、UPDATE、DELETE等),但不包括SELECT这类不修改数据的操作。
-
Binlog是MySQL服务器层维护的,与存储引擎无关,也就是说无论使用InnoDB还是其他引擎,只要开启了Binlog,就会记录。
-
Binlog主要用于:
-
主从复制(Replication):主服务器将Binlog发送给从服务器,从服务器重放这些日志以保持数据一致。
-
数据恢复:通过重放Binlog来恢复数据到某个时间点。
-
Canal 的工作原理:
MySQL主库 ──binlog──> Canal Server ──解析后的数据──> 应用程序(如缓存更新)执行流程:
-
伪装从库:Canal 把自己伪装成 MySQL 的从库(slave)
-
请求binlog:向 MySQL 主库发送 dump 请求,获取 binlog
-
解析binlog:解析 binlog 中的变更事件
-
推送数据:将解析后的结构化数据推送给订阅者
// Canal解析出的数据格式示例
{
"database": "shop",
"table": "products",
"type": "UPDATE", // 操作类型
"data": [
{
"id": 1001,
"name": "iPhone",
"price": 5999, // 新价格
"stock": 50
}
],
"old": [
{
"price": 5499 // 旧价格
}
]
}
缓存和 MySQL 数据同步方案对比
"读写锁"是一种方案,但 Canal + binlog 是另一种更优雅的方案:
方案1:基于读写锁的同步(应用程序控制)
// 伪代码:在业务代码中手动维护缓存一致性
public void updateProduct(Product product) {
    // 获取写锁
    Lock writeLock = redis.getLock("product:" + product.getId());

    try {
        // 1. 更新数据库
        productMapper.update(product);

        // 2. 删除/更新缓存
        redis.delete("product:" + product.getId());

    } finally {
        writeLock.unlock();
    }
}

public Product getProduct(Long id) {
    // 获取读锁
    Lock readLock = redis.getLock("product:" + id);

    try {
        // 先查缓存,再查数据库...
    } finally {
        readLock.unlock();
    }
}
缺点:
-
代码侵入性强:每个数据库操作都要手动维护缓存
-
容易遗漏:复杂的业务逻辑可能忘记更新缓存
-
性能开销:锁竞争影响性能
方案2:基于 Canal + binlog 的同步(解耦方案)
// Canal客户端:监听数据库变更,自动更新缓存
@CanalEventListener
public class CacheUpdateListener {

    @ListenPoint
    public void onProductUpdate(ProductChangeEvent event) {
        if (event.getType() == UPDATE || event.getType() == DELETE) {
            // 自动删除对应的缓存
            redis.delete("product:" + event.getId());
        }

        if (event.getType() == INSERT || event.getType() == UPDATE) {
            // 或者更新缓存
            redis.set("product:" + event.getId(), event.getNewData());
        }
    }
}
优点:
-
解耦:缓存同步与业务代码完全分离
-
可靠:基于 binlog,不会遗漏任何数据变更
-
通用:一套方案适用于所有表的缓存同步
完整的数据同步架构
在实际项目中,通常会采用这样的架构:
MySQL ──binlog──> Canal ──MQ──> 多个消费者
                              ├── 缓存服务(更新Redis)
                              ├── 搜索服务(更新Elasticsearch)
                              ├── 大数据服务(更新数据仓库)
                              └── 消息推送服务
在现代分布式系统中,Canal + binlog 的方案更加流行,因为它提供了更好的解耦性和可维护性。
多路复用IO(I/O Multiplexing)
核心思想:
一个线程监控多个 I/O 操作,哪个准备好了就处理哪个
Spring的注解
@Repository
它是一个数据访问层的标记,同时能够将数据访问异常转换为Spring的统一数据访问异常
@Repository的作用
1. 标识数据访问层组件
@Repository
public class UserDaoImpl implements UserDao {
    @Autowired
    private JdbcTemplate jdbcTemplate;

    public User findById(Long id) {
        String sql = "SELECT * FROM users WHERE id = ?";
        return jdbcTemplate.queryForObject(sql, new UserRowMapper(), id);
    }
}
2. 自动异常转换
-
将特定持久化技术的异常(如JDBC的
SQLException)转换为Spring的统一数据访问异常 -
提供一致的异常处理体验
3. Bean自动扫描与注册
在Spring配置中:
@Configuration
@ComponentScan("com.example.dao") // 扫描带有@Repository的类
public class AppConfig {
}@Mapper注解
@Mapper注解并非由Spring、SpringMVC或SpringBoot框架提供,它是MyBatis框架的核心注解
| 注解 | 所属框架 | 主要作用 |
|---|---|---|
@Mapper |
MyBatis | 标记一个接口为MyBatis的映射器(Mapper),MyBatis会在编译时为其动态生成代理实现类 -2-5。这样你就可以直接通过接口方法执行SQL操作,无需编写实现类。 |
@Repository |
Spring | 作为Spring的** stereotype注解**之一,用于标识一个类为数据访问层(DAO)的Bean-2。它的主要作用是让Spring在扫描时能识别并将其纳入容器管理,同时能够将平台特定的数据访问异常转换为Spring统一的异常-2。 |
虽然@Mapper是MyBatis的注解,但它设计的目的就是为了与Spring框架无缝整合。
使用@MapperScan:这是更推荐的方式。@MapperScan也是MyBatis提供的注解,你只需在SpringBoot的启动类上使用它,并指定Mapper接口所在的包路径
@SpringBootApplication
@MapperScan("com.example.mapper") // 扫描该包下的所有接口
public class Application {
    public static void main(String[] args) {
        SpringApplication.run(Application.class, args);
    }
}使用后,包内所有Mapper接口都无需再单独添加@Mapper或@Repository注解,Spring和MyBatis会自动完成所有处理,非常方便
SpringMVC SpringBoot
| 注解 | 所属框架 | 引入版本 |
|---|---|---|
@GetMapping |
Spring MVC | Spring 4.3+ |
@PostMapping |
Spring MVC | Spring 4.3+ |
@PutMapping |
Spring MVC | Spring 4.3+ |
@DeleteMapping |
Spring MVC | Spring 4.3+ |
@PatchMapping |
Spring MVC | Spring 4.3+ |
@RequestMapping |
Spring MVC | Spring 2.5+ |
Spring MVC:提供Web开发能力,包括这些注解
Spring Boot:通过自动配置,让Spring MVC开箱即用
Mybatis
延迟加载
MyBatis的延迟加载(Lazy Loading)是一种在需要时才加载相关对象数据的机制,目的是减少不必要的数据库查询,提升性能。
工作原理:
-
当查询主对象时,MyBatis不会立即加载与主对象关联的子对象(如一对一、一对多关联),而是返回一个代理对象。
-
当程序第一次访问关联对象时,代理对象会触发一次额外的查询,去数据库加载关联对象的数据。
实现方式:
MyBatis通过动态代理技术实现延迟加载。例如,当查询一个订单(Order)时,订单中有一个用户(User)对象(多对一关联)和一个订单明细(OrderDetail)列表(一对多关联)。如果启用延迟加载,那么当获取订单时,不会立即加载用户和订单明细,直到你调用order.getUser()或order.getOrderDetails()时,MyBatis才会执行相应的查询。
配置延迟加载:
在MyBatis的配置文件中,可以设置lazyLoadingEnabled为true来启用延迟加载。还可以使用aggressiveLazyLoading(早期版本)或lazyLoadTriggerMethods等参数来控制加载行为。
注意:在MyBatis 3.4.1及以后版本,aggressiveLazyLoading的默认值改为false,而lazyLoadingEnabled的默认值也是false。
使用延迟加载的注意事项:
-
延迟加载可以减少不必要的数据库查询,但也可能导致"N+1查询问题"(当遍历一个集合时,每个元素都会触发一次查询,导致多次查询)。
-
在Web应用中,如果延迟加载发生在视图渲染阶段,而数据库连接已经关闭,则会抛出异常。解决方法是使用OpenSessionInView模式或在事务范围内完成数据加载。
| 配置项 | 说明 | 默认值 |
|---|---|---|
lazyLoadingEnabled |
是否启用延迟加载 | false |
aggressiveLazyLoading |
侵略性延迟加载(任何方法调用都会加载) | false (3.4.1+) |
lazyLoadTriggerMethods |
触发加载的方法 | equals,clone,hashCode,toString |
优点
- 减少不必要的数据传输
- 提高初始查询速度
- 节省内存资源
缺点
- 可能产生"N+1查询"问题
- 增加代码复杂度
- 需要注意会话生命周期管理
Mybatis的一级二级缓存
| 特性 | 一级缓存 | 二级缓存 |
|---|---|---|
| 作用范围 | SqlSession内部 | Mapper命名空间 |
| 默认状态 | 开启 | 关闭 |
| 共享性 | 不能共享 | 跨SqlSession共享 |
| 存储位置 | 内存 | 内存/磁盘/第三方存储 |
| 生命周期 | 随SqlSession销毁 | 随应用关闭销毁 |
| 适用场景 | 单次会话内重复查询 | 全局频繁查询且更新少 |
一级缓存
基本概念
-
范围:SqlSession 级别(默认开启)
-
生命周期:与 SqlSession 相同
-
共享性:同一个 SqlSession 内共享
工作机制
// 示例:一级缓存演示
SqlSession sqlSession = sqlSessionFactory.openSession();
UserMapper mapper = sqlSession.getMapper(UserMapper.class);

// 第一次查询,访问数据库
User user1 = mapper.selectUserById(1L);
System.out.println("第一次查询,执行SQL");

// 第二次查询相同数据,从一级缓存获取
User user2 = mapper.selectUserById(1L);
System.out.println("第二次查询,从缓存获取");

// 验证是同一个对象
System.out.println(user1 == user2); // 输出:true

sqlSession.close();
一级缓存结构
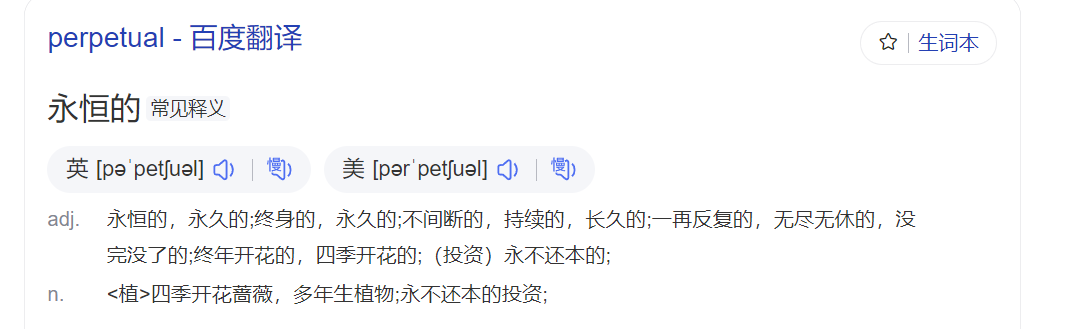
// 伪代码:PerpetualCache 实现
public class PerpetualCache implements Cache {
    private String id;
    private Map<Object, Object> cache = new HashMap<>();

    @Override
    public void putObject(Object key, Object value) {
        cache.put(key, value);
    }

    @Override
    public Object getObject(Object key) {
        return cache.get(key);
    }
}
缓存失效场景
// 1. 执行增删改操作
UserMapper mapper = sqlSession.getMapper(UserMapper.class);
User user1 = mapper.selectUserById(1L); // 查询,加入缓存

mapper.updateUser(user1); // 更新操作,清空一级缓存

User user2 = mapper.selectUserById(1L); // 重新查询数据库

// 2. 手动清空缓存
sqlSession.clearCache(); // 手动清空一级缓存

// 3. 关闭SqlSession
sqlSession.close(); // 关闭会话,缓存销毁
配置选项
<!-- 在settings中配置本地缓存作用域 -->
<settings>
    <!-- SESSION: 同一个SqlSession共享(默认) -->
    <!-- STATEMENT: 缓存仅对当前语句有效,相当于关闭一级缓存 -->
    <setting name="localCacheScope" value="SESSION"/>
</settings>
二级缓存
开启二级缓存
-
全局配置
-
Mapper配置
flushInterval="60000" size="512" readOnly="true"/> <select id="selectUserById" parameterType="long" resultType="User"> SELECT * FROM users WHERE id = #{id} </select>
二级缓存使用示例
// 多个SqlSession共享二级缓存
SqlSession sqlSession1 = sqlSessionFactory.openSession();
UserMapper mapper1 = sqlSession1.getMapper(UserMapper.class);
User user1 = mapper1.selectUserById(1L); // 查询数据库
sqlSession1.close(); // 重要:必须关闭,数据才会进入二级缓存

SqlSession sqlSession2 = sqlSessionFactory.openSession();
UserMapper mapper2 = sqlSession2.getMapper(UserMapper.class);
User user2 = mapper2.selectUserById(1L); // 从二级缓存获取
sqlSession2.close();

System.out.println(user1 == user2); // 输出:false(不同对象,但数据相同)
缓存回收策略
| 策略 | 描述 | 适用场景 |
|---|---|---|
LRU |
最近最少使用 | 最常用策略 |
FIFO |
先进先出 | 按顺序淘汰 |
SOFT |
软引用 | 内存不足时GC回收 |
WEAK |
弱引用 | 更积极地GC回收 |
一级缓存在session.close(); 的时候 一级缓存就被完全清理,HashMap被丢弃
实体类序列化要求
// 使用二级缓存的实体类建议实现Serializable(因为二级不一定使用
默认的PerpetualCache(HashMap存储),二级缓存更常使用外部缓存(redis))
public class User implements Serializable {
    private static final long serialVersionUID = 1L;

    private Long id;
    private String name;
    // getter/setter...
}
两级缓存执行流程
// 缓存查询顺序
public class Executor {
    public <E> List<E> query(MappedStatement ms, Object parameter) {
        // 1. 生成缓存Key
        CacheKey key = createCacheKey(ms, parameter);

        // 2. 先查询二级缓存
        List<E> list = (List<E>) tcm.getObject(cache, key);
        if (list != null) {
            return list;
        }

        // 3. 查询一级缓存
        list = (List<E>) localCache.getObject(key);
        if (list != null) {
            return list;
        }

        // 4. 查询数据库
        list = queryFromDatabase(ms, parameter);

        // 5. 放入一级缓存
        localCache.putObject(key, list);

        return list;
    }
}
虽然默认都是HashMap,但二级缓存更常使用外部缓存:
// 情况1:使用默认的PerpetualCache(HashMap存储)
public class User {  // 不实现Serializable也可以
    private Long id;
    private String name;
    // 在默认的PerpetualCache+HashMap中能正常工作
}

// 情况2:使用分布式缓存(Redis等)
public class User implements Serializable {  // 必须实现
    private static final long serialVersionUID = 1L;
    private Long id;
    private String name;
}
ArrayList
ArrayList有两个相关的构造方法:
-
ArrayList(int initialCapacity):构造一个具有指定初始容量的空列表。
-
ArrayList():构造一个初始容量为10的空列表(注意,在JDK8中,默认构造方法初始容量为10,但实际是在第一次添加元素时才分配容量为10的数组)。
-
new ArrayList(10):创建时直接分配容量为10的数组,0次扩容 -
new ArrayList():创建时空数组,首次添加元素时扩容1次到默认容量10
Futrue、FutureTask
Future是Java并发编程中的一个接口,它代表一个异步计算的结果。Future提供了检查计算是否完成、等待计算完成以及获取计算结果的方法。如果计算尚未完成,get方法会阻塞直到计算完成。
FutureTask是Future的一个基础实现类,它实现了Runnable接口,因此可以由一个线程来执行。FutureTask可以包装一个Callable或Runnable对象,因为Callable可以返回结果,而Runnable不能,所以当包装Runnable时,需要额外提供一个结果(或者使用null)。
Future接口
Future接口定义了以下方法:
-
boolean cancel(boolean mayInterruptIfRunning):尝试取消执行此任务。如果任务已经完成、已经取消或由于其他原因无法取消,则此尝试将失败。如果成功,并且此任务在调用cancel时尚未启动,则此任务不应运行。如果任务已经启动,则mayInterruptIfRunning参数决定是否中断执行此任务的线程。 -
boolean isCancelled():如果此任务在正常完成之前被取消,则返回true。 -
boolean isDone():如果此任务完成,则返回true。完成可能是由于正常终止、异常或取消,在所有这些情况下,此方法都将返回true。 -
V get():等待计算完成,然后检索其结果。 -
V get(long timeout, TimeUnit unit):如果需要,最多等待给定的时间以完成计算,然后检索其结果(如果可用)。public interface Future
{
// 尝试取消任务
boolean cancel(boolean mayInterruptIfRunning);// 判断任务是否被取消 boolean isCancelled(); // 判断任务是否完成(正常完成、异常、取消都算完成) boolean isDone(); // 获取计算结果(阻塞直到计算完成) V get() throws InterruptedException, ExecutionException; // 获取计算结果(带超时时间) V get(long timeout, TimeUnit unit) throws InterruptedException, ExecutionException, TimeoutException;}
FutureTask类
FutureTask类实现了RunnableFuture接口,而RunnableFuture接口继承了Runnable和Future接口。因此,FutureTask既可以作为Runnable被线程执行,又可以作为Future得到计算的结果。
FutureTask有两种构造方法:
-
FutureTask(Callable<V> callable):创建一个FutureTask,它在运行时将执行给定的Callable。
-
FutureTask(Runnable runnable, V result):创建一个FutureTask,它在运行时将执行给定的Runnable,并安排get方法在成功完成时返回给定的结果。
// 可以这样被线程执行
public class FutureTaskimplements RunnableFuture {
// ...
}public interface RunnableFuture
extends Runnable, Future {
void run();
}
实例
使用Callable和FutureTask
Callable<String> callable = () -> {
    Thread.sleep(1000);
    return "Hello, World!";
};

FutureTask<String> futureTask = new FutureTask<>(callable);
Thread thread = new Thread(futureTask);
thread.start();

// 做一些其他事情
// ...

// 获取结果
try {
    String result = futureTask.get(); // 这里会阻塞直到任务完成
    System.out.println(result);
} catch (InterruptedException | ExecutionException e) {
    e.printStackTrace();
}
使用Runnable和FutureTask
Runnable runnable = () -> {
    try {
        Thread.sleep(1000);
    } catch (InterruptedException e) {
        e.printStackTrace();
    }
};

FutureTask<String> futureTask = new FutureTask<>(runnable, "Task completed");
Thread thread = new Thread(futureTask);
thread.start();

// 获取结果
try {
    String result = futureTask.get(); // 返回"Task completed"
    System.out.println(result);
} catch (InterruptedException | ExecutionException e) {
    e.printStackTrace();
}
FutureTask是一个可取消的异步计算,它实现了Future和Runnable接口,因此既可以作为Future来获取结果,也可以作为Runnable被线程执行。它提供了对计算过程的生命周期管理。
在并发编程中,我们通常将耗时的操作封装在Callable或Runnable中,然后用FutureTask来执行,并通过FutureTask来获取结果或控制任务的执行。
使用示例
import java.util.concurrent.*;

public class FutureExample {
    public static void main(String[] args) throws Exception {
        ExecutorService executor = Executors.newSingleThreadExecutor();

        // 提交Callable任务,返回Future
        Future<String> future = executor.submit(() -> {
            Thread.sleep(2000); // 模拟耗时操作
            return "任务执行完成";
        });

        System.out.println("主线程继续执行...");

        // 获取结果(会阻塞直到任务完成)
        String result = future.get();
        System.out.println("结果: " + result);

        executor.shutdown();
    }
}
FutureTask 直接使用
public class FutureTaskExample {
    public static void main(String[] args) throws Exception {
        // 创建FutureTask,包装Callable
        FutureTask<String> futureTask = new FutureTask<>(() -> {
            Thread.sleep(2000);
            return "FutureTask执行结果";
        });

        // 创建线程执行
        Thread thread = new Thread(futureTask);
        thread.start();

        System.out.println("主线程做其他事情...");

        // 获取结果
        String result = futureTask.get();
        System.out.println("结果: " + result);
    }
}| 特性 | Future接口 | FutureTask类 |
|---|---|---|
| 身份 | 接口,定义规范 | 具体实现类 |
| 执行方式 | 通过ExecutorService提交 | 可直接作为Runnable被Thread执行 |
| 功能完整性 | 只有获取结果的方法 | 完整的任务生命周期管理 |
| 使用场景 | 线程池任务提交的返回值 | 需要更精细控制的任务执行 |
实际应用场景
-
并行计算
ExecutorService executor = Executors.newFixedThreadPool(3);
Future
future1 = executor.submit(() -> calculate1());
Futurefuture2 = executor.submit(() -> calculate2());
Futurefuture3 = executor.submit(() -> calculate3()); // 并行执行,最后汇总结果
int result = future1.get() + future2.get() + future3.get(); -
超时控制
Future
future = executor.submit(() -> {
// 可能很耗时的操作
return fetchDataFromNetwork();
});try {
// 最多等待3秒
String result = future.get(3, TimeUnit.SECONDS);
} catch (TimeoutException e) {
future.cancel(true); // 超时取消任务
System.out.println("任务超时");
} -
任务取消
FutureTask
futureTask = new FutureTask<>(() -> {
while (!Thread.currentThread().isInterrupted()) {
// 执行任务,定期检查中断状态
}
return "任务被取消";
});Thread thread = new Thread(futureTask);
thread.start();// 5秒后取消任务
Thread.sleep(5000);
futureTask.cancel(true);
线程状态
| 状态 | 触发条件 | 恢复条件 | 是否消耗CPU |
|---|---|---|---|
| RUNNABLE | 线程已启动,具备运行条件 | 获得CPU时间片 | 获得时间片时消耗 |
| BLOCKED | 竞争synchronized锁失败 | 锁可用时 | 不消耗CPU |
| WAITING | 调用wait()、join()等 | 被notify()或线程结束 | 不消耗CPU |
| TIMED_WAITING | 调用sleep()、wait(timeout)等 | 超时或被唤醒 | 不消耗CPU |
Java线程的打断机制
在Java中,每个线程都有一个布尔类型的打断标志(interrupt status)。当我们调用一个线程的interrupt()方法时,这个线程的打断标志会被设置为true。
但是,这并不会立即停止线程的执行,而是需要线程自己检查这个标志并做出相应的处理。
与打断相关的方法有三个:
- interrupt():实例方法,用于中断线程。如果该线程正处于阻塞状态(如调用了sleep、wait、join等方法),那么它会立即抛出InterruptedException,并且打断标志会被清除(即设置为false)。如果线程没有阻塞,则只是设置打断标志为true。
- isInterrupted():实例方法,用于检查线程的打断标志,不会清除打断标志。
- static interrupted():静态方法,用于检查当前线程的打断标志,并且会清除打断标志(即如果当前线程的打断标志为true,则调用后返回true,并将打断标志设置为false)。
示例1:使用isInterrupted()检查打断标志
public class InterruptExample1 {
    public static void main(String[] args) throws InterruptedException {
        Thread thread = new Thread(() -> {
            // 循环检查打断标志
            while (!Thread.currentThread().isInterrupted()) {
                System.out.println("线程运行中...");
            }
            System.out.println("线程结束,打断标志为: " + Thread.currentThread().isInterrupted());
        });

        thread.start();
        Thread.sleep(10); // 主线程休眠10毫秒,确保子线程运行
        thread.interrupt(); // 中断线程
    }
}示例2:使用static interrupted()方法
public class InterruptExample2 {
    public static void main(String[] args) throws InterruptedException {
        Thread thread = new Thread(() -> {
            while (true) {
                // 使用静态方法检查,并清除标志
                if (Thread.interrupted()) {
                    System.out.println("检测到打断,退出循环。");
                    System.out.println("再次检查打断标志: " + Thread.currentThread().isInterrupted());
                    break;
                }
            }
        });

        thread.start();
        thread.interrupt(); // 设置打断标志为true
    }
}
示例3:线程在阻塞时被中断(例如在sleep时)
public class InterruptExample3 {
    public static void main(String[] args) throws InterruptedException {
        Thread thread = new Thread(() -> {
            try {
                Thread.sleep(5000); // 线程休眠5秒
            } catch (InterruptedException e) {
                // 在阻塞过程中被中断,会抛出InterruptedException,并且打断标志会被清除(变为false)
                System.out.println("线程在休眠时被中断,打断标志为: " + Thread.currentThread().isInterrupted());
                // 我们可以选择重新设置打断标志,或者直接返回
                // Thread.currentThread().interrupt(); // 重新中断,以便上层代码能知道
            }
        });

        thread.start();
        Thread.sleep(1000); // 主线程休眠1秒,确保子线程进入休眠
        thread.interrupt(); // 中断子线程的休眠
    }
}
重要注意事项:
当线程在阻塞状态(如sleep、wait、join)时被中断,会立即抛出InterruptedException,并且打断标志会被清除(变成false)。因此,在捕获InterruptedException后,通常有两种选择:
- 要么重新设置打断标志(因为异常捕获后打断标志为false,所以需要再次调用interrupt()设置标志),这样上层代码可以检测到中断。
- 要么不处理异常,直接退出。
总结
- isInterrupted():检查其他线程的中断状态,不改变状态
- interrupted():检查当前线程的中断状态,清除状态
- interrupt():设置线程的中断标志为true
- 阻塞方法被中断时会抛出InterruptedException并清除中断状态