今日任务:
- 回顾线性代数概念
- 了解奇异值的推导过程
- 明确奇异值的应用:a. 特征降维 b. 数据重构 c. 降噪 d. 推荐系统
- 尝试利用svd来处理心脏病预测,看下精度变化
线性代数基本概念
在学习奇异值分解之前,最好对以下概念有所了解:
- 正交矩阵:对于一个方阵,其转置矩阵与自身的成绩为单位矩阵。列向量正交且单位化
- 特征值与特征向量
- 对称矩阵:对于一个方阵,其转置矩阵等于自身,即元素关于主对角线对称
- 单位矩阵:对角线上全为1,其余全为0的方阵
- 矩阵分解:将一个矩阵表示为几个简单矩阵乘积的过程。包括特征值分解(对称矩阵),与奇异值分解(任意矩阵)
奇异值分解的介绍
奇异值分解(Singular Value Decomposition,SVD ),它的核心思想是:对于任意 一个 m × n 的实数矩阵 A ,无论它是否是方阵,无论它是否可逆,都可以将它分解为三个特别简单、特别有意义的矩阵的乘积。
用具体的公式表达就是**A = U Σ Vᵀ,**其中A为待分解的矩阵,下面是三个分解的矩阵的介绍:
- U: 左奇异向量矩阵。 m × m 的正交矩阵,列向量是矩阵
的特征向量。
- Σ: 奇异值矩阵。m × n 的"对角矩阵",主对角线上的元素为奇异值,降序排列且非负。
- Vᵀ: 右奇异向量矩阵。 n × n 的正交矩阵 V 的转置,列向量是矩阵
下面说明SVD的几何意义。若将矩阵A看作一个线性变换的话,那么,对于任意的线性变换 ,都可以被看作三个简单变换 (旋转、拉伸、旋转)的叠加:
- 旋转/反射(Vᵀ) :先在 n 维空间中,由一个正交矩阵 Vᵀ 进行一个旋转或反射。这个变换不改变图形的形状。
- 拉伸/压缩(Σ) :接着,在 m 维空间中,由对角矩阵 Σ 沿着标准的坐标轴 进行拉伸或压缩(包括维度的变化,升维或降维)。奇异值 σᵢ 就是各个坐标轴方向上的拉伸(σᵢ > 1)或压缩(σᵢ < 1)因子。这是唯一改变图形形状的步骤。
- 旋转/反射(U) :最后,再由另一个正交矩阵 U 进行一次旋转或反射。
那么,对于奇异值和奇异向量到底如何计算呢?下面是大致的步骤:
- 计算
- 将上述的特征值降序排列,对应的特征列向量组成矩阵V
- 根据计算可知,奇异值是特征向量的平方根,故而可以构建矩阵Σ
- 计算矩阵U
SVD应用
对于SVD的应用,主要以下几个方面:
- 特征降维 :对高维数据减小计算量、可视化。通过保留前k个奇异值及其对应的U和V的列向量,可以近似重建A,减少数据维度(如 PCA 的基础)。
- 数据重构 :比如重构信号、重构图像(可以实现有损压缩,k 越小压缩率越高,但图像质量损失越大)。
- 降噪 :通常噪声对应较小的奇异值。通过丢弃这些小奇异值并重构矩阵,可以达到一定程度的降噪效果。
- 推荐系统:在协同过滤算法中,用户-物品评分矩阵通常是稀疏且高维的。SVD (或其变种如 FunkSVD, SVD++) 可以用来分解这个矩阵,发现潜在因子 (latent factors),从而预测未评分的项。这里其实属于特征降维的部分。
下面是具体的说明。
SVD可以将A分解为三个矩阵,反过来,这三个矩阵也可以重构原始矩阵。在实际使用中,我们通常会筛选部分奇异值和对应的向量,来达到特征降维与数据压缩的目的。这一思想,与前面类似,就是通过排序的结果,保留最重要的并剔除不重要,从而提高效率。
进一步地阐述,现在已经知道在Σ 矩阵中,奇异值是降序排列。而奇异值的大小反映了对应向量对原始矩阵的贡献程度(就像前面的shap值),即奇异值越大说明它越重要或在变化方向上占据主导地位。因此,可以保留前K个奇异值并删去剩余较小值,至于如何选就需要根据具体的筛选规则来确定了。
完成奇异值的筛选后,就需要对对应的向量进行处理,保证大小的统一,即对U\Σ\V 取前K列。将降维后的三个矩阵重构得到的新矩阵,保留了主要信息,也就是原矩阵的低秩近似了。
python
import numpy as np

# 创建一个矩阵 A (5x3)
A = np.array([[1, 2, 3],
              [4, 5, 6],
              [7, 8, 9],
              [10, 11, 12],
              [13, 14, 15]])
print("原始矩阵 A:")
print(A)

# 进行 SVD 分解
U, sigma, Vt = np.linalg.svd(A, full_matrices=False)
print("\n奇异值 sigma:")
print(sigma)

# 保留前 k=1 个奇异值进行降维
k = 1
U_k = U[:, :k]  # 取 U 的前 k 列,因为要保持行数不变
sigma_k = sigma[:k]  # 取前 k 个奇异值
Vt_k = Vt[:k, :]  # 取 Vt 的前 k 行,因为要保持列数不变

# 近似重构矩阵 A,常用于信号or图像筛除噪声
A_approx = U_k @ np.diag(sigma_k) @ Vt_k
print("\n保留前", k, "个奇异值后的近似矩阵 A_approx:")
print(A_approx)

# 计算近似误差
error = np.linalg.norm(A - A_approx, 'fro') / np.linalg.norm(A, 'fro')
print("\n近似误差 (Frobenius 范数相对误差):", error)
作业:使用SVD处理心脏病数据集
在机器学习中,如果对训练集进行 SVD 降维后训练模型,而测试集的特征数量与降维后的训练集不一致(测试集仍保持原始特征数量),该如何处理?
降维(如 SVD、PCA 等)是一种数据预处理步骤。训练集和测试集必须经过相同的变换(映射规则):
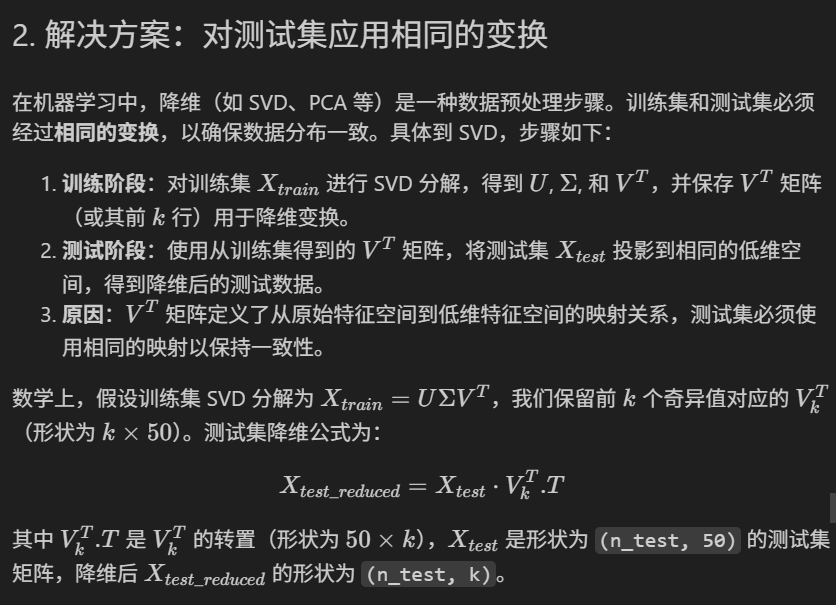
下面是对心脏数据集进行SVD降维后,训练模型,并对测试集应用相同降维变换:
python
import pandas as pd
import numpy as np

#读取数据
data = pd.read_csv(r'heart.csv')
data.head() #读取前5行

#对于多分类特征进行独热编码
continous_features = ['age','trestbps','chol','thalach','oldpeak']
discrete_features = ['sex','cp','fbs','restecg','exang','slope','thal']
multi_features = ['cp','restecg','slope','thal']
data = pd.get_dummies(data=data,columns=multi_features,prefix=multi_features) #返回的是新的dataframe+编码列
data.head()

from sklearn.model_selection import train_test_split
X = data.drop(['target'],axis=1)
y = data['target']
X_train,X_test,y_train,y_test = train_test_split(X,y,train_size=0.8,random_state=42)
#对连续特征进行标准化
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
X_train = scaler.fit_transform(X_train)
X_test = scaler.transform(X_test)

#训练
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
import warnings
warnings.filterwarnings('ignore')
log = LogisticRegression(random_state=42)
log.fit(X=X_train,y=y_train)
log_pred = log.predict(X_test)

# 预测并评估
accuracy = accuracy_score(y_test, log_pred)
print(f"测试集准确率: {accuracy:.4f}")
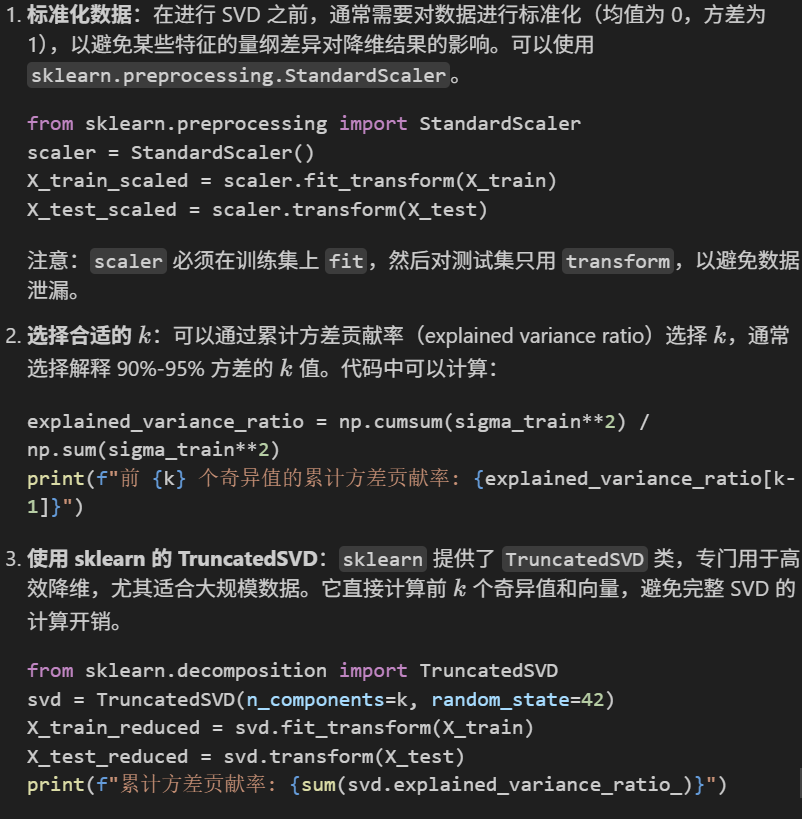
python
np.random.seed(42)
#奇异值处理
U_train,sigma_train,Vt_train = np.linalg.svd(X_train,full_matrices=False)
print('Vt 矩阵的形状:{}'.format(Vt_train.shape))
#降维
k = 10
Vt_k = Vt_train[:k,:] #取Vt矩阵中前k行
print('降维后的 Vt 矩阵的形状:{}'.format(Vt_k.shape))
#转换
X_train_svd = X_train @ Vt_k.T
X_test_svd = X_test @ Vt_k.T
print('X_train_svd形状:{}'.format(X_train_svd.shape))
print('X_train_svd形状:{}'.format(X_test_svd.shape))

#训练
from sklearn.linear_model import LogisticRegression
import warnings
warnings.filterwarnings('ignore')
log_svd = LogisticRegression(random_state=42)
log_svd.fit(X=X_train_svd,y=y_train)
log_pred_svd = log_svd.predict(X_test_svd)

# 预测并评估
accuracy = accuracy_score(y_test, log_pred_svd)
print(f"测试集准确率: {accuracy:.4f}")
#累积方差贡献率,通常选择解释 90%-95% 方差的k值
explained_variance_ratio = np.cumsum(sigma_train**2) / np.sum(sigma_train**2)
print(f"前 {k} 个奇异值的累计方差贡献率: {explained_variance_ratio[k-1]:.3f}")

# 计算训练集的近似误差(可选,仅用于评估降维效果)
X_train_approx = U_train[:, :k] @ np.diag(sigma_train[:k]) @ Vt_k
error = np.linalg.norm(X_train - X_train_approx, 'fro') / np.linalg.norm(X_train, 'fro')
print(f"训练集近似误差 (Frobenius 范数相对误差): {error:.4f}")
SVD前,准确率为0.8852;SVD后,准确率为0.8525。可能跟k值有关
最后是注意事项: