当你看到这样一个新闻:
"A 实验室/公司喜报:A使用某开源基座模型Q,经过后训练得到模型Q',Q'在数学编程领域的得分超过Q。"
请思考这样的模型会有什么问题,Q'真的超过了Q吗?学习本节课,你将得到答案
目录
[1. 经典经验回放](#1. 经典经验回放)
[2. 伪经验回放](#2. 伪经验回放)
[3. Self-Output 系列方法](#3. Self-Output 系列方法)
[4. 巧妙的解法:过滤高难度Token](#4. 巧妙的解法:过滤高难度Token)
一、后训练(Post-training)是什么?
后训练目标:将通用的"基础模型"变成特定任务或领域的"专才模型"。(如把Llama后训练后,变成金融、法律领域的专有模型)
后训练仍然沿用现有的模型训练范式:
- 预训练式:继续做文字接龙,使用领域文本。
- 有监督微调式:使用"指令-回答"对训练。
- 强化学习式:通过人类反馈优化模型。
二、后训练的核心挑战------灾难性遗忘
"手术成功,但病人死亡"------模型学会了特定的新东西,但是原有的通用知识记忆严重衰退,甚至完全丧失原有能力。
典型案例:
1、学中文,忘安全
* 基座模型:LLaMA-2-Chat只用英文回答问题,问它危险问题LLaMA-2会拒绝回答
* 用中文后训练之后:LLaMA-2会用中文回答问题,但安全对齐被破坏,开始回答危险问题。
2、即使用无害数据微调,模型的安全能力也会下降。1
3、专才代价是通才能力下降
* 提升某一能力(如编程),其他能力(如数学、语文)下降。
4、学新模态,忘旧格式
- 通过后训练,想教纯文本语言模型LLaMA识别语音
- 第一个Epoch:要求语言模型输出语音的情绪,并要求用json格式输出,模型输出错误的情绪,但是会用json格式输出结果(因为LLaMA知道什么是json)
- 多轮Epoch后:能输出正确的情绪,但模型忘记了如何输出JSON格式。
三、遗忘的根源
那么为什么模型会发生灾难性遗忘?原因如下
- 单目标优化:训练只优化新任务,不保护旧知识。
- 知识覆盖:新任务参数覆盖旧任务参数。
- 模型大小无关:研究1B-7B参数的模型,大小与遗忘程度无显著相关。而模型学的新知识越多,旧知识就遗忘得越厉害。
- LoRA 不能根本解决:只是"学得少,忘得少"。
四、解决方案:让AI用自己的话学习
1. 经典经验回放
- 在训练新任务时,混入5%旧任务数据,可有效防止遗忘。
- 问题:商业模型原始训练数据不可获取。
2. 伪经验回放
目前商业开源大模型的训练资料不可取,那就让模型自己生成旧任务数据,作为回放材料。
- 虽可能有事实错误,但能保留模型风格与知识结构。
3. Self-Output 系列方法
- Mega-Pie:让模型自问自答,生成SFT数据。
- Paraphrase答案改写:用模型自己改写后的答案训练。
- self-output 选择性自我排练:模型答对时,用自己的答案训练;答错时才用人类答案。(这种方式跟RL-based的post-training很像)
- "说我的语言":用LLM生成的答案教另一个LLM,比只用人类数据集的效果更好。2
4. 巧妙的解法:过滤高难度Token
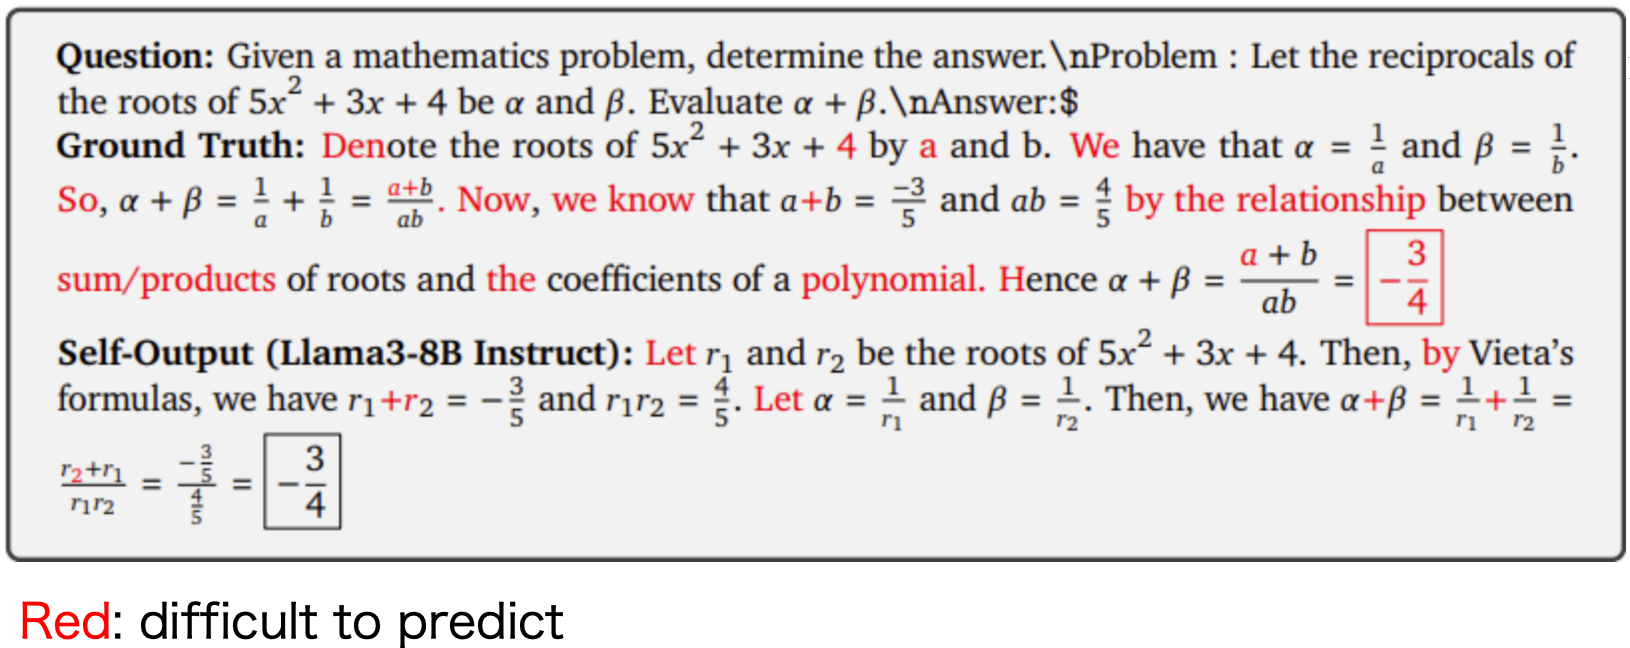
人类写的数据,总有一些词汇是模型输出的过程中,模型很难学到的(如截图)。那么在训练中忽略模型最难预测的Token,避免强制教学。可提升泛化能力,减少遗忘。3
五、结论与建议
- 遗忘不可避免:后训练本质是单目标优化,会干扰旧知识。
- 安全与通用能力最易丢失。
- 最有效策略:让模型用自己的话学习,保持训练目标与自身分布一致。
- 警示:看到某个模型说自己通过后训练,某个专项能力吊打xx模型,需要警惕,它可能失去了很多通用能力。
1Fine-tuning Aligned Language Models Compromises Safety, Even When Users Do Not Intend To!