引言
之前有朋友向我吐槽:试了不少PDF转Word的工具,找不到一款好用的。
我听完觉得很诧异,这类普遍需求应该早已被人解决了才对,但经过调研分析,发现现有的PDF转Word的工具普遍存在两个问题:
- 复杂图像一致性无法保持:比如一张大图上有不同元素,转成Word之后会将不同元素切分成小图,而不是保留完整的大图。
- 数学公式格式异常:PDF中的数学公式往往会被转成文本格式,一些复杂符号无法被正确渲染。
于是,我做了 FreeP2W 这个 CLI 工具,致力于解决以上两个问题。
项目开源地址:https://github.com/zstar1003/FreeP2W
现有工具对比
在此节中,对比 FreeP2W 和现有的PDF转Word工具的局部效果,主要包含以下工具:
- PDF阅读器:Adobe DC
- 在线网站:ilovepdf/smartpdf
- 先解析成Markdown再转成Docx的网站:Doc2X
- 开源CLI方案:pdf2word
先对比复杂图像的转换效果:
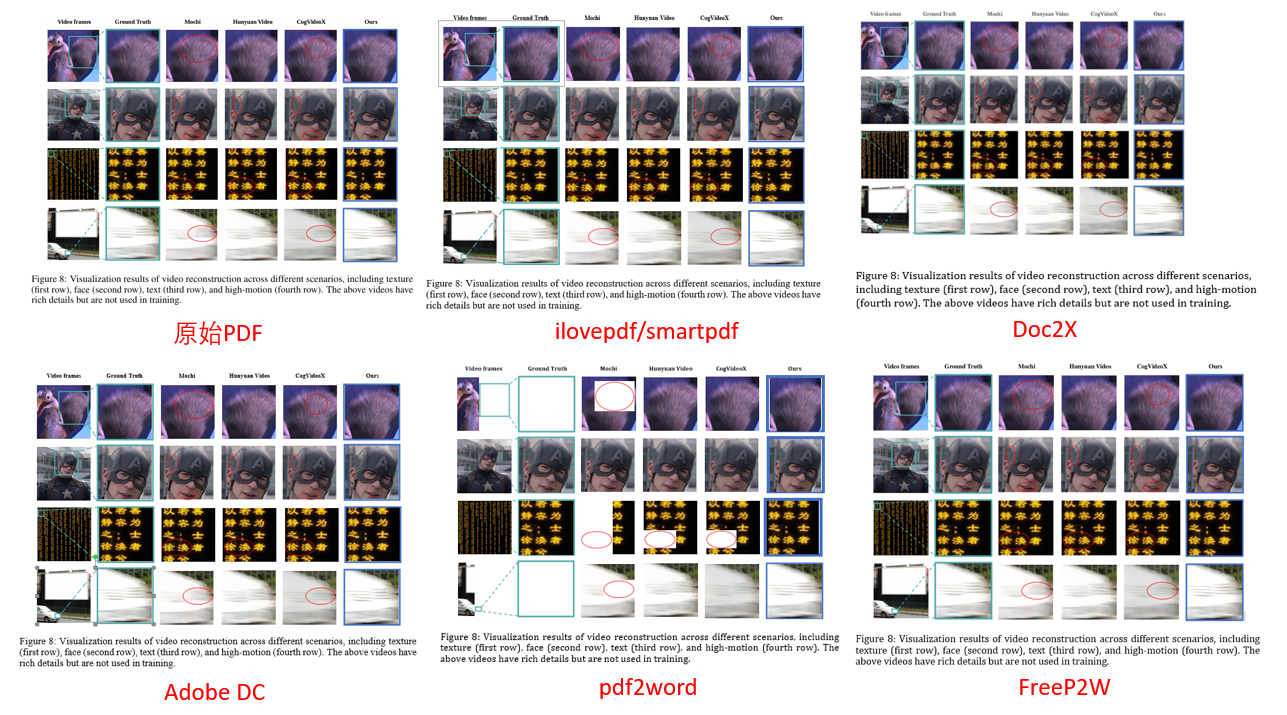
由图可见,ilovepdf/smartpdf/Adobe DC 虽然能够把这类图像大致转换出来,但无法选中大图,大图被错误得切割成了每个小图。
Doc2X 虽然保留了完整的大图,但由于 Markdown 格式丢失了结构信息,导致图和文本的位置关系存在偏差。
pdf2word 更是错误地将图中的SVG元素提取出来,并错误处理了层级关系,导致图片完全不可用。
只有 FreeP2W 既保留了大图的效果,又准确地还原了图文的结构位置信息。
下面再对比包含数学公式的情况:
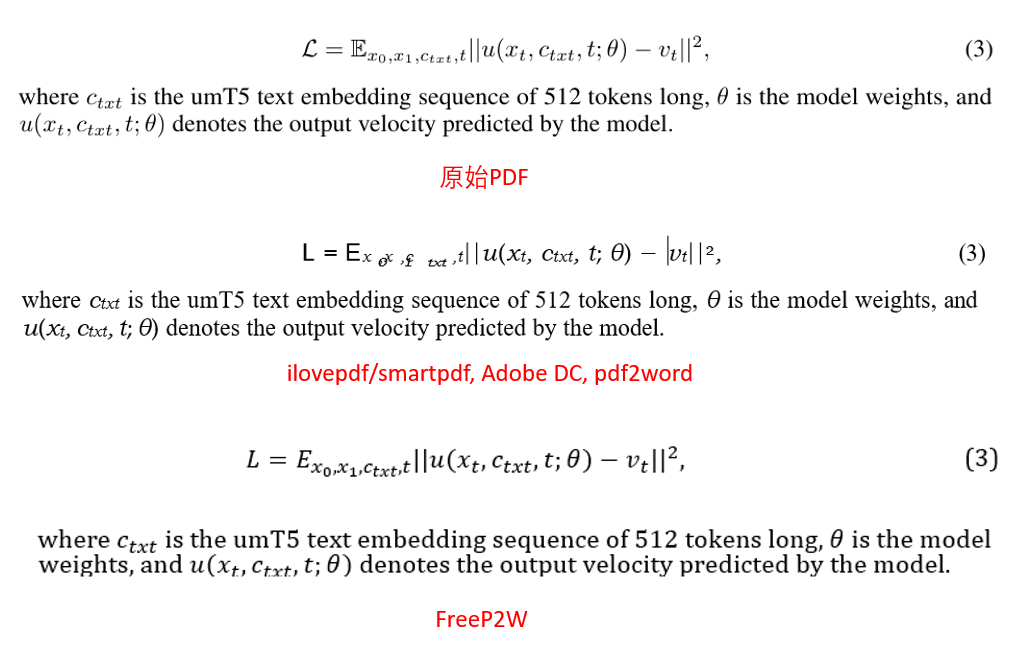
ilovepdf/smartpdf/Adobe DC/pdf2word 均将原有的PDF数学公式,变成文本形式,导致符号发生错位。
而 FreeP2W 保留了 Word 原生支持的 MathML 格式,不仅能准确渲染,而且支持用 Word 自带的公式功能,进行二次编辑。
工作原理
FreeP2W 是如何解决现有工具存在的这两个问题的?主要解决思路如下:
- 文档分析 : 使用 DocLayout-YOLO 检测 PDF 中的布局元素(文本、图片、公式、表格)
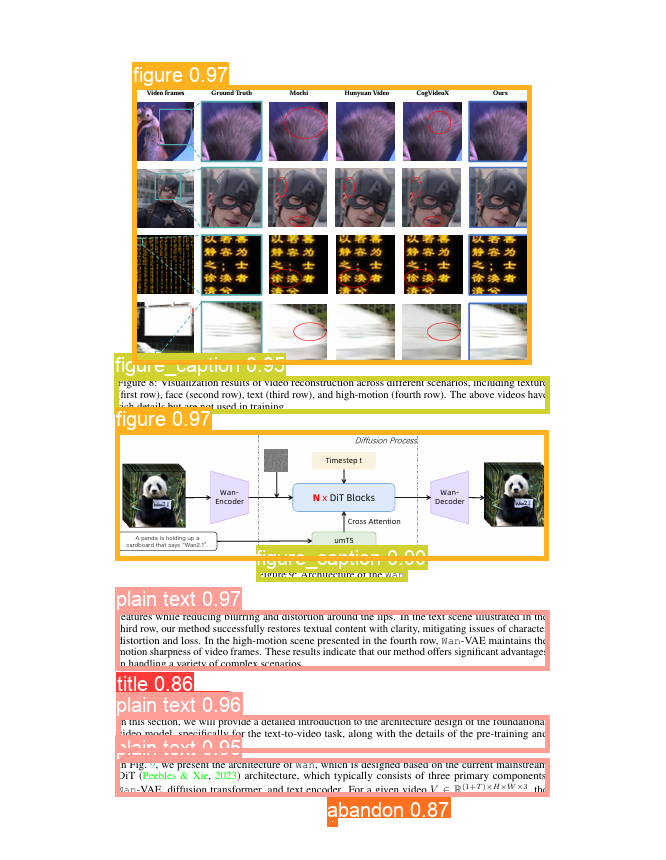
- 公式识别: 对检测到的公式区域使用 UniMERNet 进行识别并转换为 MathML
- 内容提取: 使用 pdf2docx 提取文本、表格等内容
- 文档合成: 将所有识别结果合并生成最终的 DOCX 文件
使用方式
安装
方式 1: 使用 uv 进行安装
bash
uv add freep2w方式 2: 从 PyPI 安装
bash
pip install freep2w方式 3: 从源码安装
bash
# 克隆仓库
git clone https://github.com/zstar1003/FreeP2W.git
cd FreeP2W

# 安装依赖
pip install -e .
首次运行
首次运行时,FreeP2W 会自动下载所需的模型文件:
- YOLO 模型 (~39 MB): 文档布局检测模型
- UniMERNet 模型 (~1.6 GB): 数学公式识别模型
模型文件会被下载到用户目录:
- Windows:
C:\Users\<用户名>\.freep2w\weights\ - Linux/Mac:
~/.freep2w/weights/
使用方法
基本用法
bash
# 转换 PDF 文件(输出文件名自动生成)
freep2w input.pdf

# 指定输出文件名
freep2w input.pdf -o output.docx

# 完整路径示例
freep2w /path/to/input.pdf -o /path/to/output.docx
支持参数
freep2w [-h] [-o OUTPUT] [-v] input

位置参数:
  input                 输入 PDF 文件路径

可选参数:
  -h, --help            显示帮助信息
  -o OUTPUT, --output OUTPUT
                        输出 DOCX 文件路径(可选)
  -v, --version         显示版本号
Python API
python
from freep2w.cli import convert_pdf_to_docx

# 转换 PDF 文件
success = convert_pdf_to_docx(
    pdf_path='input.pdf',
    output_path='output.docx'
)

if success:
    print("转换成功!")
else:
    print("转换失败!")
局限性
虽然 FreeP2W 有效解决了现有 PDF转Word 方案存在的两个缺陷,但相比于其它闭源方案,正文字体的一致性和布局格式仍有提升空间,欢迎对此感兴趣的同仁研究贡献。