动手学强化学习 第6章 Dyna-Q 算法

第六章

重点:

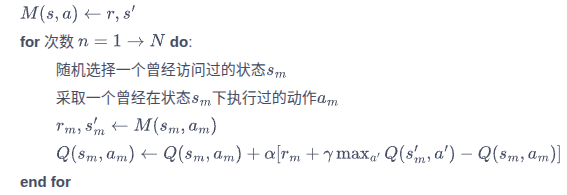
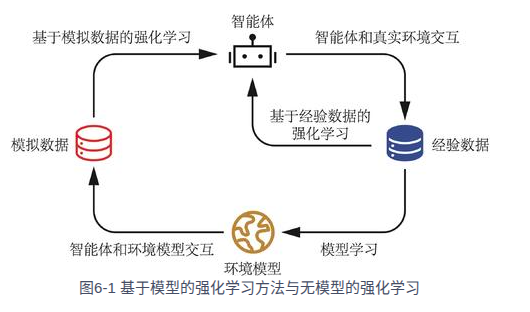
提出了有模型算法和无模型算法。

强化学习算法有两个重要的评价指标:一个是算法收敛后的策略在初始状态下的期望回报,另一个是样本复杂度,即算法达到收敛结果需要在真实环境中采样的样本数量。
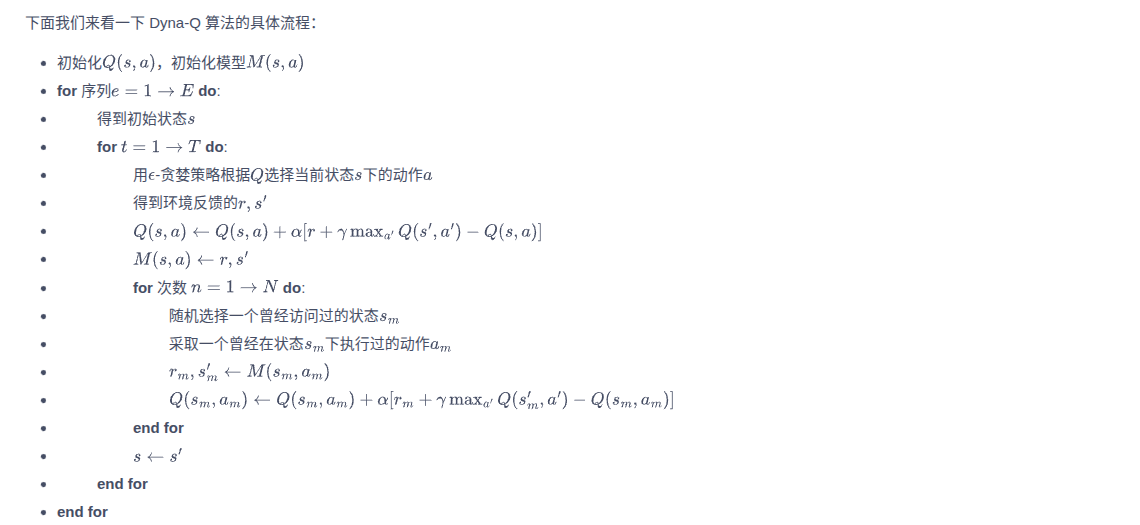
核心的改动应该是指这个,利用模型去(学习or记录)一个占用度量对应的奖励和下一状态,然后使用它去更状态新价值函数,从代码上看也是做了类似的工作。
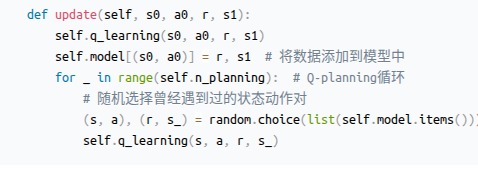
Q-planning可以有效加速收敛。

有必要反问一下这么做的动机是什么?

口胡一下,即为什么要在现在去做随机更新价值的这个动作:占用度量的状态价值函数的定义是当前状态到未来最终状态的累积懊悔(指负回报),而在前期更新状态价值函数时,对下一状态初始化其实都是0,没有形成传递链。只有随着迭代的深入,传递链才会被慢慢建立起来,而Q_learning做的工作实际上就是在加速传递链的建立。

问了GPT他也是认同的:

Q-learning / Q-planning 的目标是加速 Bellman 信号的传播,从而更快地建立起状态之间的价值传递链。

相关推荐
地平线开发者18 分钟前
点云算法整理与常用计算模块:从数据到模型,再到工程与量化
算法·自动驾驶
武子康2 小时前
H3-World 为何在加载 LoRA 前,先检查导入的代码?
人工智能·深度学习·算法
秋天的怀念_David3 小时前
算法一千零一夜 · 第二十八夜 注册
java·程序人生·算法
NEFU_Jyj5 小时前
贝尔数(组合数学)
算法
希和20276 小时前
C语言程序设计题|有序数组插入数字冒泡排序
c语言·数据结构·算法
Pniubi6 小时前
力扣73 矩阵置零
算法·leetcode·矩阵
布莱克60516 小时前
C++ 中 map 的 insert 与 emplace:key 已存在时会覆盖吗?
开发语言·数据结构·c++·算法·map
D e re k ZH19 小时前
C++ 系统学习手记:从语法细节到工程实践
开发语言·数据结构·c++·算法
石小石Orz20 小时前
AI 正在蚕食我们的编码能力
前端·后端·算法